pirvn-products
收藏资源简介:
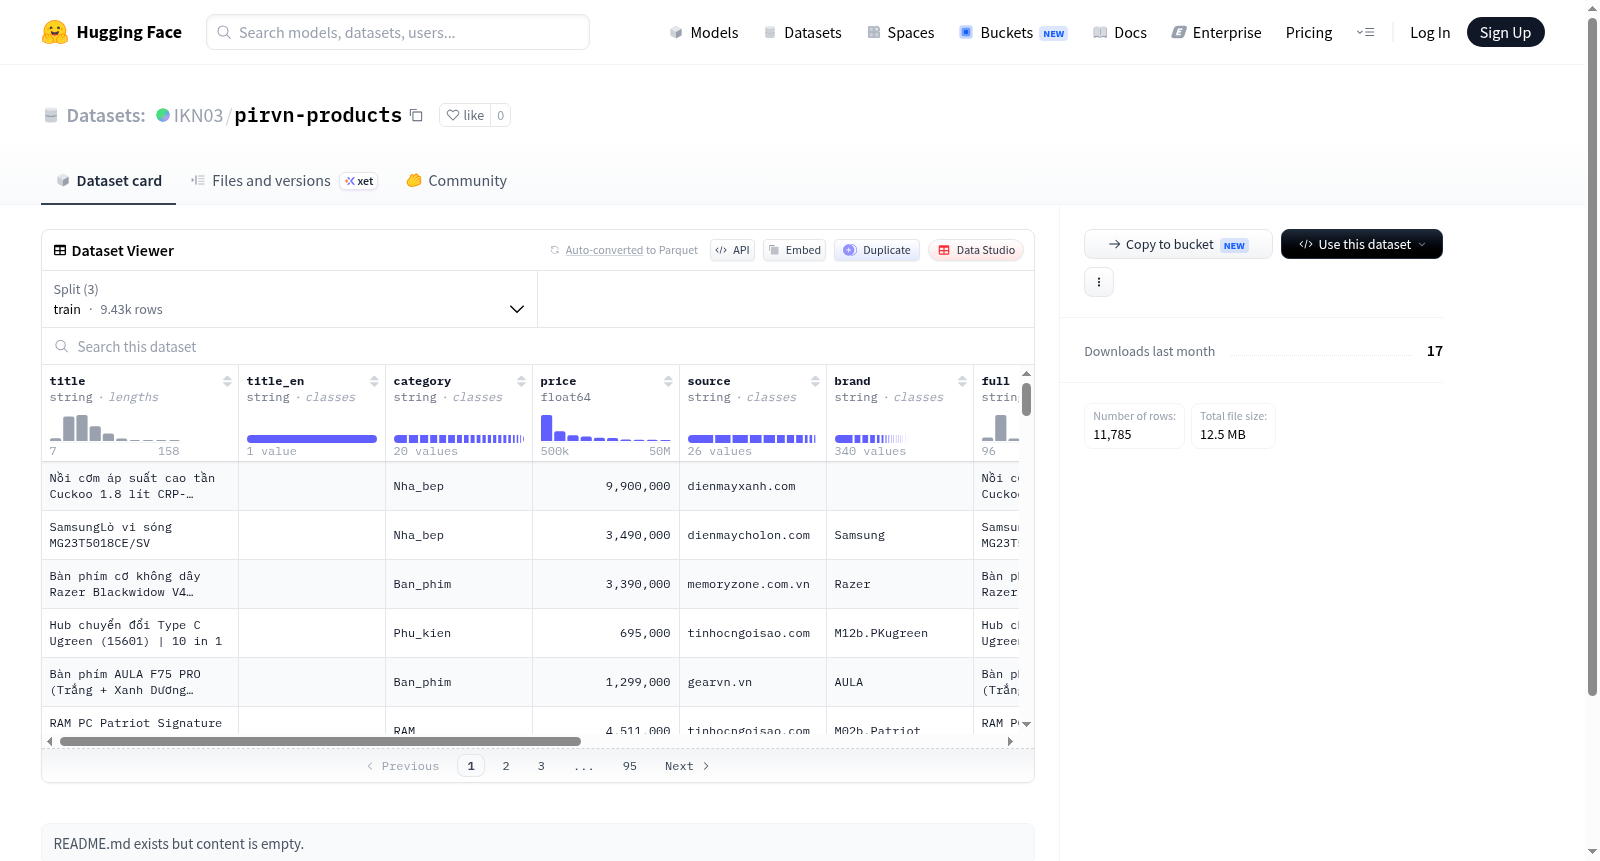
该数据集是一个多语言商品信息数据集,包含商品标题、类别、价格、品牌、规格等结构化字段。数据规模方面,总计包含 11,785 条样本,划分为训练集(9,428 条)、验证集(589 条)和测试集(1,768 条),总数据量约为 26.99 MB。数据集特征包括:商品标题(中文和英文)、商品类别、价格(浮点数)、数据来源、品牌、完整描述、重量、规格说明、提示词文本以及唯一ID。基于其结构化多语言文本和商品属性字段,该数据集可能适用于多语言文本生成、信息抽取、商品分类或电商领域的自然语言处理任务。
This dataset is a multilingual product information dataset comprising structured fields including product titles, categories, prices, brands, specifications, and more. In terms of data scale, it contains a total of 11,785 samples, split into a training set (9,428 samples), a validation set (589 samples), and a test set (1,768 samples), with an overall data volume of approximately 26.99 MB. The dataset features include: product titles in both Chinese and English, product categories, floating-point price values, data sources, brands, full product descriptions, weights, specification descriptions, prompt texts, and unique IDs. Leveraging its structured multilingual text and product attribute fields, this dataset may be applicable to natural language processing tasks such as multilingual text generation, information extraction, product classification, or e-commerce-related scenarios.
数据集概览:IKN03/pirvn-products
该数据集是一个商品信息数据集,包含商品标题、分类、价格、品牌、规格等详细字段,适用于商品描述生成、分类等任务。
主要特征
该数据集包含以下11个字段:
- title (字符串): 商品标题。
- title_en (字符串): 商品的英文标题。
- category (字符串): 商品类别。
- price (浮点数): 商品价格。
- source (字符串): 数据来源。
- brand (字符串): 商品品牌。
- full (字符串): 商品完整描述。
- weight (浮点数): 商品重量。
- specs (字符串): 商品规格。
- prompt (字符串): 提示词,可能用于模型输入。
- id (整数): 商品唯一标识符。
数据集规模
- 总大小:26,990,381 字节
- 下载大小:12,464,739 字节
- 总样本数:11,785 条
数据划分
数据集被分为三个子集:
- 训练集 (train): 9,428 条样本,占数据集的绝大部分。
- 验证集 (validation): 589 条样本。
- 测试集 (test): 1,768 条样本。
配置与文件
- 配置名称:
default - 数据文件路径:
data/train-*、data/validation-*、data/test-*。这些文件位于该数据集仓库的根目录下。