
遇见数据集

agents-last-exam/agents-last-exam

收藏
Hugging Face2026-06-12 更新2026-06-14 收录
官方服务:

资源简介:

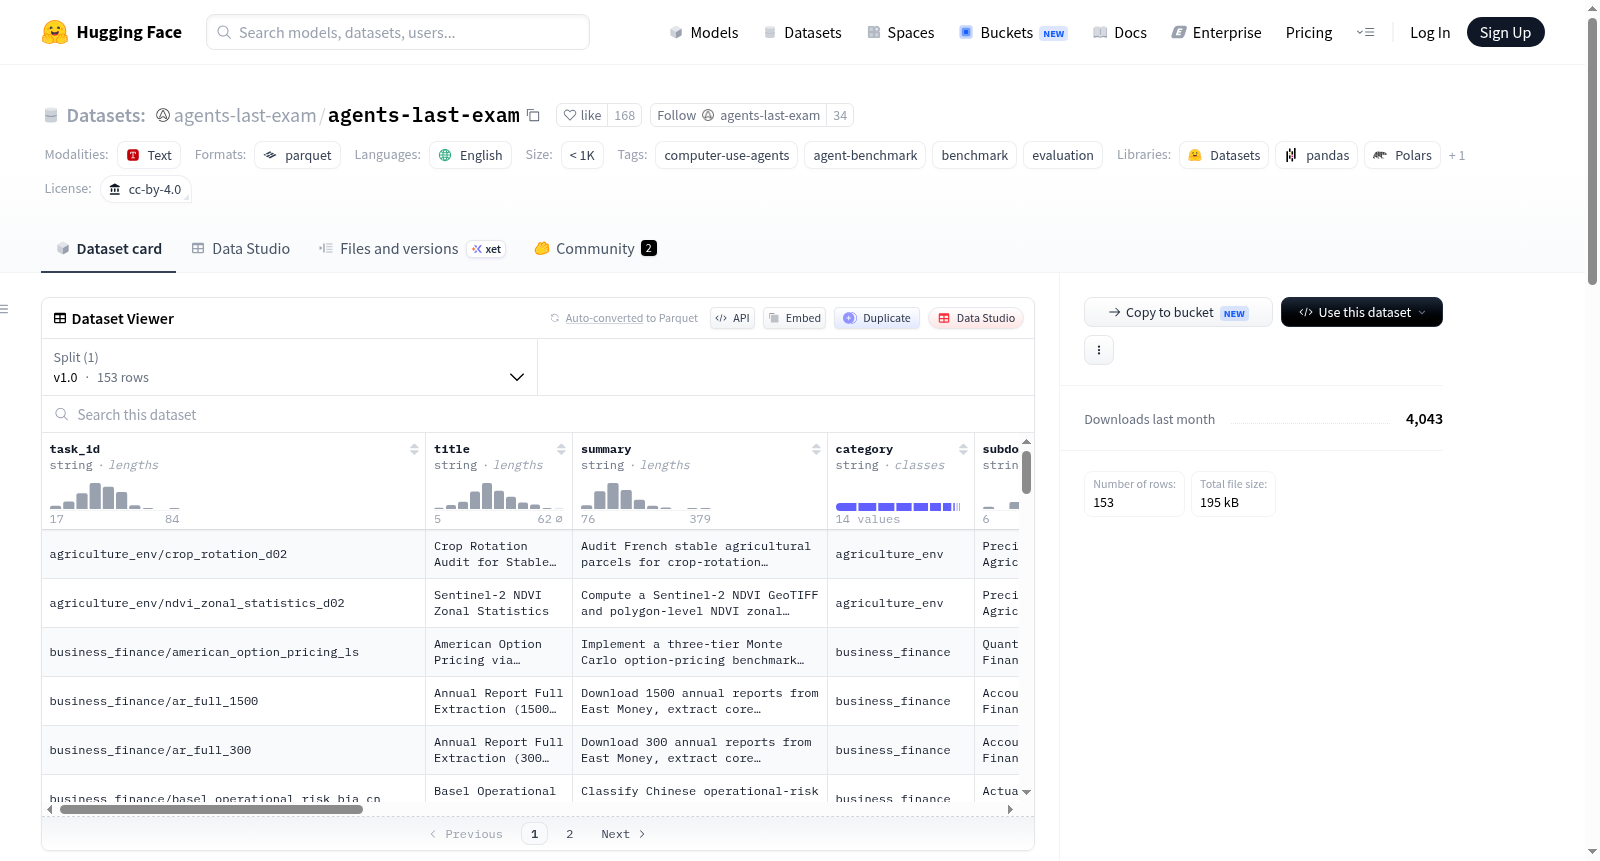
Agents Last Exam — Task Card Metadata(v1.0)是一个元数据版本的数据集,包含来自Agents Last Exam(ALE)基准的153个任务,用于评估计算机使用代理在长期专业工作上的性能。该数据集仅提供任务卡(每任务一行),包括任务标题、提示、分类和输入文件描述符等元数据,但不包含输入数据、软件二进制文件、参考输出或VM镜像。数据集旨在支持对代理在商业金融、健康医学等多个领域的任务进行浏览、过滤和搜索。

Agents Last Exam — Task Card Metadata (v1.0) is a metadata-oriented dataset that includes 153 tasks sourced from the Agents Last Exam (ALE) benchmark, which is used to evaluate the performance of computer-using agents in long-term professional work. This dataset only provides task cards (one row per task), including metadata such as task titles, prompts, categories, and input file descriptors, while excluding input data, software binaries, reference outputs, and VM images. The dataset is designed to support browsing, filtering, and searching of tasks across multiple domains including business and finance, healthcare and medicine.
提供机构:
agents-last-exam
搜集汇总
数据集介绍
agents-last-exam/agents-last-exam 数据集图片
构建方式
Agents Last Exam(ALE)基准测试集由153项专业任务构成,旨在评估计算机使用代理在长周期专业工作中的表现。该数据集以任务卡元数据的形式发布,每项任务对应一组结构化描述信息,涵盖任务标识符、标题、摘要、领域分类、指令提示、必备操作清单、所需软件环境及输入文件描述符等核心字段。任务按领域分为商业金融、健康医疗等顶级类别,并进一步细分为子领域,同时依据时间跨度划分为近期、终极考试与全频谱三个子集,构建了一套层次分明、覆盖广泛的评估框架。
特点
该数据集的核心特点在于其元数据驱动的开放性与可扩展性。任务卡仅提供任务定义与约束条件,不包含任何输入数据、软件二进制文件或参考输出,这既保障了基准测试的公平性,又允许研究者灵活配置运行环境。数据集与另外两个互补仓库(任务输入数据仓库与参考数据仓库)协同工作,其中参考数据需经审批访问,有效防止了数据泄露。此外,丰富的字段设计如必备操作清单与输入文件描述符,为自动化评估提供了精确的评分依据。
使用方法
使用该数据集时,研究者首先通过HuggingFace数据集查看器浏览、过滤和搜索任务卡表格,获取任务定义与指令。随后,需从配套的任务输入数据仓库中获取每个任务在运行开始时提供给代理的输入文件,并从需审批的参考数据仓库中获取用于评分的标准输出。实际评估还需结合源代码仓库中的运行脚本、评分工具及虚拟机镜像,构建完整的测试环境。数据集设计支持分阶段使用,例如先利用‘近期’子集进行快速验证,再迁移至更具挑战性的‘终极考试’子集。
背景与挑战
背景概述
随着大型语言模型与多模态系统的飞速演进,构建能够自主执行长期、复杂专业任务的计算机使用智能体(computer-use agent)已成为人工智能前沿研究的重要方向。在此背景下,加州大学伯克利分校的研究团队于近期推出了Agents Last Exam(ALE)基准数据集,旨在系统评估智能体在真实专业工作场景中的长程任务完成能力。该数据集由153项精心设计的任务组成,覆盖商业金融、健康医疗等多个专业领域,通过提供标准化的任务卡元数据、输入文件及受控的参考数据,为研究者提供了严谨的评估框架。ALE的发布填补了现有基准在专业深度与任务时长方面的空白,有望推动智能体研究从简单指令执行向复杂职业工作流自动化迈进。
当前挑战
ALE数据集所面临的挑战首先体现在领域问题的复杂性上:现有基准多聚焦于简短指令或单一操作,而ALE要求智能体在长时间跨度内协调多个子任务、适应动态软件环境并生成可验证的成果,这对模型的记忆、规划与环境交互能力提出了极高要求。在构建过程中,团队需应对任务真实性与评估可复现性之间的平衡难题,例如为每个任务精心设计输入文件与参考输出,同时避免数据泄露以维持基准的独立性。此外,任务覆盖广泛的专业领域,确保领域知识的准确性与任务难度的梯度分布亦是一大挑战,而开放元数据但限制参考数据的访问策略则旨在防范过拟合风险,维护评估的公正性。
常用场景
经典使用场景
Agents Last Exam(ALE)数据集专为评估计算机使用智能体(computer-use agents)在长周期专业任务中的性能而设计。该数据集包含153个精心构建的任务,覆盖商业金融、医疗健康等多元领域,每个任务都要求智能体在模拟的专业环境中完成复杂的、多步骤的操作流程。研究者通过向智能体提供初始输入文件与任务提示,观察其能否自主规划、调用软件工具并逐步推进工作,最终依据预设的参考输出进行自动化评分。这一场景成为了衡量大型语言模型驱动下智能体系统在实际工作中可靠性与泛化能力的关键基准。
衍生相关工作
基于ALE数据集的框架,研究社区已衍生出多项经典工作。首先,配套发布的Task Input Data与Reference Data仓库为构建完整的评测流水线奠定了基础,许多团队在此基础上开发了自动化的任务评分与日志分析工具。其次,数据集的分类体系与任务模板被广泛借鉴,催生了诸如医疗诊断场景专用评测集、金融交易模拟测试等专业化衍生版本。此外,围绕ALE的高难度任务,研究者设计了一系列旨在提升智能体长程推理与错误恢复能力的强化学习算法和记忆增强架构,这些工作反过来又推动了智能体基础模型在工具使用与自主规划方面的技术迭代,形成了良性发展的研究生态。
数据集最近研究
最新研究方向
Agent Last Exam(ALE)数据集代表了计算机使用智能体(computer-use agents)评估领域的前沿成果,聚焦于长周期专业任务的基准测试。当前研究方向围绕多模态智能体在复杂工作流中的自主决策能力验证,涵盖金融、医疗等垂直领域的实际应用场景。该数据集通过结构化任务卡片、输入文件与参考输出三部分协同设计,为衡量大语言模型驱动的智能体在端到端任务执行中的鲁棒性与效率提供了标准化框架。其发布恰逢生成式AI从对话交互向工具操作范式转型的关键节点,对推动智能体在真实业务环境中的部署具有里程碑意义,尤其为学术界与工业界在可复现性评估、任务分解策略及人机协作模式探索上奠定了数据基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

