
JGTV_Pref_DS
收藏官方服务:
资源简介:
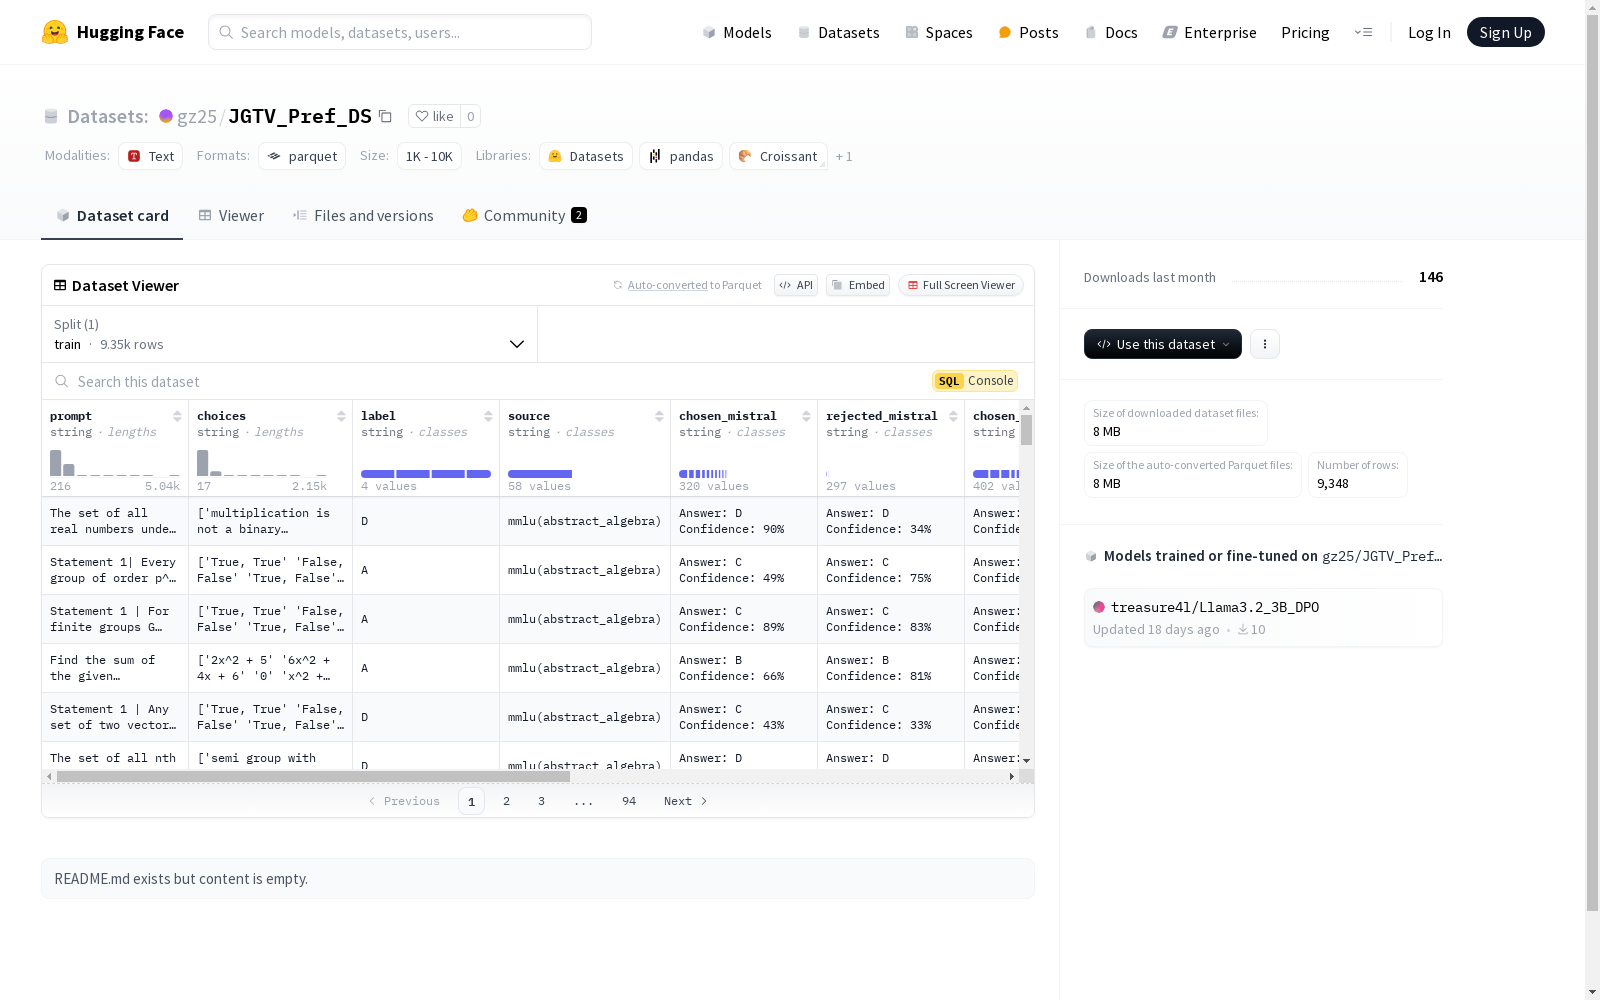
该数据集包含多个特征字段,如prompt(提示)、choices(选择)、label(标签)、source(来源)等,以及不同模型(如mistral、gemma、llama)的偏好和拒绝输出。数据集分为训练集,包含9348个样本,总大小为28685328字节。
This dataset includes multiple feature fields such as prompt, choices, label, source, etc., as well as preference and rejection outputs from various models including Mistral, Gemma, and LLaMA. The dataset is split into a training set, which contains 9348 samples with a total size of 28,685,328 bytes.
创建时间:
2025-01-23
搜集汇总
数据集介绍
构建方式
JGTV_Pref_DS数据集的构建,涉及从多个来源收集用户偏好的文本数据,包括提示文本(prompt)、选项文本(choices)以及用户选择的标签(label)。数据集进一步包含了各种模型生成的文本,如mistral、gemma和llama模型产生的文本,以及对应的被选中或拒绝的文本记录。此外,还包含了用于模型处理所需的input_ids和attention_mask字段。整个数据集分为训练集(train)等部分,构建过程中确保了数据格式的统一和多样性的平衡。
特点
该数据集的特点在于其多维度的用户偏好数据,不仅涵盖用户的选择标签,还包括用户对不同模型生成文本的偏好。数据集具有丰富的字段,能够支持对用户偏好的深入分析以及模型生成能力的评估。此外,数据集的规模适中,便于研究者进行有效的研究与实验,同时保证了训练的效率和效果。
使用方法
使用JGTV_Pref_DS数据集时,用户可根据需求选择适当的字段进行训练或分析。数据集的默认配置提供了训练集,用户可以直接加载此部分进行模型训练或评估。针对特定任务,用户可能需要预处理数据,例如对文本字段进行编码转换为模型可接受的input_ids和attention_mask格式。同时,数据集的开放性也允许用户根据需要整合其他数据源或进行扩展。
背景与挑战
背景概述
JGTV_Pref_DS数据集是在机器学习领域中,针对偏好学习任务而构建的。该数据集由多个研究机构共同研发,旨在解决智能推荐系统中用户偏好识别的问题。自创建以来,该数据集便因其全面的数据特性和精准的用户偏好标签而受到学术界的广泛关注,为用户偏好识别、推荐算法优化等研究领域提供了重要的实验基础。
当前挑战
在构建JGTV_Pref_DS数据集的过程中,研究人员面临着多方面的挑战。首先,如何准确捕捉并表达用户的复杂偏好是一个重大挑战。其次,数据集的多样性和平衡性在构建过程中亦难以把握,这对于模型的泛化能力至关重要。此外,数据集在标注过程中可能出现的主观偏差和标注一致性也是必须解决的问题。在领域问题方面,数据集需解决如何有效利用用户的历史行为数据来预测用户对新项目的偏好这一挑战。
常用场景
经典使用场景
在自然语言处理的研究领域,JGTV_Pref_DS数据集以其独特的多模态偏好标注特性,成为评价不同预训练语言模型表现的重要资源。该数据集通过提供用户对三种不同模型生成的文本的偏好选择,为模型性能的对比分析提供了直接的实证基础。
解决学术问题
JGTV_Pref_DS数据集解决了模型评估中缺乏直观用户偏好数据的问题,它允许研究者根据用户的实际选择来分析不同预训练语言模型的优缺点,进而指导模型的改进和优化,对提升模型的人性化和实用性有着重要意义。
衍生相关工作
基于JGTV_Pref_DS数据集的研究,已经衍生出一系列相关工作,包括但不限于对多模态偏好学习的深入探索,对不同预训练模型在多任务上的表现评估,以及基于用户偏好进行模型微调的策略研究。
以上内容由遇见数据集搜集并总结生成


