Nima0Kamali/humancentric-scenes-ai
收藏资源简介:
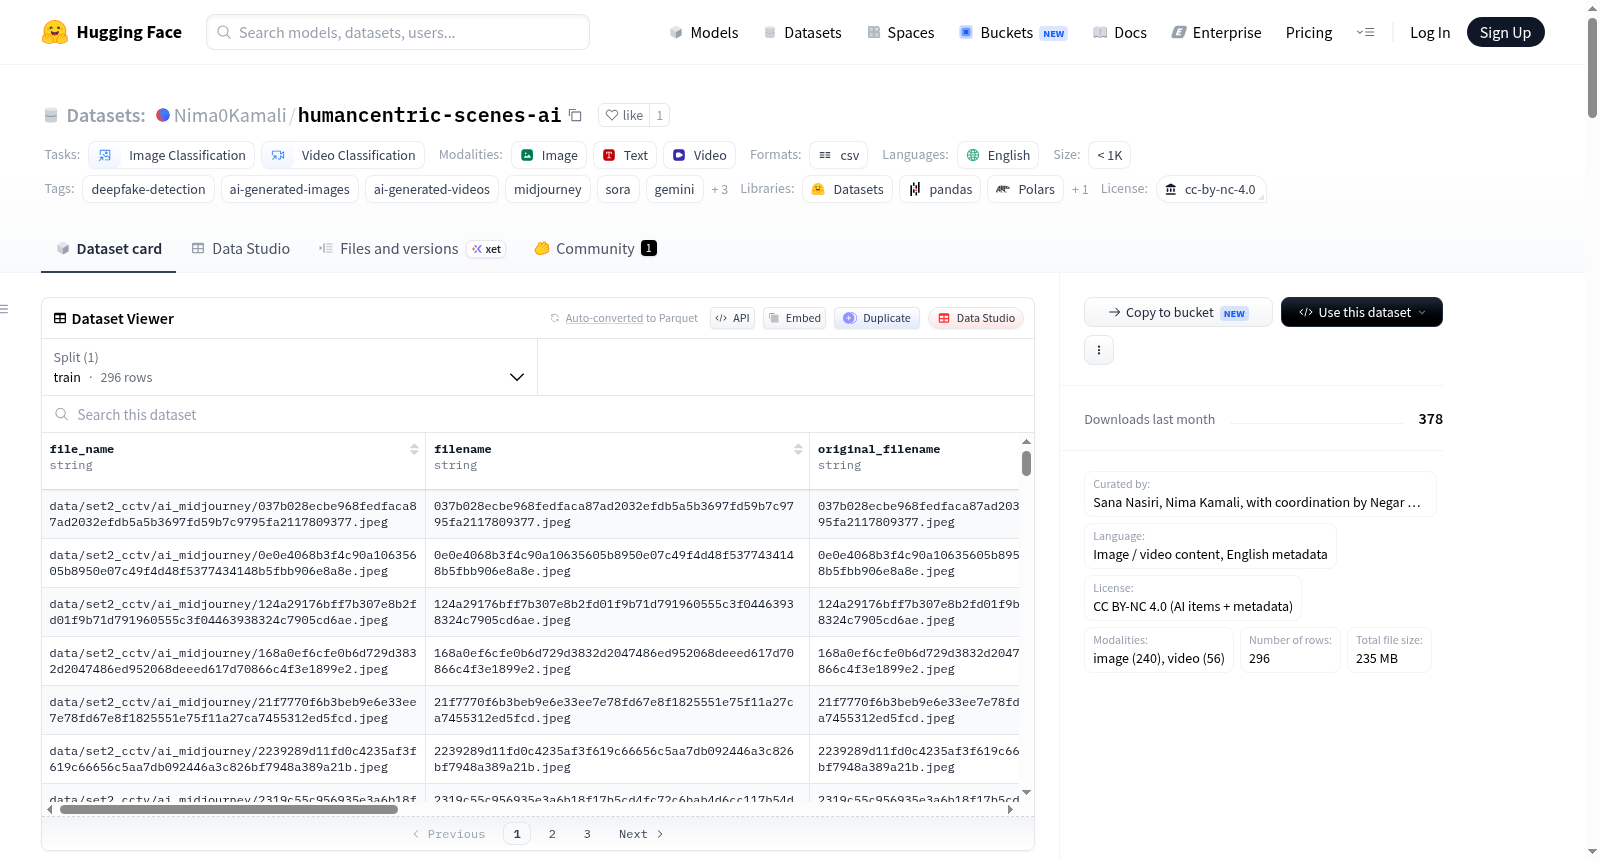
HumanCentric-Scenes-AI是一个多模态基准数据集,包含296个AI生成的人类中心场景,覆盖四个领域:CCTV/监控图像(85张Midjourney生成的静态图像,模拟低分辨率安全摄像头画面)、职业×性别肖像(128张Midjourney生成的图像,采用平衡的64职业×2性别配对设计)、部分照片操作(27张来自公共来源的真实照片,其中局部区域被AI编辑)、短视频(56个5至30秒的视频片段,由OpenAI Sora、Google Gemini和Kling生成)。该数据集旨在研究人类和机器检测AI生成媒体的能力,特别关注现有深度伪造基准中未充分代表的场景。数据集包含图像(240张)和视频(56个),元数据为英文,许可证为CC BY-NC 4.0,主要用于自动化AI内容检测器基准测试、人类观察者检测研究、生成偏差分析和视觉AI素养培训。
授权协议:cc-by-nc-4.0 任务类别: - 图像分类 - 视频分类 语言: - 英语 标签: - 深度伪造检测(deepfake-detection) - AI生成图像(ai-generated-images) - AI生成视频(ai-generated-videos) - Midjourney - Sora - Gemini - Kling - 人类感知(human-perception) - 基准测试(benchmark) 展示名称:HumanCentric-Scenes-AI 样本规模分类: - n<1000 配置项: - 配置名称:default 数据文件: - 划分:训练集 路径:metadata.csv 数据集信息: 特征: - 名称:file_name 数据类型:字符串 - 名称:filename 数据类型:字符串 - 名称:original_filename 数据类型:字符串 - 名称:modality 数据类型: 类别标签: 可选值: "0": 图像 "1": 视频 - 名称:label 数据类型: 类别标签: 可选值: "0": 真实样本 "1": AI生成样本 - 名称:generator 数据类型:字符串 - 名称:generator_version 数据类型:字符串 - 名称:prompt 数据类型:字符串 - 名称:category 数据类型:字符串 - 名称:subcategory 数据类型:字符串 - 名称:occupation 数据类型:字符串 - 名称:depicted_gender 数据类型:字符串 - 名称:pose 数据类型:字符串 - 名称:source_url 数据类型:字符串 - 名称:contributor 数据类型:字符串 - 名称:stimulus_set 数据类型:字符串 ## HumanCentric-Scenes-AI 本多模态基准数据集包含296个AI生成的以人为中心的场景,涵盖四大领域: - **CCTV / 监控图像(集2,85张图像)**:由Midjourney生成的静态画面,模拟低分辨率监控摄像头素材——停车场、建筑内部、户外公共空间——旨在测试检测线索能否在重度压缩与低光照噪声下保留。 - **职业×性别肖像(集3,128张图像)**:采用均衡的64职业×2性别配对设计,由Midjourney基于两个基础提示词模板(佳能工作环境拍摄与柯达颗粒感构图)加上少量场景标签变体生成,用于研究提示生成的性别线索如何被检测(而非衡量生成器的固有偏差)。 - **局部图像篡改(集5,27张图像)**:来自公开来源的真实照片,仅在单个局部区域(面部、手部、背景物体)应用AI编辑,作为衍生作品发布,用于研究检测线索的定位方式。 - **短格式视频(集6,56个视频)**:5至30秒的片段,涵盖OpenAI Sora(18个)、Google Gemini(35个)与Kling(1个)生成的内容,包含日常活动、采访、直播、抗议、公开演讲、社交媒体、虚拟沟通以及Zoom会议场景。 本数据集专为研究人类与机器检测AI生成媒体的能力而打造,重点关注现有深度伪造基准中代表性不足的场景类型。 **🤗 数据集:** [huggingface.co/datasets/Nima0Kamali/humancentric-scenes-ai](https://huggingface.co/datasets/Nima0Kamali/humancentric-scenes-ai) ## 数据集说明 - **整理者:** Sana Nasiri、Nima Kamali,由Negar Kamali协调(西北大学凯洛格管理学院) - **语言:** 图像/视频内容,元数据为英文 - **授权协议:** CC BY-NC 4.0(AI生成内容与元数据) - **模态:** 图像(240张)、视频(56个) ## 数据集来源 - **相关论文:** *HumanCentric-Scenes-AI: A Multimodal Benchmark of AI-Generated Human-Centric Scenes*(arXiv,2026——待发表) - **联系方式:** negar.kamali@u.northwestern.edu ## 适用场景 ### 直接适用场景 - 自动化AI内容检测器(图像与视频分类器)的基准测试 - 研究人类观察者如何在非面部肖像领域检测AI生成媒体 - 生成偏差分析(集3采用均衡的64职业×2性别配对设计) - 视觉AI素养培训课程素材 ### 不适用场景 - **训练生成式模型:** 本授权协议明确禁止使用本数据集训练生成器,样本量远低于此类训练所需的规模。 - **身份识别或生物特征推断:** 图中人物均为合成生成,将其视为真实主体的做法不被支持。 - **商业应用:** CC BY-NC 4.0协议禁止商业使用。 ## 数据集结构 ### 组成结构 | 集号 | 领域 | 样本量 | 生成器 | 文件格式 | |---|---|---:|---|---| | 2 | CCTV / 监控 | 85 | Midjourney v6 | `.jpeg` | | 3 | 职业×性别肖像 | 128 | Midjourney | `.jpeg` | | 5 | 局部篡改 | 27 | 局部编辑流水线 | `.png` | | 6 | 短格式视频 | 56 | Sora (18)、Gemini (35)、Kling (1)、未知 (2) | `.mp4` | | **总计** | | **296** | | | ### 文件夹布局 . ├── README.md ├── metadata.csv # 296行,16个字段 ├── LICENSE ├── .gitattributes # 用于Git LFS存储大文件的属性配置 ├── data/ │ ├── set2_cctv/ai_midjourney/ (85个 .jpeg 文件) │ ├── set3_gender_occupation/ai_midjourney/ (128个 .jpeg 文件) │ ├── set5_partial_manipulation/ai_partially_edited/ (27个 .png 文件) │ └── set6_video/ │ ├── ai_sora/ (18个 .mp4 文件) │ ├── ai_gemini/ (35个 .mp4 文件) │ ├── ai_kling/ (1个 .mp4 文件) │ └── ai_unknown/ (2个 .mp4 文件) ├── scripts/ │ └── fetch_real_items.py # 下载配对真实参考样本的脚本 └── docs/ ├── PROVENANCE.md # 逐标签页的来源说明 └── DATASHEET.md # Gebru风格数据集说明文档 ### 数据字段 `metadata.csv`的每一行对应一个二进制文件。 | 字段名 | 类型 | 描述 | |---|---|---| | `file_name` | 字符串 | 数据集根目录到二进制文件的相对路径(例如 `data/set3_gender_occupation/ai_midjourney/...jpeg`)。 | | `filename` | 字符串 | 仅文件名部分(SHA-256哈希值+扩展名)。 | | `original_filename` | 字符串 | 整理前的原始文件名。 | | `modality` | 类别标签 | `图像` 或 `视频`。 | | `label` | 类别标签 | 本版本所有样本的标签均为 `AI生成样本`。 | | `generator` | 字符串 | `midjourney` / `sora` / `gemini` / `kling` / `partial_edit_pipeline` / `unknown`。 | | `generator_version` | 字符串 | 已知的生成器版本(通常为空)。 | | `prompt` | 字符串 | 生成提示词(集3、5、6-Sora包含该字段;其余集为空)。 | | `category` | 字符串 | 高级领域分类(`cctv`、`occupational_portrait`、`partial_manipulation`、`video`)。 | | `subcategory` | 字符串 | 领域特定子标签(例如 `surveillance`、`activity`、`zoom`)。 | | `occupation` | 字符串 | 64种职业之一(仅集3包含)。 | | `depicted_gender` | 字符串 | `M`(男性) / `F`(女性)(仅集3包含)。 | | `pose` | 字符串 | 预留字段(当前为空)。 | | `source_url` | 字符串 | 配对真实参考样本的URL(仅集6-Sora样本包含)。 | | `contributor` | 字符串 | 样本整理者。 | | `stimulus_set` | 字符串 | `set2_cctv` / `set3_gender_occupation` / `set5_partial_manipulation` / `set6_video`。 | ### 文件名约定 所有文件均采用 `<内容的SHA-256哈希值>.<文件扩展名>` 命名,以简化完整性校验。集2、3、5的源文件已采用SHA哈希命名;集6视频源文件采用描述性命名(例如 `activity_gemini_001.mp4`),整理时重新计算哈希并重命名。原始描述性文件名保留在`original_filename`字段中。 ### 数据集划分 仅包含`train`划分,共296条数据;本数据集旨在作为基准而非训练素材,因此未提供测试/验证划分。 ## 加载方式 python from datasets import load_dataset, Image, Video ds = load_dataset("Nima0Kamali/humancentric-scenes-ai", split="train") # 为图像样本附加图像加载器: images = ds.filter(lambda r: r["modality"] == "image").cast_column("file_name", Image()) # 为集6的视频样本附加视频加载器: videos = ds.filter(lambda r: r["modality"] == "video").cast_column("file_name", Video()) ## 数据集创建 ### 整理初衷 现有深度伪造基准大多以无约束场景下的面部肖像为主。HumanCentric-Scenes-AI填补了AI检测行为研究中的四大空白:低分辨率监控场景、职业肖像场景(生成偏差在此场景下具有研究价值)、真实照片局部篡改场景(可用于研究检测线索的定位)以及短格式社交视频场景(当前生成器生态仍在快速迭代)。 ### 源数据 - **集2 — 监控图像(Midjourney):** 85个模仿低分辨率监控画面风格的提示词,由Sana Nasiri使用Midjourney v6生成。 - **集3 — 职业×性别肖像(Midjourney):** 均衡的64职业×2性别配对设计(共128个刺激样本),由Nima Kamali生成。提示词采用两个基础模板:模板A — `"Realistic portrait of a [female/male] <occupation> in their working environment, shot on Canon"`(128个样本中的16个,8个女性样本+8个男性样本)——和模板B — `"portrait of a [female/male] <occupation>, shot on Kodak, grainy"`(128个样本中的101个,51个女性样本+50个男性样本)。剩余11个样本为模板A或B的衍生变体,添加了额外场景标签(例如 `"with a blackboard in the background"`)。由于性别由提示词明确指定,本集仅用于**检测研究**,而非衡量生成器的固有偏差。 - **集5 — 局部图像篡改:** 27张来自公开来源的真实照片,每张照片均应用了AI编辑区域。作为学术研究的合理使用作品发布,不重新分发真实源照片。 - **集6 — 短格式视频:** 56个5至30秒的视频片段,分别由OpenAI Sora(18个)、Google Gemini(35个)、Kling(1个)和2个未指定生成器生成,生成时间为2025年9月至2026年5月。Sora片段附带配对的YouTube参考链接(`source_url`字段)。 整理过程中参考的真实照片与视频(来自Flickr、iStock、Adobe Stock、Getty Images、路透社、《卫报》、《滚石》杂志与YouTube)未被重新分发。用户可通过`scripts/fetch_real_items.py`脚本自行下载,需遵循原始来源的授权协议。 ### 标注信息 每个AI样本均附带生成时记录的提示词。集3额外包含`occupation`与`depicted_gender`字段。集5包含编辑时使用的场景描述标题。集6的Sora样本包含完整提示词与配对的YouTube参考URL;Gemini与Kling样本目前仅包含从文件名派生的元数据(生成器与子分类),未来将在源电子表格可公开后补充完整元数据。 ## 偏差、风险与局限性 - **所有样本均为AI生成:** 研究人员若需进行AI与真实样本的检测对比,需自行配对真实参考样本。集6 Sora子集的真实参考样本可通过`scripts/fetch_real_items.py`下载,其余样本的真实参考链接将在后续补充后获取。 - **集3仅用于检测研究,而非生成偏差研究:** 由于提示词明确指定了性别,64×2的配对设计仅允许研究人员探究“人类/模型对性别不匹配肖像的检测率是否存在差异”,但无法测量“模型在无提示时生成的性别倾向”。生成偏差研究需采用其他实验方案。 - **样本量偏小:** 本数据集为专为行为研究打造的刺激样本库,而非训练语料。基于296个样本的检测分类器结果仅可视为探索性结果。 - **集2元数据缺失:** 集2的85张监控图像均未在`metadata.csv`中提供逐样本提示词。85个提示词均存在于工作电子表格(`mj_images_cctv`标签页)中,但通过描述性文件名索引,而重新分发的文件已按内容哈希重命名,无法建立文件名与提示词的对应关系。 - **集6元数据缺失:** 集6的56个视频中,38个(Gemini、Kling与2个未指定生成器样本)仅包含从文件名派生的元数据。 ## 引用格式 bibtex @misc{kamali2026humancentric, title = {HumanCentric-Scenes-AI: A Multimodal Benchmark of AI-Generated Human-Centric Scenes Across Surveillance, Occupational Portraits, Partial Edits, and Short-Form Video}, author = {Kamali, Nima and Nasiri, Sana and Kamali, Negar}, year = {2026}, eprint = {arXiv:XXXX.XXXXX}, note = {Stimulus library accompanying the arXiv preprint.} } ## 授权协议 本数据集的AI生成资产、元数据与整理成果均采用**CC BY-NC 4.0**协议发布。通过`source_url`字段引用的真实照片与视频仍受其原始来源的授权协议约束(Flickr、iStock、Adobe Stock、Getty Images、路透社、《卫报》、《滚石》杂志与YouTube)。集5的局部篡改样本基于公开来源的真实照片进行AI编辑,作为学术研究的合理使用作品发布。本数据集不得用于训练生成式模型。 ## 数据集卡片作者 Nima Kamali、Sana Nasiri、Negar Kamali ## 数据集卡片联系方式 - **第一作者Nima Kamali:** nima.kamaliz97@gmail.com - **通讯作者Negar Kamali(西北大学):** negar.kamali@u.northwestern.edu