
segmentation-py314-pylingual-v5-tokenized
收藏官方服务:
资源简介:
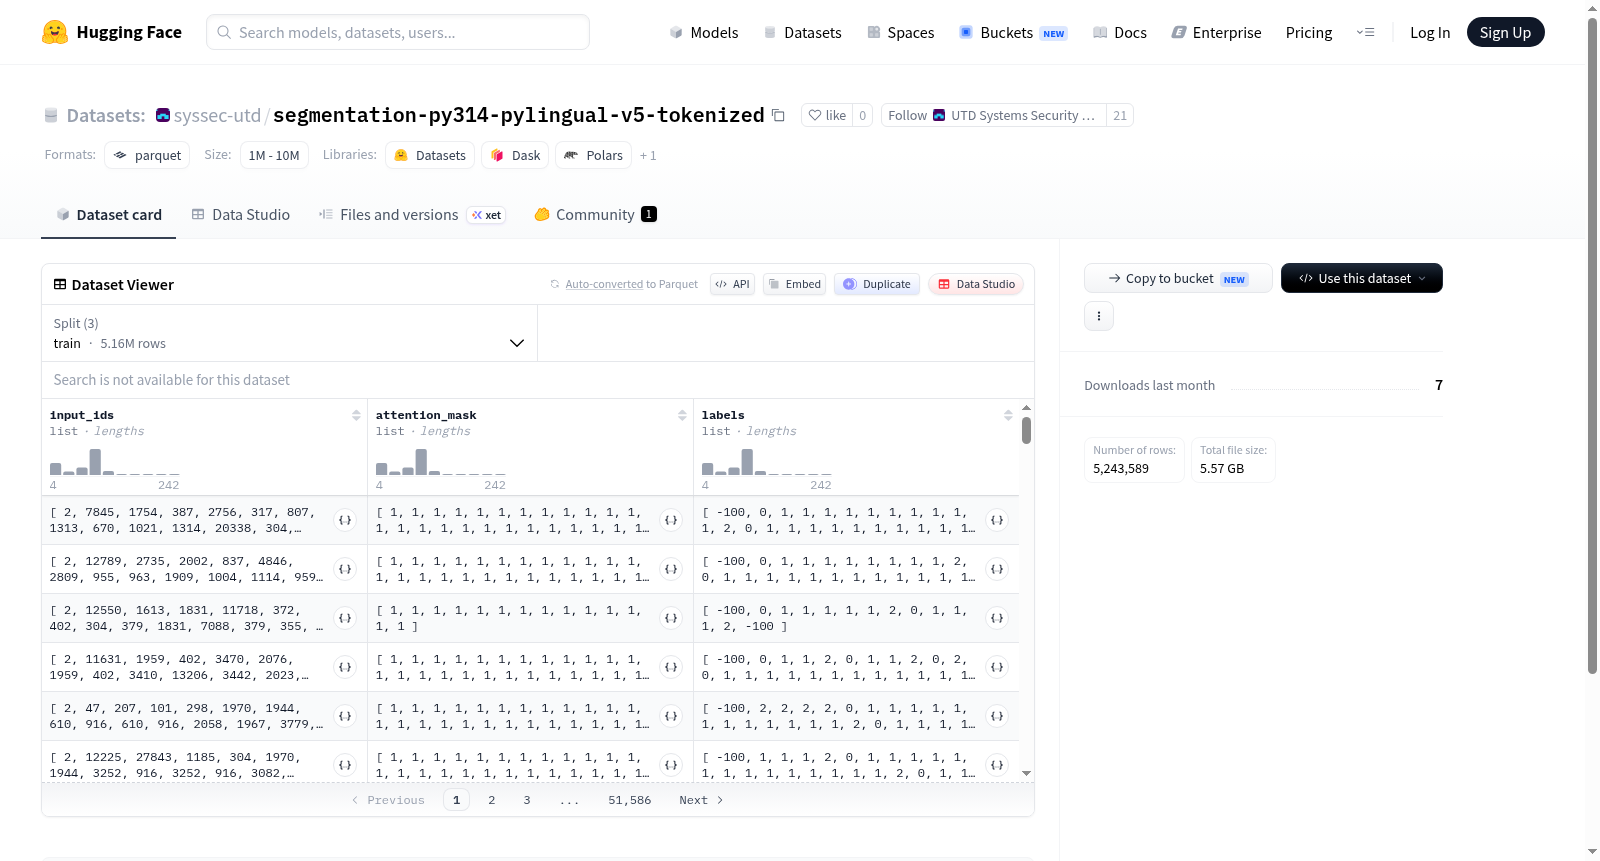
该数据集包含三个特征:input_ids(int32类型列表)、attention_mask(int8类型列表)和labels(int64类型列表)。数据集分为训练集、测试集和验证集:训练集有5,158,566个样本,测试集有44,253个样本,验证集有40,770个样本。总数据集大小约为4.54 GB,下载大小约为5.57 GB。
The dataset contains three features: input_ids (list of int32), attention_mask (list of int8), and labels (list of int64). It is split into training set (5,158,566 samples), test set (44,253 samples), and validation set (40,770 samples). The total dataset size is approximately 4.54 GB, with a download size of about 5.57 GB.
创建时间:
2026-08-02
原始信息汇总
数据集概述:segmentation-py314-pylingual-v5-tokenized
该数据集由syssec-utd组织提供,托管于Hugging Face平台,是一个经过分词处理的Python代码分割数据集(版本v5)。
数据集特征
数据集包含三个特征列:
- input_ids:类型为
list<int32>,是输入数据的词元ID序列。 - attention_mask:类型为
list<int8>,用于标识输入序列中有效词元的掩码。 - labels:类型为
list<int64>,是用于监督学习的标签序列。
数据集划分
该数据集被划分为三个子集:
| 划分 | 样本数量 | 大小(字节) |
|---|---|---|
| train(训练集) | 5,158,566 | 4,464,790,619 |
| test(测试集) | 44,253 | 37,417,561 |
| valid(验证集) | 40,770 | 36,273,235 |
数据集规模
- 总下载大小:5,574,344,923 字节(约5.57 GB)
- 总数据集大小:4,538,481,415 字节(约4.54 GB)
配置信息
数据集默认配置为default,包含三个数据文件路径:
- 训练数据:
data/train-* - 测试数据:
data/test-* - 验证数据:
data/valid-*
用途推测
根据数据集名称(包含segmentation和pylingual)以及标签字段推测,该数据集可能用于Python代码的语义分割或相关代码理解任务,与pylingual工具链的v5版本配套使用。
搜集汇总
数据集介绍
构建方式
该数据集是基于Pylint静态分析工具对Python源代码进行语义分割任务构建的大规模语料库,经过PyLingual引擎的深度处理与分词(tokenization)流程,将原始代码转化为模型可读的token序列,并精心标注了相应的标签信息,最终形成结构化的训练、验证与测试三部分数据。
特点
数据集规模宏大,训练集包含超过515万条样本,测试与验证集分别拥有约4.4万和4.1万条样本,总计数据量超过4.5GB,为深度学习模型提供了丰富的学习资源。其每条样本均包含input_ids、attention_mask及labels,适配于Transformer架构的序列标注任务,且数据特征设计严谨,能够有效支撑代码语义理解相关的研究与开发。
使用方法
本数据集适用于Python代码分析、缺陷检测、语义分割等多种自然语言处理与代码智能任务。用户可通过HuggingFace的datasets库便捷加载,利用其标准的数据结构直接训练PyTorch或TensorFlow模型,亦可用于微调预训练语言模型,以提升在代码理解领域的性能表现。
背景与挑战
背景概述
随着深度学习在自然语言处理领域的迅猛发展,代码理解与生成已成为研究热点。segmentation-py314-pylingual-v5-tokenized数据集应运而生,由Pylingual团队于近期构建,旨在服务于代码分割任务,即从Python源代码中识别并提取语义完整的代码片段。该数据集包含超过515万训练样本,测试与验证集分别包含约4.4万和4.1万样本,规模可观,为代码智能研究提供了坚实的数据基础。其核心研究问题聚焦于如何利用大规模tokenized数据提升模型对代码结构的理解能力,进而推动代码检索、摘要及自动补全等应用的发展。该数据集的发布,为代码分割领域注入了新的活力,有望成为该方向的基准资源。
当前挑战
该数据集所应对的领域挑战在于代码分割任务本身:代码结构复杂且语义层次丰富,传统方法难以准确界定代码片段的边界,而深度学习模型需要海量标注数据以学习上下文依赖,数据集的规模与质量直接制约模型性能。构建过程中亦面临诸多困难,首先,原始代码需经过Pylingual解析器处理,确保语法正确性与一致性;其次,tokenization过程需平衡粒度与效率,避免信息丢失;最后,数据集的规模庞大,需进行分布式存储与高效的数据加载设计,以保证训练时I/O不会成为瓶颈。此外,数据集的标注依赖于自动化流程,如何确保噪声最小化也是一大挑战。
常用场景
经典使用场景
该数据集为代码分割任务量身定制,其核心应用在于训练和评估基于深度学习的代码语义分割模型。数据集中包含了海量的token化代码片段,每个样本均提供input_ids、attention_mask和labels,为序列标注模型提供了标准化的输入格式。在经典的使用场景中,研究者利用该数据集进行代码标识符的边界识别、语句级切分以及方法体划分等细粒度分割任务,从而提升代码理解与生成的精度。此外,该数据集亦可作为预训练语言模型在代码领域的微调基准,用于验证模型对程序结构感知能力,是代码智能领域不可或缺的实验资源。
实际应用
在实际应用中,该数据集直接服务于代码补全、智能代码编辑器和自动化重构工具的开发。基于此数据训练的分割模型可嵌入集成开发环境(IDE),实时识别代码块边界,辅助开发者进行精准的折叠、导航和重构操作。在代码检索和代码克隆检测系统中,分割结果能提升索引粒度与匹配准确率。同时,该数据集支撑了教育辅导平台中的代码结构可视化功能,帮助学习者直观理解程序逻辑。对于自动化代码审查和漏洞检测,准确的分割是提取关键语义单元的前提,从而提升安全分析工具的可解释性与效率。
衍生相关工作
该数据集衍生出一系列经典工作,包括基于预训练模型(如CodeBERT、GraphCodeBERT)在代码分割任务上的微调研究,验证了跨模态特征融合的有效性。相关研究者也构建了多任务学习框架,将代码分割与代码摘要、类型推断联合建模,显著提升了代码理解的综合性能。此外,数据集的发布促进了对抗性样本生成与鲁棒性分析的研究,探索了模型在代码混淆和格式扰动下的稳定性。还有工作将其应用于弱监督与半监督场景,通过数据增强和伪标签策略,缓解了标注稀缺问题。这些衍生研究共同推动了代码智能领域从单一任务向综合化、实用化方向发展。
以上内容由遇见数据集搜集并总结生成


