
遇见数据集

voice-authenticity-dataset

收藏
Hugging Face2026-08-30 更新2026-08-31 收录
官方服务:

资源简介:

该数据集包含人类语音和合成语音的音频样本,共108个样本(60个人类语音,48个合成语音)。每个样本提供以下信息:贡献ID、数据来源(如人类或合成)、语言、提示ID、罗马化提示文本、说话人年龄范围、性别、所在区域、录制环境、所用的TTS引擎(仅合成语音)、语音ID、音频文件(16kHz采样率)、音频时长(秒)、提交时间戳。该数据集适用于语音合成、语音识别、说话人识别、语音风格分析、多语言语音研究等任务,也可用于比较人类语音与合成语音的差异。

This dataset contains audio samples of human speech and synthetic speech, with a total of 108 samples (60 human speech and 48 synthetic speech). Each sample provides the following information: contribution ID, data source (e.g., human or synthetic), language, prompt ID, romanized prompt text, speaker age range, gender, region, recording environment, TTS engine used (synthetic speech only), voice ID, audio file (16kHz sampling rate), audio duration (seconds), and submission timestamp. This dataset is suitable for tasks such as speech synthesis, speech recognition, speaker recognition, speech style analysis, multilingual speech research, and also for comparing differences between human speech and synthetic speech.

创建时间:
2026-08-30
原始信息汇总

数据集概述:voice-authenticity-dataset

基本信息

数据集内容

该数据集包含语音音频样本,每条样本附带详细元数据(共14个字段),具体特征包括:

特征名 类型 说明
contribution_id string 贡献样本的唯一标识
source string 音频来源
language string 语言
prompt_id string 提示文本标识
prompt_text_romanized string 提示文本(罗马化)
age_range string 说话者年龄范围
gender string 说话者性别
region string 地区
environment string 录音环境
tts_engine string 文本转语音引擎(合成样本)
voice_id string 语音标识
audio audio (采样率16kHz) 音频数据
duration_seconds float64 音频时长(秒)
submitted_at string 提交时间

数据集划分

数据分为两个子集:

划分名称 样本数量 大小
human(人类语音) 60条 约13.98 MB(13,984,019字节)
synthetic(合成语音) 48条 约9.14 MB(9,135,159字节)

数据用途

该数据集可用于语音真实性检测任务,通过对比人类语音与合成语音样本,支持语音伪造检测、语音鉴别等相关模型训练与评估。
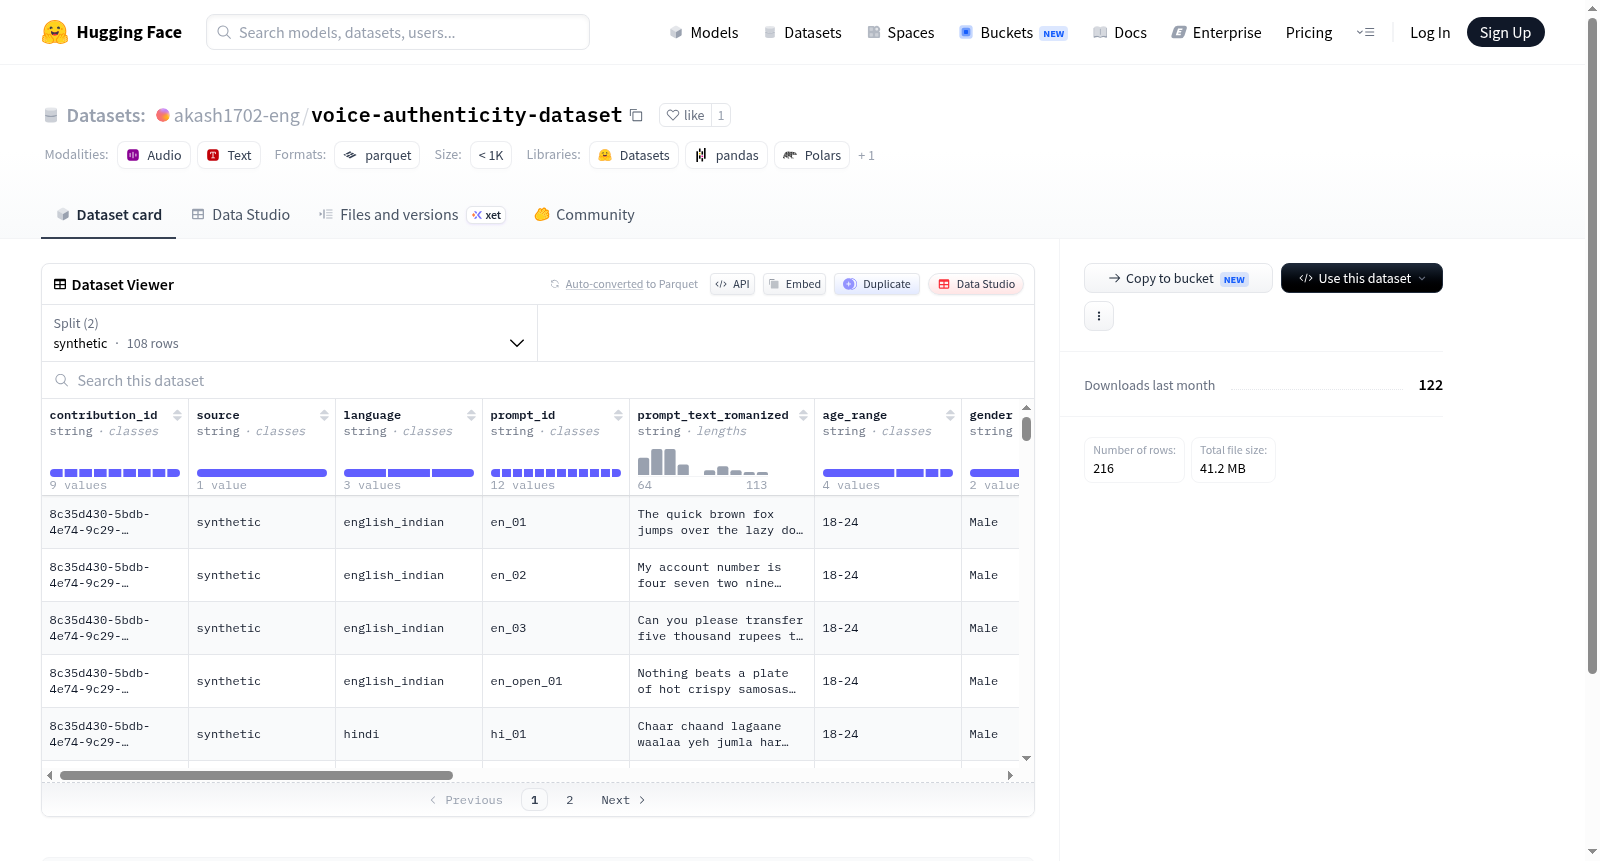
搜集汇总
数据集介绍
voice-authenticity-dataset 数据集图片
构建方式
该数据集旨在应对语音伪造技术日益泛滥的严峻挑战,为语音真实性鉴别领域提供高质量的训练与评估资源。其构建过程严谨细致,数据来源涵盖两大类别:合成语音与真实人声,分别存储于synthetic和human两个子集中。每条样本均包含丰富的元数据,如语种、年龄段、性别、地域、录音环境、推理引擎及语音标识等,确保了数据的多维覆盖与可追溯性。音频统一以16kHz采样率存储,并附带时长信息,便于后续处理。构建时兼顾了样本的多样性与均衡性,共计108条音频,其中合成样本48条,真实样本60条,为模型训练奠定了坚实的数据基础。
特点
该数据集的显著特色在于其精细的标注体系与多维度的情境覆盖。每条记录不仅提供音频文件,还详尽记录了提示文本、说话人属性(年龄、性别、地域)及录音环境,这为研究不同条件下语音真实性的判别提供了丰富维度。尤其值得关注的是,合成语音部分明确了所采用的TTS引擎,使研究者能够针对特定合成技术进行深入分析。数据集的存储格式规范,采用Parquet格式,兼容主流数据处理工具,且单条音频时长信息有助于模型训练时的批处理优化。此外,数据集规模虽小,但样本质量高,兼顾了可控性与真实性,非常适用于小样本学习、特征工程及模型鲁棒性测试等研究场景。
使用方法
该数据集的使用便捷高效,研究者可通过HuggingFace datasets库直接加载,仅需指定split参数即可获取相应的合成或真实语音子集。加载后,每条样本以字典形式呈现,其中audio字段为包含音频数组及采样率的对象,可直接输入到音频处理管道中。得益于其清晰的元数据架构,用户可依据语种、性别、环境等条件进行灵活的数据筛选,以构造定制化的评估集或训练集。对于语音伪造检测任务,建议将human子集作为正例,synthetic子集作为负例,构建二分类模型。此外,该数据集亦可作为预训练模型的微调语料,或用于探究跨条件泛化性能,为语音安全领域的研究提供实证支持。
背景与挑战
背景概述
voice-authenticity-dataset 是一个专为语音真实性检测研究设计的多语种数据集,由相关研究团队于近期构建并发布。该数据集的核心研究问题聚焦于区分自然人类语音与经由文本转语音(TTS)引擎生成的合成语音,以应对合成语音技术日益成熟所引发的安全与伦理挑战。数据集涵盖多种语言、年龄层、性别、地域及录音环境,并记录了详细的提示文本与语音元数据,为开发鲁棒的语音伪造检测算法提供了基准。其发布对语音取证、身份认证以及深度伪造防御等领域具有重要意义,推动了语音真实性验证技术的实证研究进展。
当前挑战
该数据集研究面临多重挑战。首先,领域问题层面,合成语音技术质量不断提升,新型TTS引擎可生成高度逼真的语音,致使传统检测方法的区分度下降,需设计能够捕捉细微伪影的先进算法。其次,数据集构建过程中,确保多维度样本的均衡代表性难度大,如地域、环境背景噪声及语种差异的覆盖不均,可能引入偏差并影响模型泛化能力。此外,有限的样本量(合成48例、人类60例)对训练复杂深度学习模型的可行性构成制约,且标注过程需严格验证数据的真实性,以防范误标注风险。这些挑战共同考验着数据集作为评估基准的可靠性与实用性。
常用场景
经典使用场景
该数据集作为语音真实性验证领域的基准资源,其核心应用场景聚焦于区分自然人声与合成语音。在深度伪造技术日益成熟的当下,语音伪造对安全认证、司法取证等领域构成严峻挑战。数据集精心构建了双轨结构:涵盖60条真实人声样本与48条由多种TTS引擎生成的合成音频,并细致标注了说话人年龄、性别、地域、环境噪声等元信息,为研究者提供了粒度精细的对照实验条件。其典型用途包括训练二分类鉴别模型、评估声学特征对伪造痕迹的敏感性,以及验证跨引擎泛化能力,是开发鲁棒性语音防伪系统的理想训练与测试平台。
衍生相关工作
基于该数据集已衍生多项前沿探索。一是推动了面向未知TTS引擎的零样本检测研究,研究者利用其合成子集训练判别网络,进而迁移到新引擎生成的音频上,验证了特征解耦策略的可行性。二是催生了多模态伪造检测工作,将音频特征与来自prompt文本的语音内容语义相结合,构建端到端一致性校验模型。三是启发了对抗性攻防研究,通过该数据集生成对抗样本,评估现有鉴别器的脆弱性,并据此开发鲁棒的增强训练范式。此外,数据集的元数据(如年龄、性别)被用于研究公平性问题,揭示检测模型在特定人群上的偏差,推动了可信AI评测的深化。
数据集最近研究
最新研究方向
本数据集聚焦于语音真实性的鉴别,其最新研究方向在于利用多维度标注信息(如年龄、性别、区域、环境及TTS引擎类型)构建细粒度的真伪语音分类模型,以应对深度伪造技术对语音安全领域的严峻挑战。随着生成式语音合成技术的飞速发展,虚假语音的逼真度显著提升,传统鉴别方法面临失效风险。该数据集的引入为开发鲁棒性更强的伪造语音检测算法提供了宝贵资源,推动跨语言、跨场景下的语音防伪研究,并促进音频取证、身份验证和内容审核等实际应用的安全边界拓展。通过区分人类自然语音与多引擎生成的合成语音,该数据集有助于评估和提升检测系统在面对多样化生成条件时的泛化能力,从而为构建可信的语音交互环境奠定数据基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务


