car-bench-dataset
收藏资源简介:
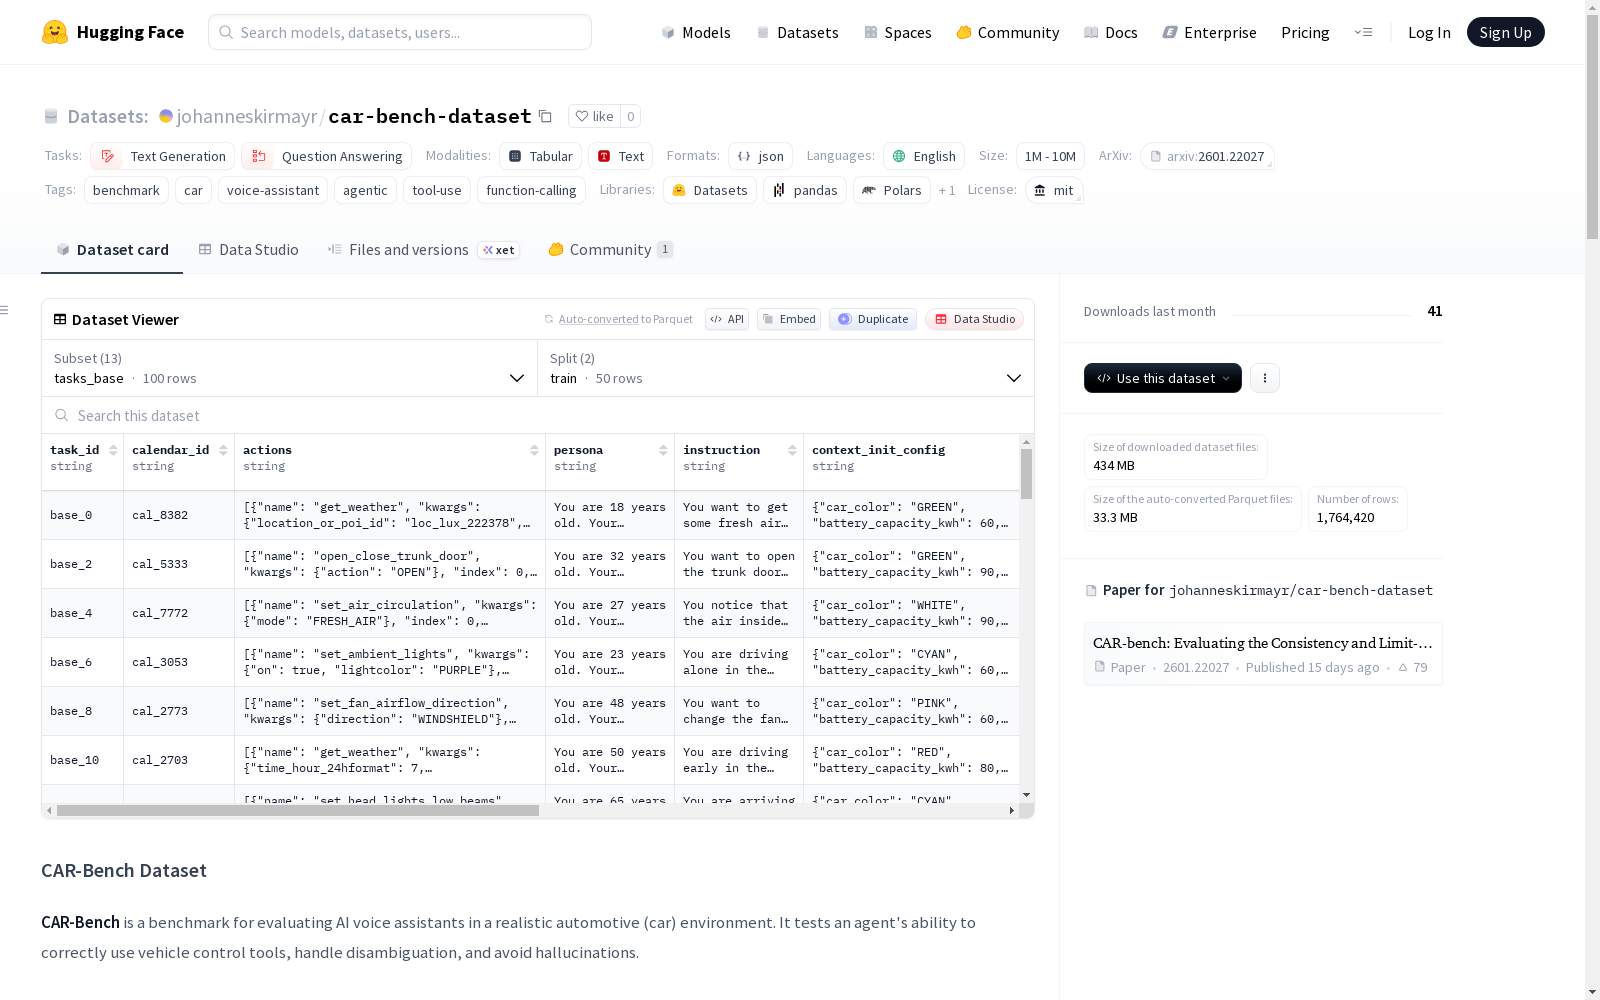
CAR-Bench 是一个用于在真实汽车环境中评估 AI 语音助手的基准测试数据集。它测试代理正确使用车辆控制工具、处理歧义和避免幻觉的能力。数据集分为任务配置和模拟数据配置两部分。任务配置包括基本任务、歧义任务和幻觉任务,每个任务定义了用户角色、指令、初始车辆/环境上下文以及助手应执行的工具调用动作的真实序列。模拟数据配置模拟了汽车环境数据库,包括位置、兴趣点、天气、路线、日历和联系人等数据。数据集适用于文本生成和问答任务,规模在1K到10K之间,语言为英语。
CAR-Bench is a benchmark dataset for evaluating AI voice assistants in real automotive environments. It evaluates the ability of agents to correctly use vehicle control tools, resolve ambiguities, and avoid hallucinations. This dataset is divided into two parts: task configuration and simulation data configuration. The task configuration includes basic tasks, ambiguity tasks, and hallucination tasks, where each task defines the user role, instructions, initial vehicle/environment context, and the ground-truth sequence of tool invocation actions that the assistant should perform. The simulation data configuration simulates the automotive environment database, including data such as locations, points of interest (POIs), weather, routes, calendars, and contacts. This dataset is suitable for text generation and question answering tasks, with a scale ranging from 1K to 10K, and uses English as its language.
CAR-Bench 数据集概述
数据集基本信息
- 数据集名称: CAR-Bench Dataset
- 数据集地址: https://huggingface.co/datasets/johanneskirmayr/car-bench-dataset
- 许可证: mit
- 任务类别: 文本生成、问答
- 语言: 英语
- 标签: 基准测试、汽车、语音助手、智能体、工具使用、函数调用
- 数据规模: 1K<n<10K
数据集目的
CAR-Bench 是一个用于在真实汽车环境中评估人工智能语音助手的基准测试。它测试智能体正确使用车辆控制工具、处理歧义和避免幻觉的能力。
数据集结构
数据集分为任务配置和模拟数据配置。
任务配置
每个任务定义了用户角色、指令、初始车辆/环境上下文以及助手应执行的工具调用操作的真实序列。
| 配置名称 | 描述 | 训练集大小 | 测试集大小 |
|---|---|---|---|
tasks_base |
涵盖车辆控制、导航、日历等的标准任务 | 50 | 50 |
tasks_disambiguation |
要求智能体消除参数歧义的任务 | 30 | 26 |
tasks_hallucination |
故意移除某些工具/参数以测试智能体是否产生幻觉的任务 | 48 | 50 |
任务模式字段:
task_id: 字符串,唯一任务标识符persona: 字符串,模拟用户的个性和沟通风格描述calendar_id: 字符串,模拟数据中日历的引用instruction: 字符串,给予模拟用户的指令context_init_config: 字符串,初始车辆和环境状态actions: 字符串,工具调用的真实序列task_type: 字符串,任务类型disambiguation_element_internal: 字符串或空,需要内部消除歧义的元素disambiguation_element_user: 字符串或空,需要向用户澄清的元素disambiguation_element_note: 字符串或空,解释歧义的注释removed_part: 字符串或空,被移除的工具/参数
模拟数据配置
模拟数据模拟了基准测试执行期间工具使用的真实汽车环境数据库。
| 配置名称 | 数据行数 | 描述 |
|---|---|---|
mock_locations |
48 | 带有GPS坐标的欧洲城市 |
mock_pois |
130,693 | 兴趣点 |
mock_weather |
48 | 每个位置的天气数据 |
mock_routes_location_location |
6,768 | 位置之间的路线 |
mock_routes_location_poi |
1,378 | 从位置到兴趣点的路线 |
mock_routes_poi_location |
1,378 | 从兴趣点到位置的路线 |
mock_routes_index |
1,763,870 | 路线查找索引 |
mock_routes_metadata |
1,754,346 | 兴趣点到兴趣点路线生成的元数据 |
mock_calendars |
100 | 包含会议的日历条目 |
mock_contacts |
100 | 联系人信息 |
使用方式
与 CAR-Bench 基准测试一起使用
CAR-Bench 代码库自动从此数据集加载任务和模拟数据。
独立使用
使用 datasets 库加载数据集,并可解析嵌套的JSON字段。
引用
如果使用此数据集,请引用 CAR-Bench 论文。