
n_processed
收藏官方服务:
资源简介:
该数据集包含论文的相关信息,如论文的图片、预测结果、页码、标题、作者、所属大学和学院、年份、语言、类型、摘要(中文和英文)、文件大小、下载时间戳、URL、下载状态、处理器信息以及论文的文本内容。数据集分为一个默认的split,包含170个示例,总大小为72917740字节。
This dataset contains relevant information about academic papers, including paper images, prediction results, page numbers, titles, authors, affiliated universities and colleges, publication years, languages, types, abstracts in both Chinese and English, file sizes, download timestamps, URLs, download statuses, processor information, and the full text content of the papers. The dataset has one default data split, which contains 170 examples with a total size of 72917740 bytes.
创建时间:
2025-09-16
原始信息汇总
数据集概述
基本信息
- 数据集名称:n_processed
- 存储位置:https://huggingface.co/datasets/sghosts/n_processed
- 总样本数:170
- 数据集大小:72,917,740字节
- 下载大小:71,088,634字节
数据结构
特征字段
- images:图像数据(数据类型:image)
- predictions:预测结果(数据类型:string)
- page_number:页码(数据类型:int64)
- title:标题(数据类型:string)
- author:作者(数据类型:string)
- thesis_id:论文ID(数据类型:string)
- university:大学(数据类型:string)
- department:院系(数据类型:string)
- year:年份(数据类型:string)
- language:语言(数据类型:string)
- thesis_type:论文类型(数据类型:string)
- keyword_abd:关键词(数据类型:null)
- abstract_tr:土耳其语摘要(数据类型:string)
- abstract_en:英语摘要(数据类型:string)
- file_size_bytes:文件大小(字节)(数据类型:int64)
- download_timestamp:下载时间戳(数据类型:string)
- url:URL地址(数据类型:string)
- download_success:下载成功状态(数据类型:bool)
- processor:处理器(数据类型:int64)
- processor_used:使用的处理器(数据类型:string)
- text:文本内容(数据类型:string)
数据划分
- 划分名称:default
- 样本数量:170
- 划分大小:72,917,740字节
配置信息
- 配置名称:default
- 数据文件路径:data/default-*
搜集汇总
数据集介绍
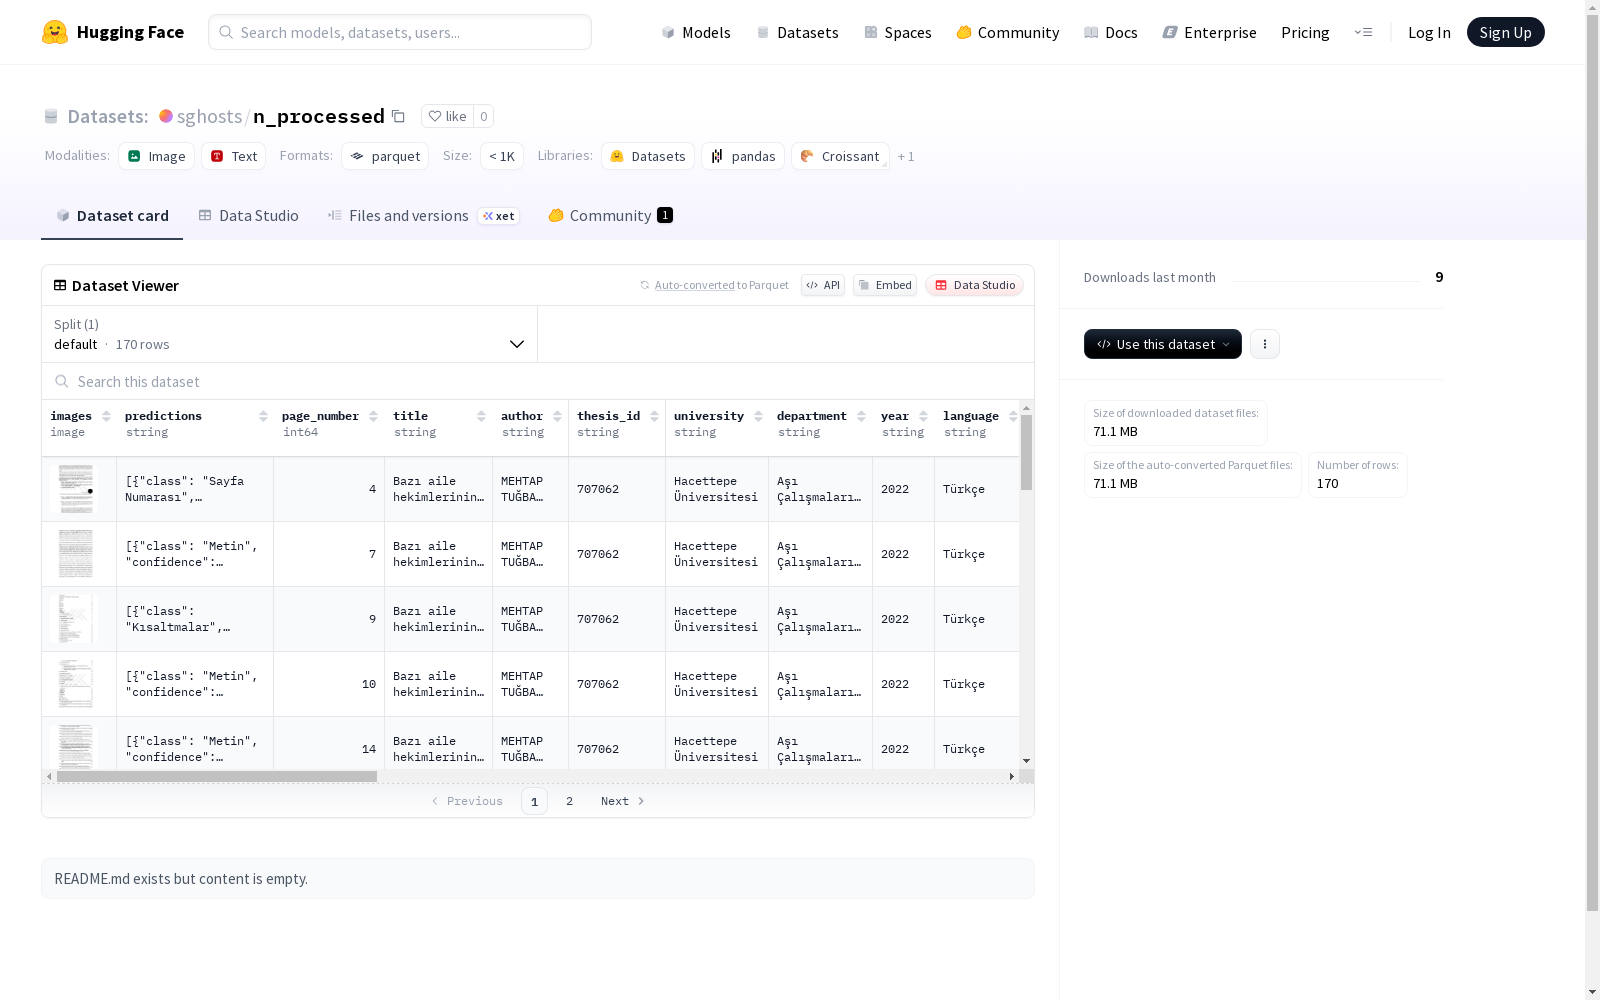
构建方式
在学术文献数字化处理领域,n_processed数据集通过系统化采集多源学术论文元数据与全文内容构建而成。其构建过程涵盖论文图像数字化转换、多语言摘要提取、结构化元数据标注等关键环节,并采用自动化流程整合论文标识符、机构信息及文本内容,形成标准化的学术文献数据集。
特点
该数据集显著特征在于包含170篇学术论文的完整多模态数据,兼具图像与文本双重形态。其特色体现在涵盖标题、作者、机构、出版年份等多维度元数据,并提供土耳其语与英语双版本摘要,支持跨语言学术研究。数据字段设计兼顾学术规范性与机器可读性,为文献分析提供丰富特征维度。
使用方法
研究者可通过加载标准数据分割接口直接访问该数据集,利用其图像与文本对应关系开展OCR技术验证。数据集支持按论文编号、机构或语言字段进行筛选,适用于学术文献挖掘、多语言自然语言处理及数字图书馆系统开发等应用场景。使用时应注重遵循原始数据许可协议,确保学术用途的合规性。
背景与挑战
背景概述
数字学术资源管理领域近年来面临海量非结构化论文数据处理的挑战,n_processed数据集应运而生。该数据集由高等教育机构联合开发,专注于学术论文的多模态信息提取与结构化处理,包含图像、文本元数据、机构信息等多维度特征。其核心价值在于为自然语言处理与计算机视觉交叉研究提供标准化实验数据,推动学术文献智能分析技术的发展。
当前挑战
该数据集需解决学术文献异构数据融合的复杂性挑战,包括跨语言摘要对齐、图像-文本关联建模等核心问题。构建过程中面临多源数据标准化处理的困难,涉及非统一格式的论文元数据提取、图像质量不一致、多语言文本处理等技术瓶颈。同时需确保大规模学术数据采集的版权合规性与数据隐私保护。
常用场景
经典使用场景
在学术文献数字化处理领域,n_processed数据集通过整合图像与文本特征,为光学字符识别(OCR)技术的验证与优化提供了标准化测试平台。研究者可利用其多模态数据结构,评估不同算法在复杂版式文档中的文字提取准确率,特别是在处理多语言学术论文摘要和元数据时展现出色适应性。
解决学术问题
该数据集有效解决了学术文献数字化过程中的结构化信息提取难题,通过提供带标注的论文元数据与全文文本,支持文献计量学中的自动分类、关键词抽取及跨语言摘要生成研究。其丰富的字段设计为知识图谱构建和学术影响力分析提供了底层数据支撑,推动了数字图书馆领域的范式创新。
衍生相关工作
该数据集催生了多项经典研究工作,包括基于Transformer的学术文献层次化标注模型DocBERT,以及结合图像与文本特征的跨模态检索系统CiteVis。其在ICDAR会议推动的文档分析竞赛中成为基准数据,促进了文档图像分析与自然语言处理领域的交叉融合。
以上内容由遇见数据集搜集并总结生成


