
遇见数据集

ca-sco-properties

收藏
Hugging Face2026-05-24 更新2026-05-25 收录
官方服务:

资源简介:

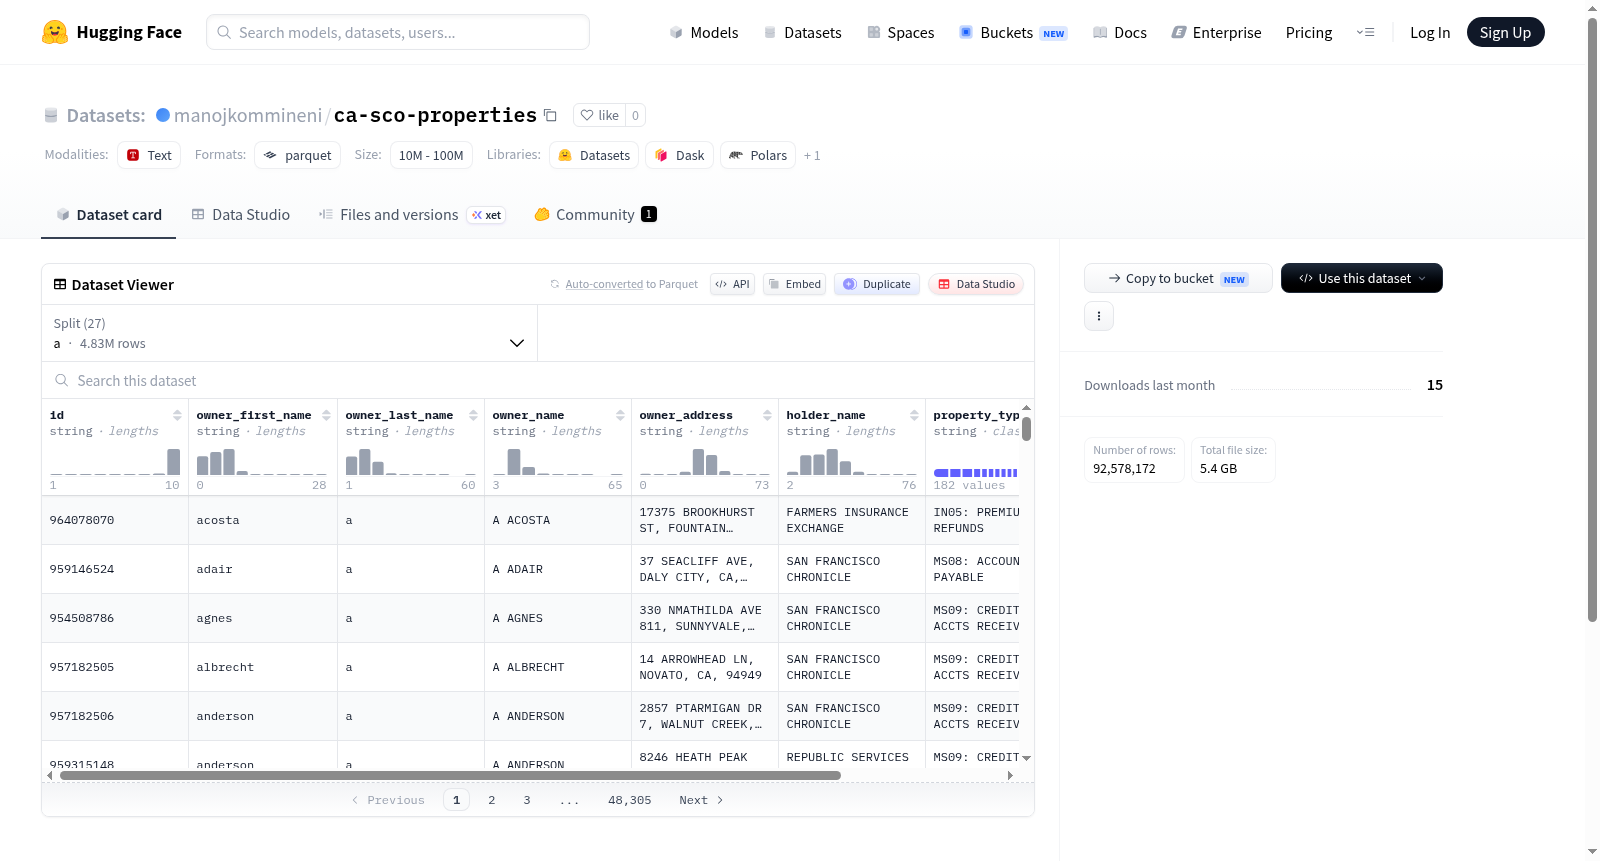
本数据集包含美国加利福尼亚州审计长办公室的无人认领财产记录。数据按财产所有者姓氏的首字母进行分桶,从字母 a 到 z 共分为 26 个分片,另有一个 other 分片用于处理姓氏首字母非标准字母的情况,总计 27 个独立的数据分片。这种组织结构旨在确保每个分片的数据量保持在 Hugging Face 平台的 5 GB 过滤器-索引大小限制以内。数据文件以 Parquet 格式存储。数据集通过自动化流程(GitHub Actions)每周更新,以反映最新的无人认领财产信息。该数据集适用于与政府公开数据、财产追踪、数据分析或公共记录研究相关的任务。

This dataset contains unclaimed property records from the California State Auditor's Office. The data is bucketed by the first letter of property owners' surnames, split into 26 shards ranging from "A" to "Z", plus an additional "other" shard for cases where the first letter of a surname is non-standard, totaling 27 independent data shards. This structure is designed to ensure that the data size of each shard stays within the 5 GB filter-index size limit of the Hugging Face platform. All data files are stored in Parquet format. The dataset is updated weekly via an automated workflow (GitHub Actions) to reflect the latest unclaimed property information. This dataset is applicable to tasks related to government open data, property tracking, data analysis, or public records research.

创建时间:
2026-05-23
原始信息汇总

数据集概述

  • 数据集名称:CA SCO Unclaimed Property
  • 数据集来源:California State Controllers Office(加州主计长办公室)
  • 数据内容:无人认领财产记录(unclaimed property records)

数据组织

数据集按物主姓氏首字母划分为多个子集(split),共27个split,分别对应字母a到z以及other(其他)。每个split的数据存储在独立的Parquet文件中:

  • a到z:每个字母对应一个split
  • other:包含其他情况的分片

存储文件模式示例:

  • a-split:data/a-*.parquet
  • b-split:data/b-*.parquet
  • ……
  • z-split:data/z-*.parquet
  • other-split:data/other-*.parquet

数据更新

  • 更新频率:每周更新一次(Weekly)
  • 更新方式:通过GitHub Actions自动执行

技术说明

  • 数据格式:Parquet
  • 设计目的:控制每个split的文件大小在Hugging Face的5 GB过滤索引限制以下
搜集汇总
数据集介绍
ca-sco-properties 数据集图片
构建方式
在公共财政管理领域,无人认领财产数据对于促进资产返还与政府透明度具有重要价值。ca-sco-properties数据集源自加利福尼亚州主计长办公室发布的无人认领财产记录。为克服Hugging Face平台对单个数据拆分索引5 GB的限制,构建者依据所有者姓氏的首字母,将数据系统地划分至26个字母拆分(a至z)及一个“other”拆分中,每个拆分对应多个Parquet格式文件。这种基于字母分桶的策略确保了各拆分规模均衡可控,并通过GitHub Actions实现每周自动更新,保障数据的时效性与延续性。
特点
该数据集最显著的特点在于其精细化的字母拆分架构与高效的存储格式。通过将记录按姓氏首字母划分为27个独立拆分,研究者能够快速定位特定姓氏群体的财产信息,避免了全量扫描带来的计算开销。所有数据均以Apache Parquet列式存储格式保存,使得大规模数据检索与分析操作在磁盘I/O与压缩效率上表现优异。此外,依托GitHub Actions的自动化流水线,数据集得以维持周级更新频率,从而紧跟官方记录变更,为长期追踪与趋势分析提供了可靠的数据基础。
使用方法
使用ca-sco-properties数据集时,用户可利用Hugging Face Datasets库按拆分名称加载特定字母范围的数据,例如指明split='a'即可获取所有姓氏以A开头的记录。加载后的数据可直接与Pandas DataFrame或PySpark等数据处理框架对接,执行过滤、聚合与统计任务。对于需要全量分析的场景,建议遍历所有拆分后合并,或采用分布式计算环境以提升处理效率。鉴于数据源属性明确,研究人员可将其用于构建财产返还预测模型、分析财产分布的地理与社会特征等应用方向。
背景与挑战
背景概述
该数据集名为ca-sco-properties,由加州主计长办公室(California State Controller's Office)创建,主要用于记录和管理加州无人认领财产(unclaimed property)信息。无人认领财产通常包括被遗忘的银行账户、未兑付的支票、保险金等金融资产,其管理对于保障公民财产权益具有重要意义。该数据集通过每周自动更新的机制,确保信息的时效性,为政府机构、研究人员和公众提供了透明化的数据访问途径。数据集按照财产所有者姓氏首字母划分为26个字母分区及一个“其他”类别,这种精细化的组织方式便于大规模数据的检索与分析,提升了数据处理效率。作为开放政府数据倡议的一部分,该数据集在促进社会监督、财产归还以及公共财政透明度方面发挥了积极作用。
当前挑战
该数据集面临的主要领域问题包括如何高效且准确地将大量无人认领财产信息整合并公开,同时确保数据的完整性和隐私保护。在构建过程中,挑战首先源于数据源的多样性,不同来源的财产记录格式和标准不一,需要统一数据模型和清洗流程。其次,数据按所有者姓氏首字母分片存储,虽然降低了单文件大小以适应平台限制,但跨分区查询和关联分析时可能增加复杂度。此外,每周更新要求持续监控数据质量,避免重复或遗漏,并应对可能的格式变更。最后,如何平衡数据开放与敏感信息脱敏之间的关系,防止个人隐私泄露,也是数据集维护中的核心难题。
常用场景
经典使用场景
ca-sco-properties数据集汇聚了加利福尼亚州主计长办公室发布的无人认领财产记录,其经典使用场景聚焦于财产归集与数据清洗领域。研究者和数据科学家可借助该数据库,针对姓氏首字母划分的分片存储结构,高效开展大规模财产记录的去重、匹配与整合工作,从而复原遗漏的权属关系。该数据集因其连续更新的特性,成为追踪财产流向、分析无人认领财产演变规律的基石资源。
衍生相关工作
基于ca-sco-properties衍生出诸多经典工作,例如利用自然语言处理对记录中模糊的姓名与地址进行标准化,提升跨数据集链接的准确性;时间序列分析研究也被用于预测不同地区及人群的财产认领概率,辅助资源分配;最新的工作在此基础上融合地理编码技术,揭示财产分布的空间模式,为政策制定者提供精准的干预靶点,持续拓展公共数据的社会价值边界。
数据集最近研究
最新研究方向
加州无人认领财产数据集正逐步成为公共财政透明化与数据分析交叉领域的研究热点。通过按姓氏首字母分桶存储的细粒度结构,研究者得以高效挖掘财产归属模式、区域分布不均及申领延迟成因。结合自动更新机制,该数据为理解经济行为中的财产遗忘动态、优化政府通知策略及构建预测性治理模型提供了实证基础,在数字化公共管理与社会公平议题中展现出独特价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

