reddit_dataset_41
收藏资源简介:
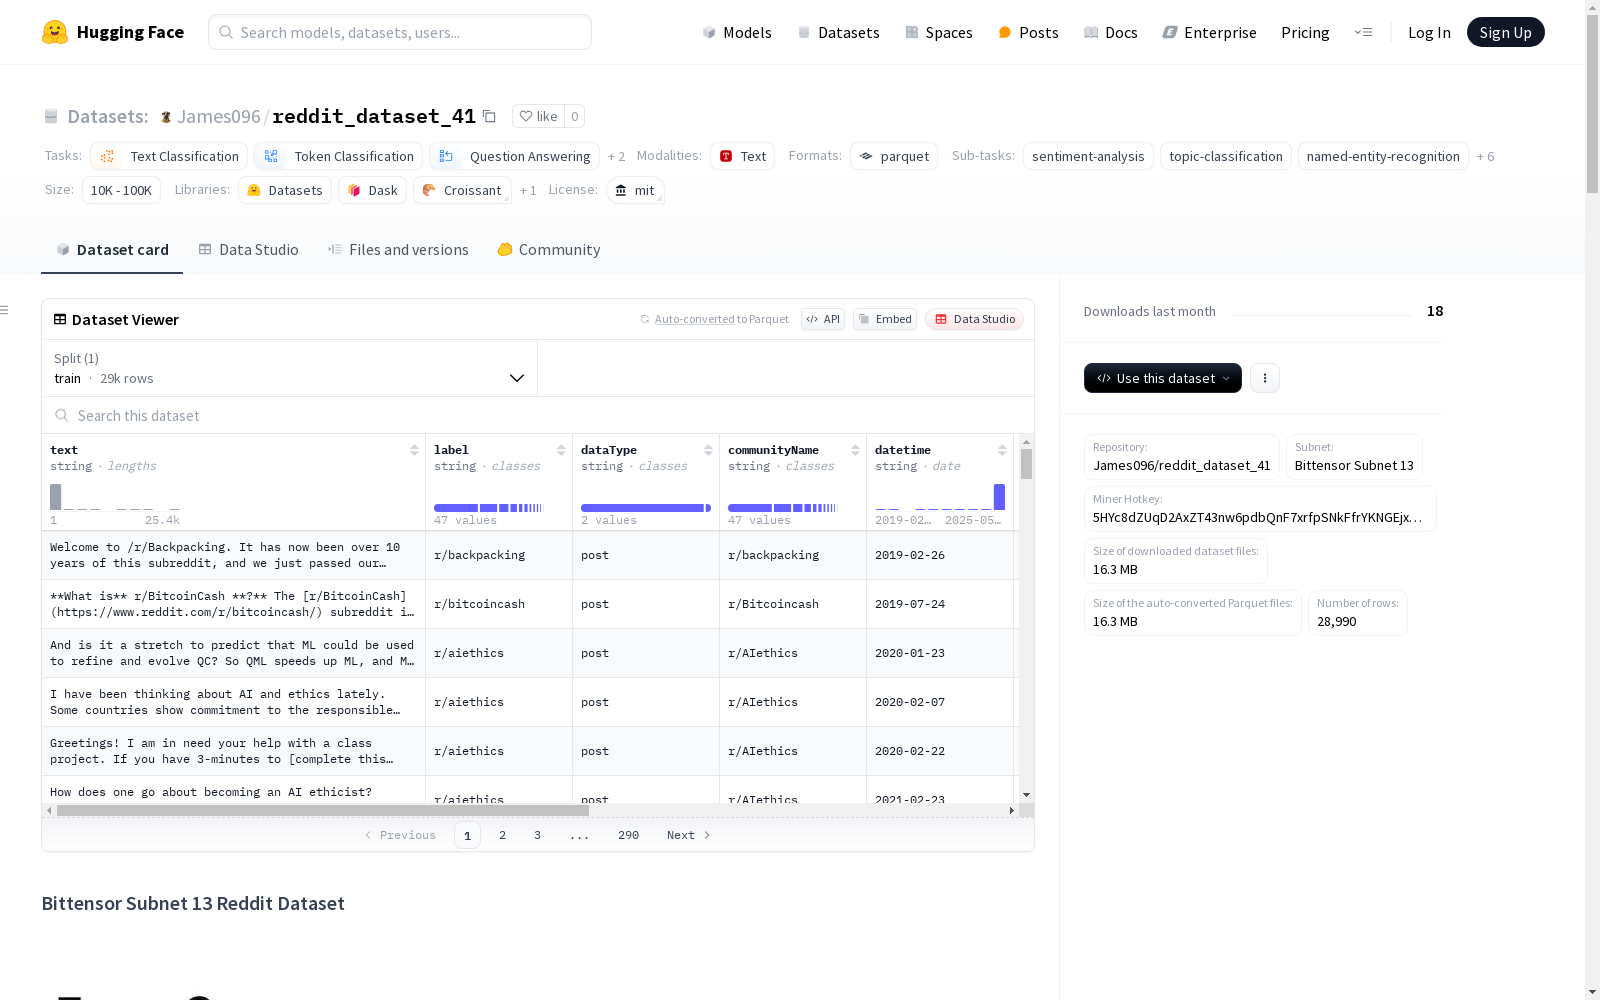
Bittensor Subnet 13 Reddit 数据集是Bittensor Subnet 13去中心化网络的一部分,包含预处理后的Reddit数据。该数据集由网络矿工持续更新,为各种分析和机器学习任务提供实时的Reddit内容流。数据集支持多种任务,例如情感分析、主题建模、社区分析和内容分类。数据集主要是英文,但由于去中心化的创建方式,也可能是多语言的。每个数据实例代表一个Reddit帖子或评论,包含文本内容、标签、数据类型、社区名称、日期时间、编码后的用户名和URL等字段。数据集不断更新,没有固定的拆分,用户应根据需求和数据的时间戳创建自己的拆分。
The Bittensor Subnet 13 Reddit Dataset is part of the decentralized Bittensor Subnet 13 network, containing preprocessed Reddit data. This dataset is continuously updated by network miners, providing a real-time Reddit content stream for a variety of analytical and machine learning tasks. It supports a wide range of applications including sentiment analysis, topic modeling, community analysis, and content classification. While the dataset is primarily in English, it may also be multilingual due to its decentralized creation process. Each data instance represents a Reddit post or comment, and includes fields such as text content, labels, data type, community name, datetime, encoded usernames, and URLs. The dataset is updated continuously with no fixed splits; users should create their own data splits based on their specific needs and the timestamps of the data.
数据集概述
基本信息
- 数据集名称: Bittensor Subnet 13 Reddit Dataset
- 仓库地址: James096/reddit_dataset_41
- 许可证: MIT
- 多语言支持: 多语言(主要为英语)
- 来源数据集: 原始数据
数据集描述
- 所属子网: Bittensor Subnet 13
- 矿工热键: 5HYc8dZUqD2AxZT43nw6pdbQnF7xrfpSNkFfrYKNGEjxg242
- 数据集摘要: 包含预处理的Reddit数据,持续更新,用于分析和机器学习任务。
任务支持
- 任务类别:
- 文本分类
- 令牌分类
- 问答
- 摘要
- 文本生成
- 具体任务:
- 情感分析
- 主题分类
- 命名实体识别
- 语言建模
- 文本评分
- 多类分类
- 多标签分类
- 提取式问答
- 新闻文章摘要
数据集结构
- 数据实例: 每个实例代表一个Reddit帖子或评论。
- 数据字段:
text: 内容文本label: 情感或主题类别dataType: 帖子或评论communityName: 子版块名称datetime: 发布时间username_encoded: 编码用户名url_encoded: 编码URL
数据集统计
- 总实例数: 28990
- 日期范围: 2019-02-26T00:00:00Z 至 2025-05-05T00:00:00Z
- 最后更新时间: 2025-05-05T13:29:13Z
- 数据分布:
- 帖子: 5.46%
- 评论: 94.54%
数据来源与隐私
- 来源数据: 公开的Reddit帖子和评论。
- 隐私保护: 用户名和URL编码处理。
使用注意事项
- 社会影响与偏见: 可能存在Reddit数据的固有偏见。
- 局限性:
- 数据质量不一
- 可能包含噪声或垃圾内容
- 时间偏差
- 仅限公共子版块
引用信息
bibtex @misc{James0962025datauniversereddit_dataset_41, title={The Data Universe Datasets: The finest collection of social media data the web has to offer}, author={James096}, year={2025}, url={https://huggingface.co/datasets/James096/reddit_dataset_41}, }
贡献与更新
- 贡献方式: 通过矿工或Bittensor Subnet 13治理机制报告问题或贡献。
- 更新历史:
- 2025-05-04T19:06:54Z: 新增4059实例
- 2025-05-05T13:29:13Z: 新增24931实例