
遇见数据集

himalaya-ai/nepalipixel-synthetic-ocr-benchmark

收藏
Hugging Face2026-07-09 更新2026-07-22 收录
官方服务:

资源简介:

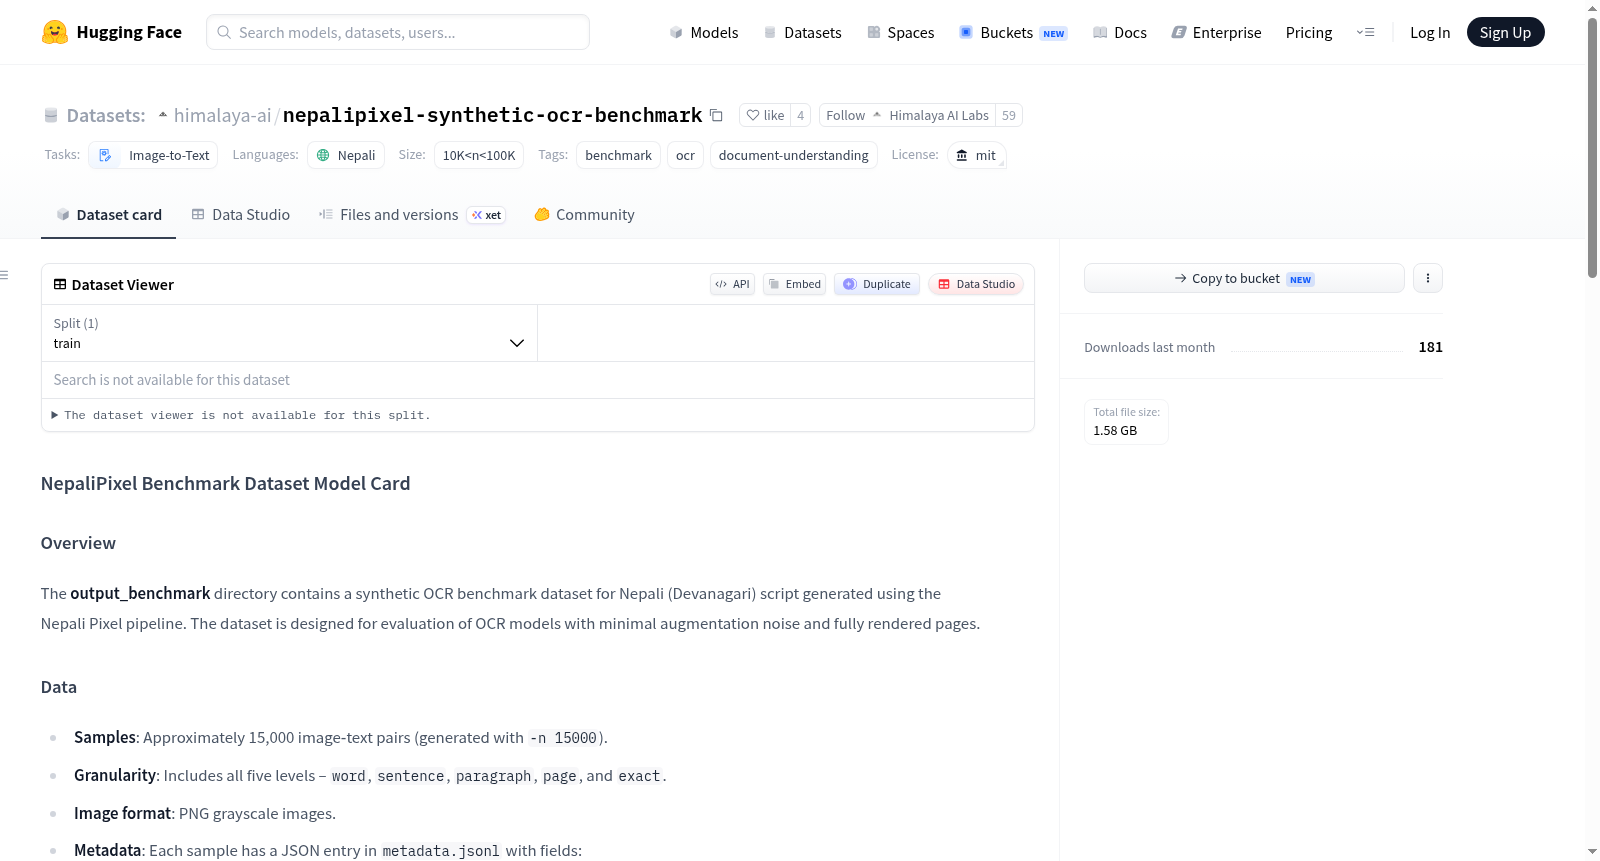
output_benchmark目录包含一个使用Nepali Pixel流水线生成的尼泊尔语(天城文)脚本的合成OCR基准数据集。该数据集设计用于评估OCR模型,具有最小的增强噪声和完全渲染的页面。数据集包括约15,000个图像-文本对,覆盖五个粒度级别:单词、句子、段落、页面和精确级别。图像格式为PNG灰度图,每个样本在metadata.jsonl中都有JSON条目,包含id、image_path、text、level、font_name、size_px、augmentations、intensity、source、image_w和image_h等字段。数据源为himalaya-ai/cc100-nepali,生成时使用benchmark模式以避免激进增强和裁剪,确保干净的基准图像。

The output_benchmark directory houses a synthetic OCR benchmark dataset of Nepali (Devanagari script) generated via the Nepali Pixel pipeline. This dataset is engineered for OCR model evaluation, featuring minimal augmented noise and fully rendered pages. It contains roughly 15,000 image-text pairs spanning five granularity tiers: word, sentence, paragraph, page, and exact level. All images are in PNG grayscale format, and each sample has a corresponding JSON entry in metadata.jsonl, including fields such as id, image_path, text, level, font_name, size_px, augmentations, intensity, source, image_w, and image_h. The data source is himalaya-ai/cc100-nepali, and the dataset was generated in benchmark mode to avoid aggressive augmentation and cropping, ensuring clean benchmark images.
提供机构:
himalaya-ai
搜集汇总
数据集介绍
himalaya-ai/nepalipixel-synthetic-ocr-benchmark 数据集图片
构建方式
NepaliPixel-synthetic-ocr-benchmark数据集基于Nepali Pixel合成管道构建,以himalaya-ai/cc100-nepali扁平文本数据集为语料来源,通过指定生成规模为15000个样本的命令行参数,并启用--benchmark模式以禁用激进的数据增强并扩展页面画布,从而生成干净且无裁剪的基准图像。数据集覆盖了单词、句子、段落、页面和精确文本五个粒度级别,每一图像均为PNG灰度格式,并配有详尽的JSON元数据文件,记录样本的唯一标识、图像路径、文本内容、级别、字体名称、字号、增强策略与强度、来源及图像尺寸等信息。
使用方法
本数据集适用于视觉语言模型在尼泊尔语光学字符识别任务中的评估与基准测试,可作为模型在合成训练数据上的基线对比工具,也可用于微调过程中的验证环节。使用时,用户可通过解析metadata.jsonl文件获取样本的元信息,并依据level字段筛选所需粒度的图像-文本对,或根据font_name、size_px等字段设计定制化评估策略。图像与元数据配套存储于output_benchmark目录下,便于直接加载与批量处理,满足从快速跑分到深入分析的多层次需求。
背景与挑战
背景概述
光学字符识别(OCR)技术作为文档数字化与自然语言处理的基础工具,在低资源语言场景下长期面临数据匮乏的困境。尼泊尔语(天城文)作为全球使用人数超过两千万的语言,其印刷体识别研究因缺乏大规模、高质量且标准化的评测数据集而进展缓慢。在此背景下,NepaliPixel-synthetic-ocr-benchmark数据集于2023年由研究团队基于CC-100尼泊尔语语料库构建,核心目标是为尼泊尔语OCR模型提供可靠的评估基准。该数据集通过Nepali Pixel合成管道生成了约15000对图像-文本样本,覆盖单词、句子、段落、页面及精确匹配五种粒度,并采用最小化增强噪声的策略确保图像的真实性与可用性。其发布填补了尼泊尔语OCR基准测试的空白,为多模态大模型在该语言上的性能验证与对比分析提供了标准化参照,推动了低资源语言文档理解技术的发展。
当前挑战
该数据集主要应对两大方面的挑战。在领域问题层面,尼泊尔语OCR面临天城文字符结构复杂、连字组合多样及字体形态差异显著等固有难点,现有模型常因训练数据不足而在真实场景中表现不佳,数据集的构建旨在提供清洁、可复现的评测环境,以准确诊断模型在文本粒度、字体泛化等维度上的能力短板。在构建过程中,团队面临的挑战包括从CC-100语料库中筛选与排版适宜尼泊尔语的平面文本,设计兼顾多样性(五种粒度、多种字体与字号)与可控性(抑制过度增广以避免字符变形)的生成参数,以及确保合成图像与真实文档在视觉语义上的一致性,从而避免评测偏差。
常用场景
经典使用场景
NepaliPixel-synthetic-ocr-benchmark数据集专为评估尼泊尔语(天城文)光学字符识别(OCR)模型的性能而设计。其经典使用场景聚焦于跨细粒度级别的文本识别任务,涵盖单词、句子、段落、页面及精确文本五个层级,为研究者提供了从微观到宏观的全面评估框架。通过生成约15,000对干净、低噪声的图像-文本对,该数据集能够有效衡量模型在不同文本结构下的识别准确率与泛化能力,尤其适用于对比不同OCR架构或视觉语言模型(VLM)在尼泊尔语上的基线表现,为后续模型选型与优化提供可靠基准。
解决学术问题
该数据集解决了尼泊尔语OCR领域缺乏标准化、公开评估基准的学术难题。长期以来,天城文字符识别研究受限于数据稀缺和评价指标不统一,导致模型间比较缺乏公信力。NepaliPixel Benchmark通过提供细粒度、低噪声的合成数据,使得研究者能够精确测量模型在单词、句子等多层级上的差错率,从而识别出模型在字符级、词汇级或语境理解上的薄弱环节。这推动了尼泊尔语文档理解领域的可复现研究,并为低资源语言下的OCR技术评估树立了新范式,具有推动多语言人工智能公平发展的深远意义。
实际应用
在实际应用中,该数据集主要服务于尼泊尔语文档数字化系统的性能评测与迭代。例如,企业或政府机构在部署尼泊尔语OCR服务前,可利用此基准测试验证模型对印刷体文本的识别稳健性,包括不同字体、字号和背景下的表现。此外,数据集中的元数据(如字体名称、增强强度)允许开发者针对特定场景(如古籍扫描件或现代印刷品)进行定制化调优。它还可作为教育工具,用于培训尼泊尔语自然语言处理人才,帮助理解OCR系统的局限性,从而在自动化办公、文化遗产数字化及多语言信息检索中发挥实际价值。
数据集最近研究
最新研究方向
当前,该领域的前沿研究正聚焦于低资源语言的OCR能力提升,尤其是像尼泊尔语这类采用天城文(Devanagari)的复杂文字系统。NepaliPixel-synthetic-ocr-benchmark的提出,正是为了填补尼泊尔语OCR评估基准的空白。该数据集通过合成流水线生成了涵盖词、句、段、页及精确对齐的五级粒度、约1.5万对图像-文本样本,并采用最小增强噪声的策略以确保真实标注质量,为多模态大模型在尼泊尔文字识别任务上的表现提供了标准化的验证平台。这一成果紧密关联到全球数字包容性热点——随着AI技术普及,诸多此前被边缘化的语言正借力大型语料库与合成数据方法实现文本数字化突破。该基准的发布不仅能够推动尼泊尔语OCR模型的公平比较与快速迭代,也为其他低资源语言的类似研究工作树立了可复现的范式,在促进文化传承与信息无障碍获取方面具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

