
遇见数据集

exolabs/terminal-bench-2-hermes-eval-data

收藏
Hugging Face2026-06-04 更新2026-06-14 收录
官方服务:

资源简介:

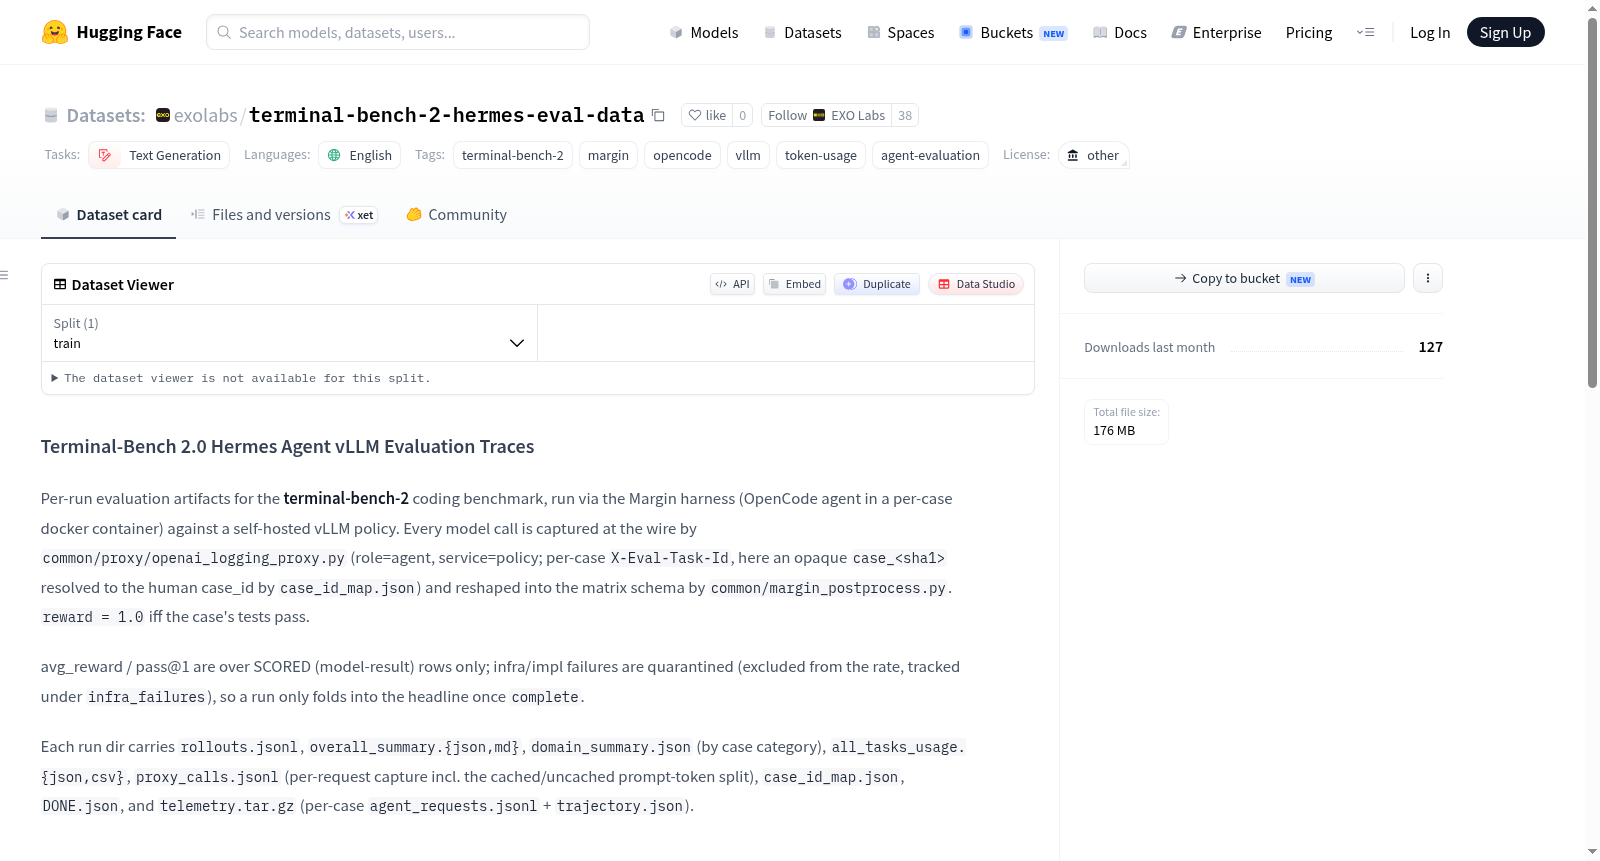
该数据集包含Terminal-Bench 2.0编码基准的每运行评估工件,通过Margin harness(在每案例docker容器中的OpenCode代理)针对自托管的vLLM策略运行生成。每个模型调用都被捕获并重塑为矩阵模式,其中reward = 1.0当且仅当案例的测试通过。avg_reward / pass@1仅基于SCORED(模型结果)行计算;基础设施/实现失败被隔离(从率中排除,在infra_failures下跟踪),因此运行仅在complete时计入头条。每个运行目录包含rollouts.jsonl、overall_summary.{json,md}、domain_summary.json(按案例类别)、all_tasks_usage.{json,csv}、proxy_calls.jsonl(每请求捕获,包括缓存/未缓存的提示令牌分割)、case_id_map.json、DONE.json和telemetry.tar.gz(每案例的agent_requests.jsonl + trajectory.json)。数据集主要用于评估模型在终端编码任务中的性能,包括奖励、通过率和令牌使用情况。

This dataset contains per-run evaluation artifacts of the Terminal-Bench 2.0 coding benchmark, generated via the Margin harness (the OpenCode agent operating within per-case Docker containers) against self-hosted vLLM policies. Every model invocation is captured and reshaped into a matrix format, where reward = 1.0 if and only if the test case passes. avg_reward and pass@1 are calculated exclusively based on the SCORED (model outcome) rows; infrastructure/implementation failures are isolated (excluded from the evaluation metrics and tracked under infra_failures), so runs are only counted toward headline metrics when they are complete. Each run directory contains rollouts.jsonl, overall_summary.{json,md}, domain_summary.json (grouped by case category), all_tasks_usage.{json,csv}, proxy_calls.jsonl (captured per request, including cached/uncached prompt token splits), case_id_map.json, DONE.json, and telemetry.tar.gz, which holds agent_requests.jsonl and trajectory.json for each individual case. This dataset is primarily used to evaluate model performance on terminal coding tasks, including rewards, pass rates, and token usage.
提供机构:
exolabs
搜集汇总
数据集介绍
exolabs/terminal-bench-2-hermes-eval-data 数据集图片
构建方式
终端基准测试2.0(Terminal-Bench 2.0)是一个面向编程任务的智能体评估基准,本数据集则记录了Hermes Agent在自部署vLLM策略下,通过Margin框架(OpenCode智能体在独立的Docker容器中运行)进行评测时所产生的完整轨迹。所有模型调用经由`common/proxy/openai_logging_proxy.py`代理捕获,按`X-Eval-Task-Id`标识符归类,并通过`common/margin_postprocess.py`脚本重塑为统一的矩阵格式。每个运行目录包含`rollouts.jsonl`、`overall_summary.{json,md}`、`domain_summary.json`等多类文件,完整再现评测过程中的请求、轨迹与令牌消耗细节。
特点
本数据集具备高颗粒度的结构特性,不仅提供基于任务是否通过测试的奖励信号(reward=1.0表示通过),还细致分离了基础架构失败与模型推理失败,确保评估结果的纯净性。此外,数据集中收纳了MTP(多令牌预测)草案令牌的按位置接受率、智能体侧的令牌使用统计(含缓存与非拆解、非缓存拆解),以及缓存命中率等关键指标,使得对模型推理效率与生成质量的联合分析成为可能。
使用方法
用户可通过加载`rollouts.jsonl`文件获取每轮评测的完整对话与中间状态,利用`overall_summary.json`快速获取全局聚合指标(如平均奖励、pass@1等),或借助`domain_summary.json`按任务类别进行细粒度分析。`proxy_calls.jsonl`与`telemetry.tar.gz`则提供了从原始请求到智能体决策轨迹的完整链路,适用于深度解析智能体行为模式。建议结合`case_id_map.json`将匿名案例标识映射至原始任务ID,以进行跨版本或跨系统的对比研究。
背景与挑战
背景概述
Terminal-Bench 2.0 Hermes Agent vLLM Evaluation Traces数据集由Margin团队开发,专注于评估代码生成代理在终端环境中的任务完成能力。该数据集创建于2025年,旨在通过自托管的vLLM策略,在每案例Docker容器中运行OpenCode代理,系统性地捕获模型调用、token消耗及轨迹信息。其核心研究问题围绕代理在复杂编程任务中的成功率(pass@1)与奖励机制(reward),并提供了详尽的评估矩阵,包括平均奖励、中位数奖励及失败案例统计。该数据集不仅引入了MTP草案令牌接受率等前沿指标,还通过标准化的评估流程(如proxy_calls.jsonl与telemetry.tar.gz)推动了代码代理的可复现性研究,对代理基准测试领域产生了重要影响,为模型性能的细粒度分析提供了公共资源。
当前挑战
该数据集面临的挑战包括:1) 领域问题层面,代码代理在终端环境中执行的复杂性远超传统文本生成任务,需处理多步骤依赖、环境状态变化及测试用例的严格匹配,导致准确评估成为难题,且当前模型在pass@1上表现趋近于零(如qwen3.6-35b-a3b-awq-4bit得分为0),凸显了代理在真实编程场景中的低成功率与泛化瓶颈。2) 构建过程中,评估数据的收集需解决基础架构故障(如infra_failures需隔离)与每次运行缓存token占比波动(最高达97.4%)对一致性的影响,同时确保每案例的代理请求轨迹(trajectory.json)与测试奖励的精准对齐,在万级token消耗下维持元数据完整性与可复现性,这些都对数据清洗与标准化流程提出了严苛要求。
常用场景
经典使用场景
在代码生成与智能体评估的交叉领域中,Terminal-Bench 2.0 Hermes Agent vLLM Evaluation Traces 数据集为研究基于大语言模型的编程代理提供了标准化评测基准。其经典使用场景在于,研究人员利用Margin框架在隔离的Docker容器中运行OpenCode代理,针对终端环境下的编程任务进行端到端测试,并通过记录的奖励信号(reward=1.0表示测试通过)量化模型性能。该数据集所包含的逐次调用日志、轨迹文件和令牌使用情况,使得评估不仅限于最终得分,更能深入分析代理的中间决策过程和推理效率。对于构建和优化具备终端交互能力的编码助手而言,这一基准是不可或缺的验证工具。
解决学术问题
该数据集精准回应了当前学术界在评估编程代理时面临的三大关键问题:如何确保评估结果的可重复性、如何区分模型能力与基础设施故障,以及如何细致刻画令牌消耗对推理效率的影响。通过记录每个分支的奖励、中位数收益和零分案例,研究人员能够识别特定模型在复杂任务中的鲁棒性缺陷。此外,区分缓存在场与未缓存的提示令牌,为研究注意力缓存的优化策略提供了实证数据基础,从而推动高效推理和模型压缩方向的学术探索。它使得从单一准确率评估转向多维度的效率与稳定性分析成为可能。
衍生相关工作
该数据集衍生了一系列围绕高效代码代理和推理加速的前沿工作。围绕其记录的代理轨迹,学术界进一步开发了针对编程任务的多步骤奖励建模方法,并探索了利用罕见失败案例进行对抗训练的策略。另一方面,令牌消耗的细粒度和缓存效率的报告,激发了关于增强型KV缓存管理与模型架构协同设计的研究,比如将注意力头压缩与多令牌预测结合以提升吞吐量。此外,该数据集的框架本身被复用作为构建跨领域终端任务基准的模板,促进了从代码生成到运维自动化等更广泛智能体评估标准的形成。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

