
遇见数据集

Text-Prompted Image Perceptual Similarity (TPIPS) dataset

收藏
arXiv2026-07-21 更新2026-07-22 收录
数据链接:
官方服务:

资源简介:

TPIPS数据集是由卡内基梅隆大学、阿多比研究院及加州大学伯克利分校联合构建的大规模人类视觉相似性标注数据集,旨在解决传统感知相似性度量无法捕捉上下文依赖性的问题。该数据集包含约2.5万张图像三元组,通过文本到图像模型生成具有细粒度变化的图像,并收集了超过100万条人类标注,覆盖26万组三元组-视觉条件组合,每个三元组均在多个自由形式的语义方面(如颜色、纹理、光照)进行标注。数据创建过程采用合成生成与人工标注相结合的方法,首先生成具有挑战性的图像三元组,然后通过众包平台收集人类在特定文本提示下的相似性判断。该数据集主要应用于训练和评估文本条件化的视觉相似性模型,支持生成模型评估、文本引导检索和组合搜索等任务,为多维度视觉相似性研究提供了基准。

The TPIPS Dataset is a large-scale human visual similarity annotation dataset jointly constructed by Carnegie Mellon University, Adobe Research, and the University of California, Berkeley, aiming to address the problem that traditional perceptual similarity metrics fail to capture contextual dependencies. It contains approximately 25,000 image triplets generated via text-to-image models with fine-grained variations, and collects over 1 million human annotations covering 260,000 triplet-visual condition pairs. Each triplet is annotated across multiple free-form semantic aspects such as color, texture, and lighting. The dataset creation process adopts a hybrid method combining synthetic generation and manual annotation: first, challenging image triplets are generated, then human similarity judgments under specific text prompts are collected through crowdsourcing platforms. This dataset is primarily used for training and evaluating text-conditioned visual similarity models, supporting tasks including generative model evaluation, text-guided retrieval, and combinatorial search, thus providing a benchmark for multi-dimensional visual similarity research.

创建时间:
2026-07-21
搜集汇总
数据集介绍
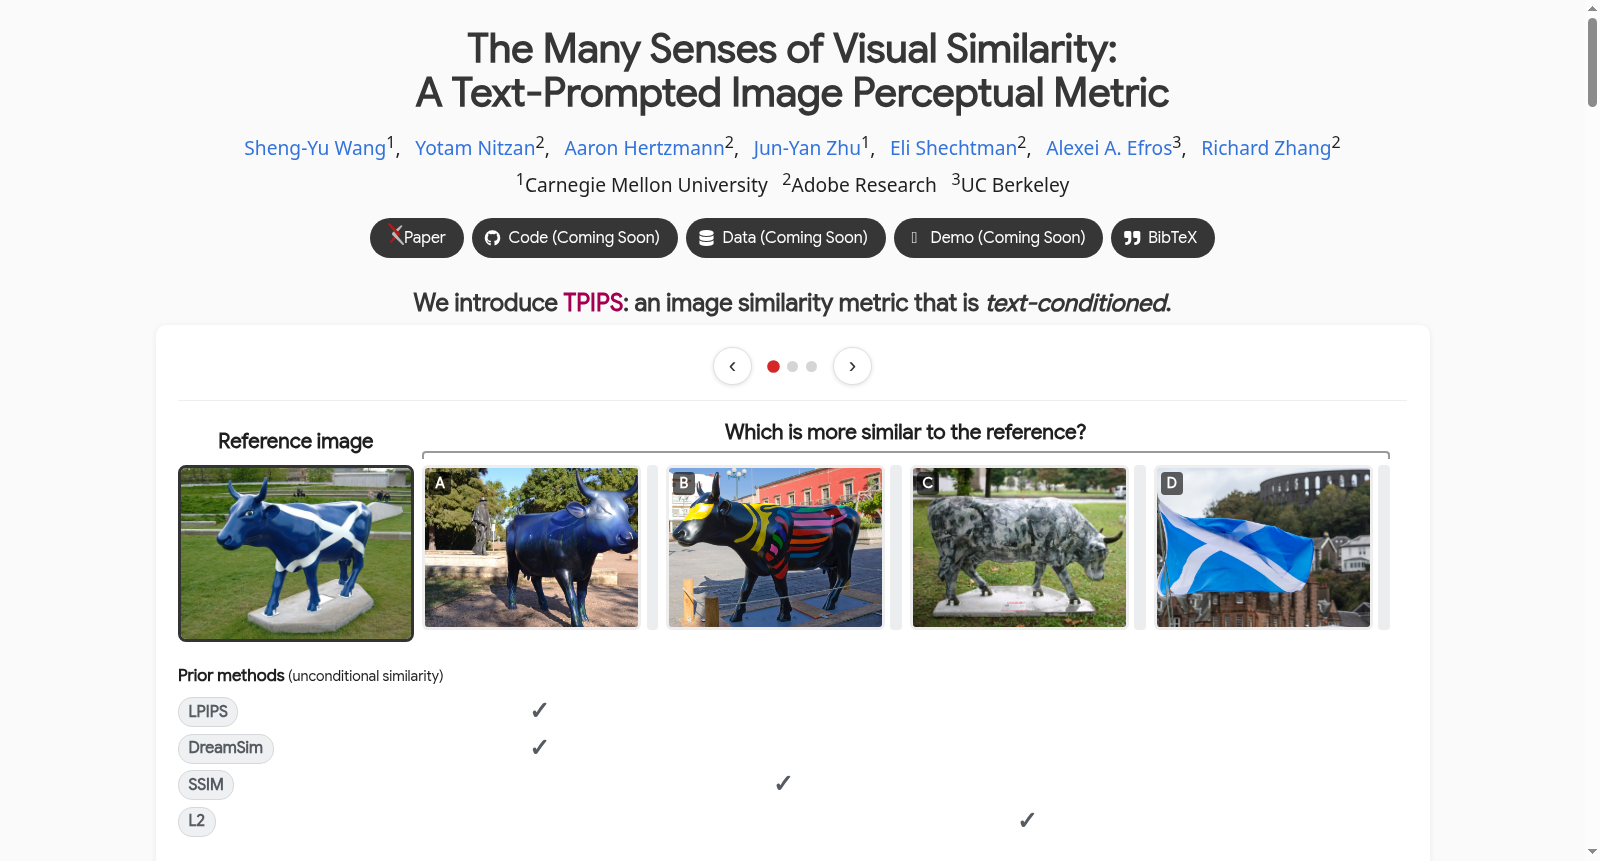
Text-Prompted Image Perceptual Similarity (TPIPS) dataset 数据集图片
构建方式
TPIPS数据集的构建基于海量人类相似性判断的收集。研究团队采用三元组(triplet)范式,通过文本到图像模型生成约25,000个图像三元组,每个三元组与多个自由形式的视觉属性注释配对,最终积累超过一百万条人类判断。首先,利用语言模型生成可控的图像变化,确保三元组在颜色、光照、纹理等多个属性上具有差异但又非过于显著。随后,设计众包任务让标注者针对每个属性挑选出最不相似的异常图像,同时提供“无法判断”选项以筛选模糊属性。为评估模型的泛化能力,还构建了一个包含图像编辑、合成、新视角合成和单图像3D重建四种计算机视觉算法输出的独立测试集。
特点
该数据集的显著特点在于其条件感知的精细粒度。不同于传统将视觉相似性压缩为单一标量的度量方法,TPIPS首次提供了基于自由文本提示的条件化相似性比较,捕捉形状、颜色、姿态、材质等多维度的语义差异。数据集由两大子集构成:大规模合成三元组用于训练,以及来自真实计算机视觉算法输出的分布外测试集用于验证泛化性。每个三元组平均包含约十个视觉属性的注释,且通过“无法判断”筛选与多人投票机制确保了标注的可靠性。这种设计使模型能够学习到与人类感知高度对齐的、可区分的多维度相似性表征。
使用方法
TPIPS数据集的核心用途是训练和评估文本条件化的图像感知相似性度量。用户可通过指定自由形式的文本提示(如“object color”、“camera pose”)来条件化相似性判断,从而在多种属性上获得精准对齐人类感知的相似性分数。该数据集支持三种架构的训练:晚期融合(独立编码后计算余弦相似度)、中期融合(比较深度特征激活差异)和早期融合(双图联合注意力)。基于此数据集微调的VLM模型可直接应用于文本引导的图像检索、组合式查询搜索(通过加权融合多属性相似性分数)以及生成模型的细粒度评估,提供超越传统单一标量度量的语义可控性。
背景与挑战
背景概述
人类视觉相似性判断具有显著的上下文依赖性,同一对图像可能因关注维度(如形状、颜色、纹理)不同而呈现迥异的相似性结论。然而,既有感知相似性度量方法将多重语义维度压缩为单一标量,无法依据特定方面进行条件化判断。为填补这一关键空白,由卡内基梅隆大学、Adobe研究院与加州大学伯克利分校的研究人员于2026年联合构建了Text-Prompted Image Perceptual Similarity(TPIPS)数据集。该数据集包含超过100万条人类相似性判断标注,覆盖25,000个图像三元组及260,000个三元组-方面条件组合,每个三元组在多个自由形式的视觉方面下分别获得标注。该数据集通过文本到图像模型生成具有挑战性的三元组,旨在捕捉颜色、姿态、背景等多维度上的精细差异,为条件化视觉相似性研究奠定了大规模基准,推动了视觉语言模型在细粒度感知对齐领域的发展。
当前挑战
当前领域面临的核心挑战在于视觉相似性本身的多义性与上下文依赖性:传统度量方法无法根据指定语义方面(如形状、颜色、光照)进行条件化判断,导致相似性结果与人类感知存在显著偏差。数据集构建过程中亦面临诸多困难:首先,需生成难度适中的三元组——差异过于细微则人类无法可靠判断,差异过大则退化为普通相似性任务;其次,需确保三元组内图像沿多个独立文本条件方面同时变化,以引发多维度推理;再次,文本到图像映射的非保真性导致生成图像与提示词不完全对应,需借助视觉语言模型进行方面提议与精炼;此外,需设计高效的大规模众包标注流程,包含“无法判断”选项过滤、质量校验等机制,最终构建了包含22,157个训练三元组及1,127个分布外评估样本的高质量数据集。
常用场景
经典使用场景
TPIPS数据集的经典使用场景在于评估和训练文本引导的图像感知相似性度量。研究者可以利用该数据集中的图像三元组与多维度自由文本方面标注,来构建能够根据指定视觉属性(如颜色、纹理、姿态或光照)进行条件化相似性判断的模型。这一场景突破了传统单一标量相似性度量的局限,使得模型能够捕捉人类视觉判断中固有的上下文依赖性,为图像感知研究提供了更加细腻和灵活的评价基准。
解决学术问题
该数据集解决了视觉相似性研究中长期存在的多义性问题——即两幅图像在不同方面可能既相似又不同,而传统度量无法区分这些细微差异。TPIPS通过收集超过一百万条人类在三元组上的条件化相似性判断,为学术界提供了一个标准化的验证框架,使得研究者能够系统性地评估和提升视觉语言模型在指定属性条件下的感知对齐能力,从而推动条件化图像相似性评价理论与方法的进步。
衍生相关工作
围绕TPIPS数据集衍生了一系列重要的工作,包括对生成式视觉模型的细粒度评估,其中输出图像与参考图像在指定视觉轴线上的相似性被量化衡量;此外,基于该数据集的微调方法催生了新的图像编辑模型训练范式,利用人类对齐的感知评分作为反馈信号优化生成结果。这些工作拓展了条件化相似性度量的应用边界,也推动了可解释性研究——通过自动发现并表征神经网络所编码的视觉特征与其感知属性的关联。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

