Fatigue-Face-Dataset
收藏资源简介:
该数据集通过记录参与者在完成心理疲劳诱导任务前后的面部视频创建。参与者为39名中国志愿者(33名女性,6名男性),平均年龄约23岁。使用40分钟的修改版SART任务诱导心理疲劳。标签方法采用瑞典职业疲劳量表-25(SOFI-C)作为主要工具,并结合卡罗林斯卡嗜睡量表(KSS)设定疲劳等级分界点。数据集包含三个疲劳等级:清醒(SOFI-C评分<74)、中度疲劳(74-139)和严重疲劳(≥140)。数据将78个视频转换为静态帧,并按参与者划分训练集(31人,7918张图像)和验证集(8人,2286张图像),确保模型不会记忆特定人脸。
This dataset is constructed from facial videos recorded from participants before and after they completed a mental fatigue induction task. A total of 39 Chinese volunteers (33 females and 6 males) participated, with an average age of approximately 23 years. Mental fatigue was induced using a 40-minute modified version of the SART task. The labeling approach adopted the Swedish Occupational Fatigue Inventory-25 (SOFI-C) as the primary tool, combined with the Karolinska Sleepiness Scale (KSS) to establish the cutoff values for fatigue levels. The dataset contains three fatigue categories: Alert (SOFI-C score <74), Moderate Fatigue (74–139), and Severe Fatigue (≥140). All 78 videos were converted into static frames, and the dataset was split into training set (31 participants, 7918 images) and validation set (8 participants, 2286 images) based on individual participants, to prevent the model from memorizing specific human faces.
数据集概述
数据集名称
Fatigue-Face-Dataset
项目背景
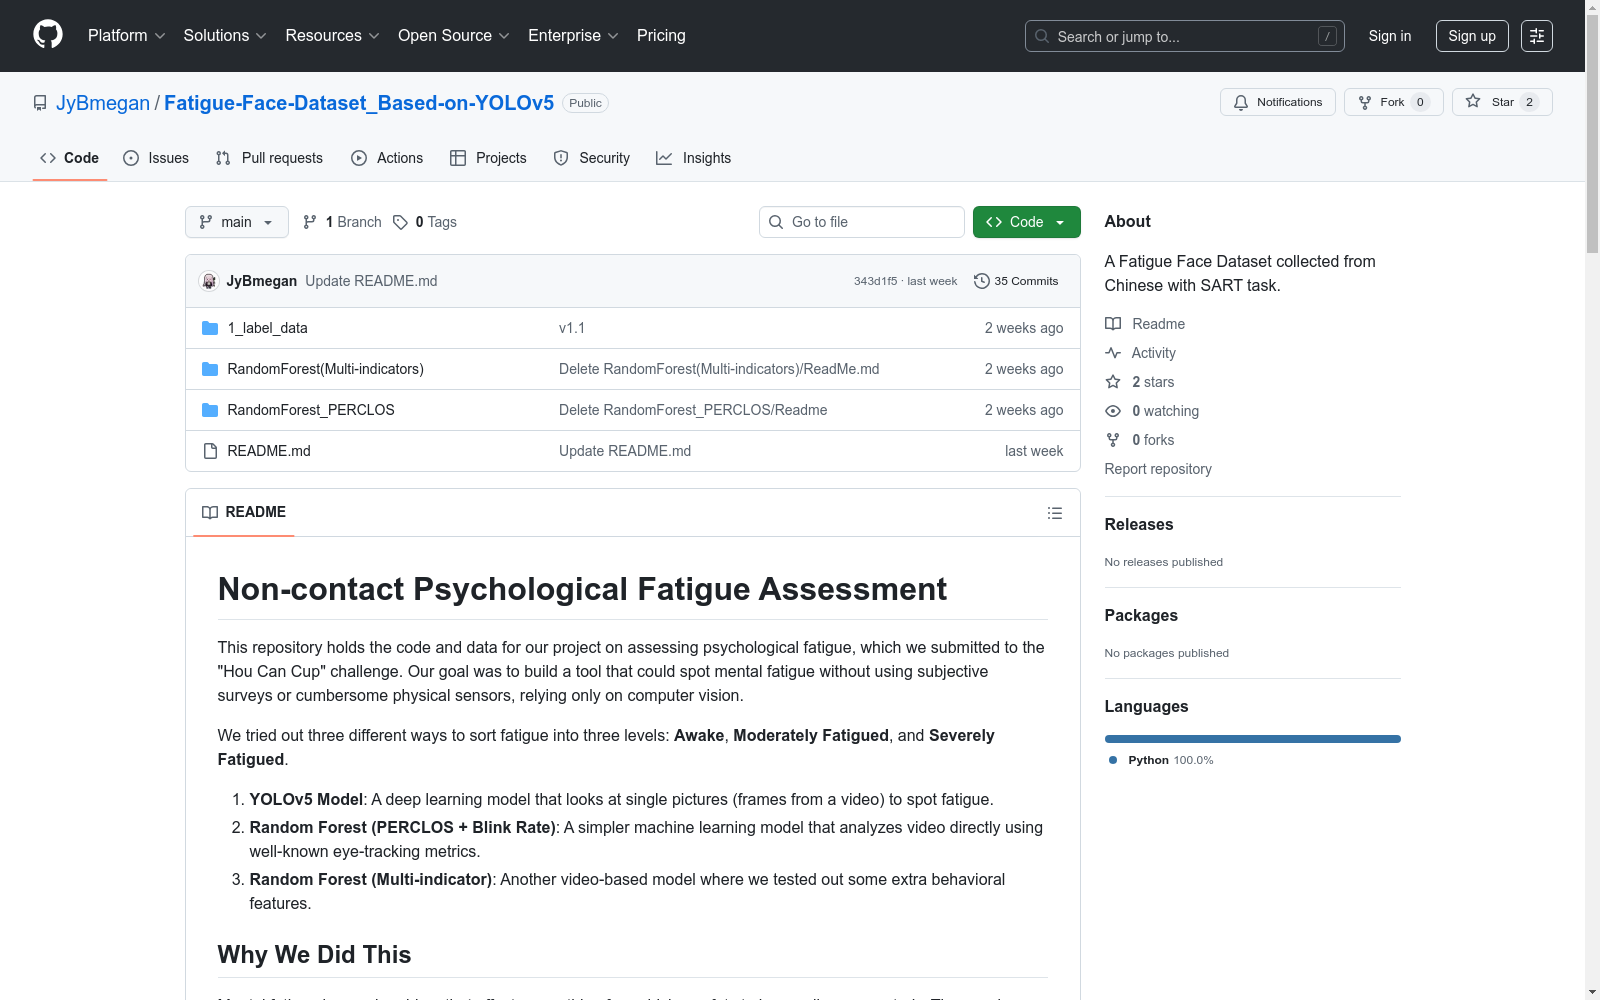
该项目旨在通过计算机视觉技术进行非接触式心理疲劳评估,目标是构建一个无需主观问卷或繁琐物理传感器的工具,仅依赖计算机视觉识别心理疲劳。
数据集构建
- 参与者:39名志愿者(33名女性,6名男性),平均年龄约23岁。
- 疲劳诱导方法:使用40分钟的计算机任务(改进版SART),该任务需要持续专注,已知会导致心理疲劳。
- 标注方法:
- 主要工具:瑞典职业疲劳量表-25(SOFI-C)。
- 辅助工具:卡罗林斯卡嗜睡量表(KSS),用于设定疲劳级别的清晰分界点。
- 疲劳级别划分:
- 清醒:SOFI-C分数 < 74
- 中度疲劳:SOFI-C分数 74 至 139
- 重度疲劳:SOFI-C分数 ≥ 140
- 数据结构:将78段视频转换为静态帧。为确保模型不记忆人脸,数据划分确保同一参与者的图像仅出现在训练集或测试集中。
- 训练集:7,918张图像,来自31名参与者。
- 验证集:2,286张图像,来自其余8名参与者。
数据下载
- 图像数据:https://drive.google.com/drive/folders/1rqwfbrj8Nvu76CV0XmQ6mrHOp6x2gLja?usp=sharing
- 原始标注:https://drive.google.com/drive/folders/1PZ-UIrUja2R1Ei6dK14Xc8lkOEj8jyTo?usp=share_link
- 原始视频:https://drive.google.com/drive/folders/1RU2QeS1u-Ntll0SLTLb5yj92IE54eVok?usp=share_link
模型方法
- YOLOv5模型:基于图像的深度学习模型,通过单张图片(视频帧)检测疲劳。
- 随机森林(PERCLOS + 眨眼频率):基于视频的机器学习模型,使用已知眼动指标(眨眼频率和PERCLOS)。
- 随机森林(多指标):基于视频的实验性模型,添加额外行为特征(平均眨眼持续时间、最大闭合持续时间、眨眼频率变异性)。
模型结果
数据集存在类别不平衡问题(清醒样本远多于重度疲劳样本),影响模型性能。
YOLOv5模型
- 整体准确率:46.70%
- 各类别性能:
- 清醒:精度0.42,召回率1.0,AP@0.5为0.611
- 中度疲劳:精度0.957,召回率0.18,AP@0.5为0.681
- 重度疲劳:精度0.0134,召回率0.00649,AP@0.5为0.11
随机森林(PERCLOS + 眨眼频率)模型
- 整体准确率:46.15%
- 各类别性能:
- 清醒:精度0.62,召回率0.62,F1分数0.62
- 中度疲劳:精度0.33,召回率0.25,F1分数0.29
- 重度疲劳:精度0.00,召回率0.00,F1分数0.00
随机森林(多指标)模型
- 整体准确率:38.46%
- 各类别性能:
- 清醒:精度0.50,召回率0.62,F1分数0.56
- 中度疲劳:精度0.00,召回率0.00,F1分数0.00
- 重度疲劳:精度0.00,召回率0.00,F1分数0.00
致谢
该工作为“厚粲杯”全国大学生心理与认知智能评估挑战赛提交项目。感谢活动组织者和所有参与研究的学生。