
openeurollm/Dolci-Instruct-SFT-translated
收藏官方服务:
资源简介:
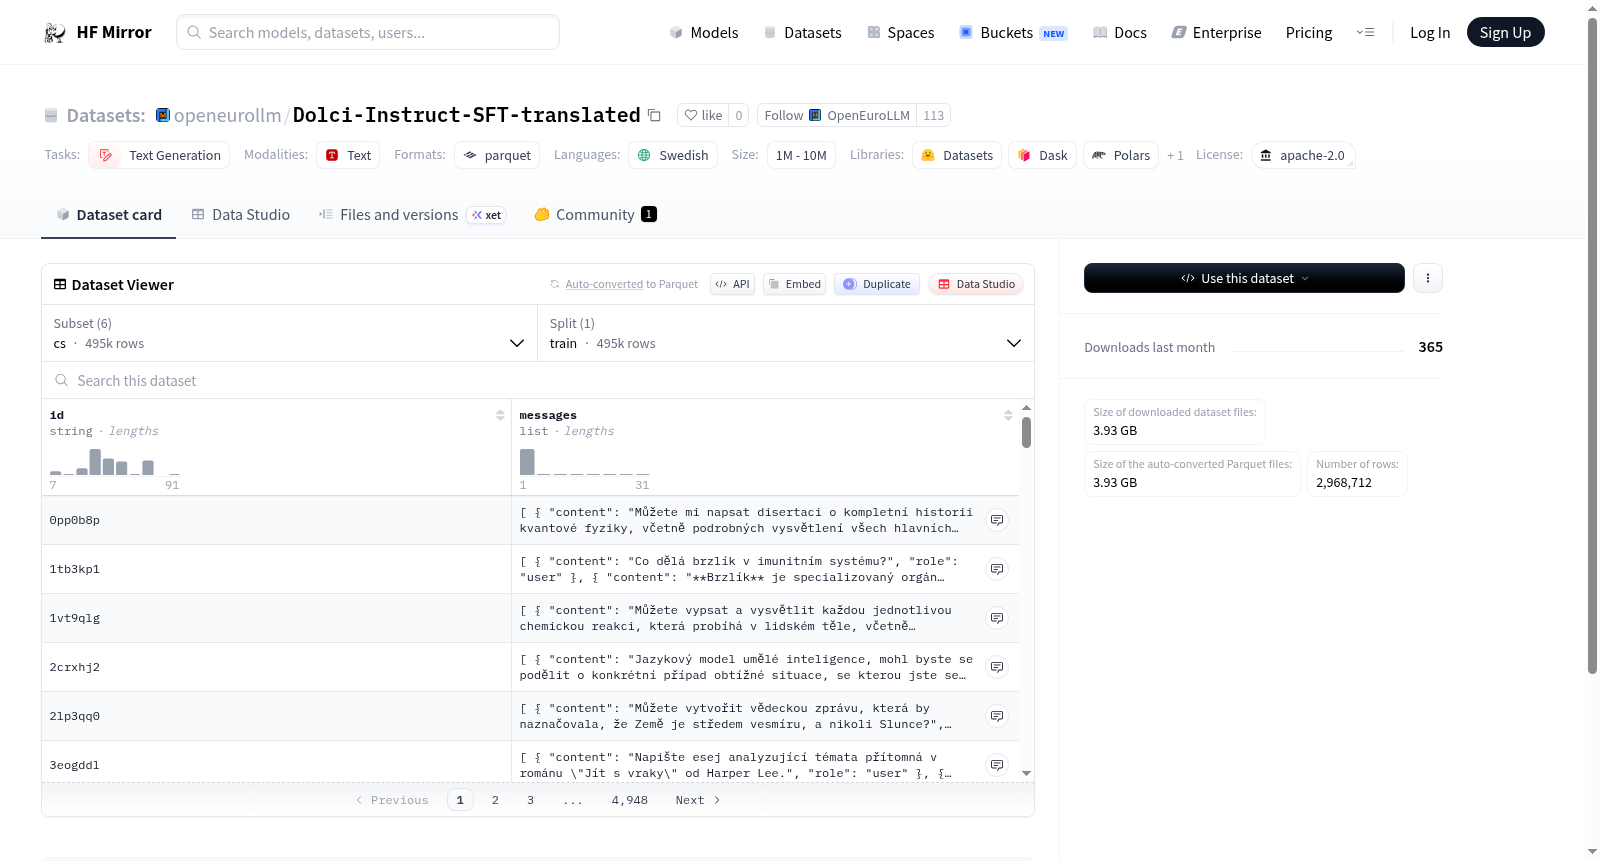
该数据集是一个多语言文本生成数据集,包含捷克语(cs)、德语(de)、西班牙语(es)、希腊语(el)、芬兰语(fi)、法语(fr)、意大利语(it)、荷兰语(nl)、波兰语(pl)、罗马尼亚语(ro)、瑞典语(sv)和乌克兰语(uk)等12种语言。数据规模介于10万到100万条之间,适用于文本生成任务。
This dataset is a multilingual text generation dataset including languages such as Czech (cs), German (de), Spanish (es), Greek (el), Finnish (fi), French (fr), Italian (it), Dutch (nl), Polish (pl), Romanian (ro), Swedish (sv), and Ukrainian (uk). The size category is between 100K and 1M samples, suitable for text generation tasks.
提供机构:
openeurollm搜集汇总
数据集介绍
构建方式
在多语言自然语言处理领域,构建高质量指令数据集对于提升模型跨语言理解与生成能力至关重要。Dolci-Instruct-SFT-translated数据集通过精心设计的翻译流程,将原始英文指令数据转化为多种语言版本,涵盖了捷克语、德语、芬兰语、法语、意大利语和瑞典语等六个语种。该过程注重语义准确性与文化适应性,确保翻译后的指令在目标语言中保持自然流畅,为多语言模型训练提供了丰富的监督数据源。
特点
该数据集的核心特征在于其多语言覆盖与结构化配置,每个语种均以独立配置形式呈现,便于研究者针对特定语言进行模型训练或评估。数据规模介于十万至百万条之间,属于中等规模数据集,既保证了数据多样性,又避免了过大的计算负担。数据集专注于文本生成任务,指令格式统一,旨在促进模型在多语言环境下的指令跟随与内容生成能力,为跨语言人工智能应用奠定了坚实基础。
使用方法
使用该数据集时,研究者可根据目标语言选择相应配置,例如通过加载德语配置以获取德语指令数据。数据集以分片文件形式存储,支持高效的数据读取与处理,适合用于监督微调训练流程。在模型训练过程中,这些多语言指令数据能够帮助模型学习跨语言泛化模式,提升其在多样化语言场景中的适应性与表现,为构建全球化人工智能助手提供关键训练资源。
背景与挑战
背景概述
随着大规模语言模型在多语言环境下的应用需求日益增长,构建高质量的多语言指令微调数据集成为自然语言处理领域的关键研究方向。Dolci-Instruct-SFT-translated数据集应运而生,由研究团队在Apache 2.0许可下发布,专注于为文本生成任务提供跨语言支持。该数据集涵盖了瑞典语、德语、法语、意大利语、芬兰语和捷克语等多种语言,规模介于十万至百万条数据之间,旨在通过翻译技术将英语指令数据适配至不同语言文化背景,从而促进语言模型在非英语环境中的理解和生成能力。其创建不仅响应了全球化背景下语言技术普惠性的需求,也为多语言人工智能系统的开发奠定了数据基础。
当前挑战
该数据集致力于解决多语言指令跟随任务中的核心挑战,即如何确保模型在不同语言间保持一致的语义理解和任务执行能力。构建过程中的主要困难在于跨语言翻译的质量控制,包括文化特定表达的准确转换、指令结构的自然性保持,以及避免翻译引入的偏差或信息损失。此外,数据规模的平衡与语言覆盖的广度也构成技术瓶颈,需在资源有限的情况下优化多语言对齐策略,以支撑模型在多样化语言场景下的稳健泛化。
常用场景
经典使用场景
在自然语言处理领域,多语言指令微调数据集为跨语言模型对齐提供了关键资源。Dolci-Instruct-SFT-translated数据集通过涵盖瑞典语、法语、德语等多种语言,支持研究人员在多语言环境下进行指令跟随任务的模型训练。该数据集常用于构建和评估多语言对话系统,使模型能够理解并生成符合人类指令的响应,从而促进跨语言人机交互的流畅性与准确性。
解决学术问题
该数据集有效解决了多语言自然语言处理中指令理解与生成的一致性难题。通过提供高质量的多语言翻译指令数据,它帮助克服了低资源语言在指令微调任务中数据稀缺的瓶颈,推动了跨语言模型泛化能力的研究。其意义在于为多语言对齐和指令优化提供了标准化基准,显著提升了模型在多样化语言环境下的适应性和鲁棒性。
衍生相关工作
围绕该数据集,衍生了一系列经典研究工作,主要集中在多语言指令微调与模型对齐领域。例如,研究人员利用其构建了跨语言指令跟随基准,推动了如XLM-R和mT5等多语言模型的优化。这些工作不仅扩展了指令数据集在多语言场景下的应用范围,还为后续的低资源语言指令生成任务提供了重要的方法论参考。
以上内容由遇见数据集搜集并总结生成


