Multilingual-USAS-Labelled-Silver-Wikipedia
收藏资源简介:
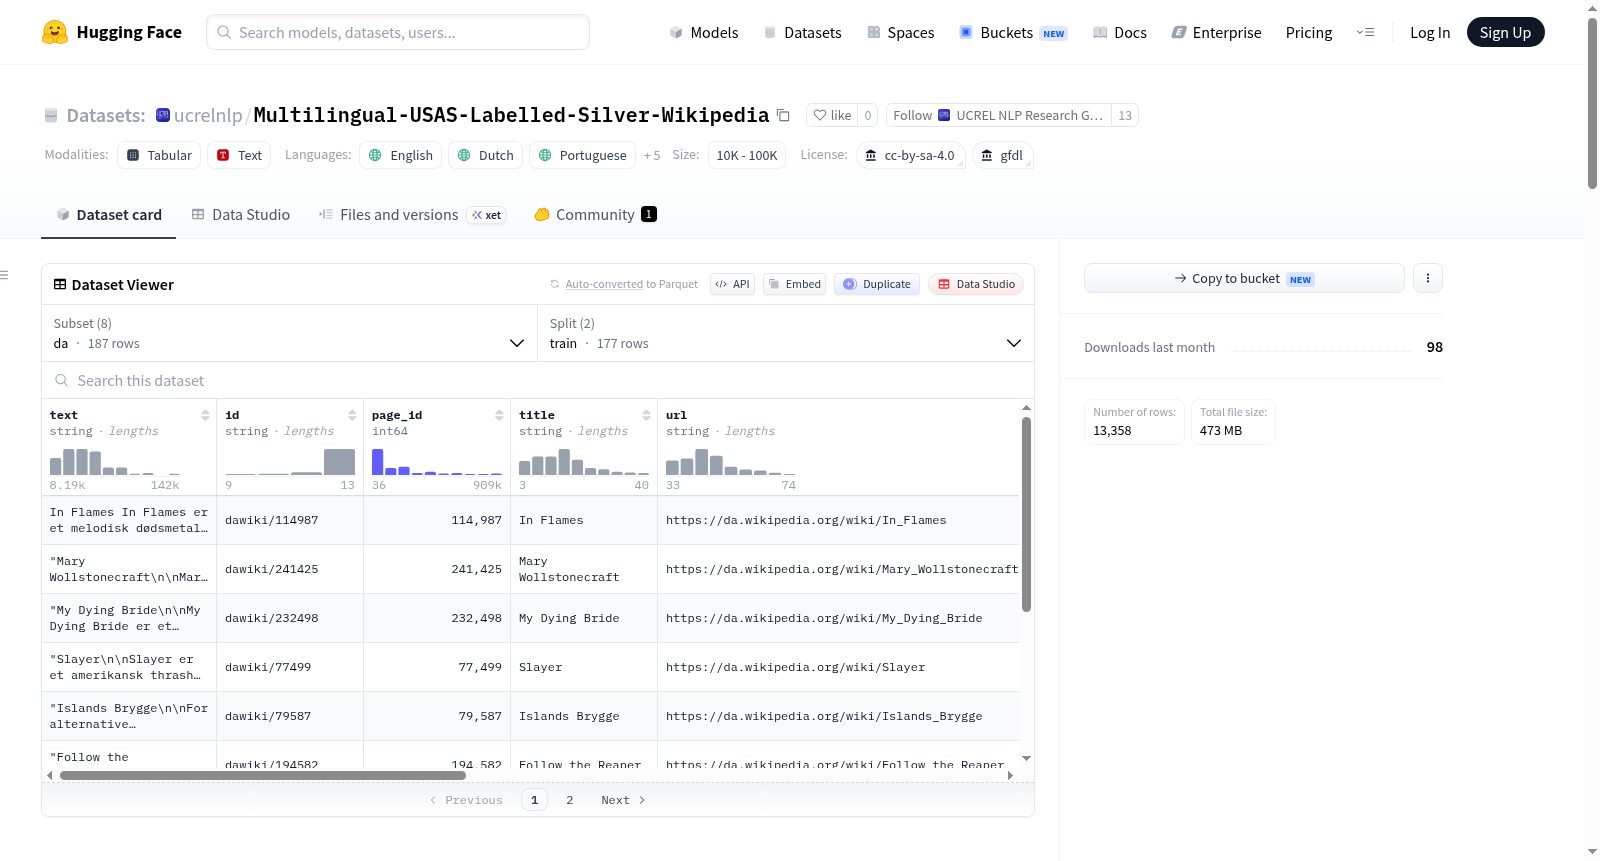
Multilingual USAS Silver Labelled Wikipedia Articles 是一个多语言数据集,覆盖8个维基百科语言站点(英语、荷兰语、葡萄牙语、西班牙语、丹麦语、意大利语、芬兰语和中文)。该数据集旨在用于训练 USAS 语义标签器和多词表达(MWE)识别器。数据来源于 HuggingFaceFW/finewiki,仅选取被评为“优良”(Good)或“特色”(Featured)的文章,经过句子分割后,使用 PyMUSAS 规则标注器自动标注 USAS 语义标签和 MWE。数据集包含约10k至100k个样本,每个语言配置划分为训练集和验证集。每条记录包含以下字段:text(处理后的文章文本)、id(唯一标识符)、page_id(维基百科页面ID)、title(文章标题)、url(文章URL)、version(版本标识)、start_end_sentence_character_indexes(句子字符偏移列表)、tokens(按句子组织的分词列表)、tags(每个词最可能的USAS标签列表)、other_tags(每个词的其他有效USAS标签列表)、mwes(MWE标签列表)。数据以 zstd 压缩的 Parquet 文件存储。许可证为 CC BY-SA 4.0 和 GFDL。
The Multilingual USAS Silver Labelled Wikipedia Articles is a multilingual dataset covering 8 Wikipedia language editions: English, Dutch, Portuguese, Spanish, Danish, Italian, Finnish, and Chinese. This dataset is designed for training USAS semantic taggers and multi-word expression (MWE) recognizers. It is sourced from the HuggingFaceFW/finewiki repository, and only articles rated as "Good" or "Featured" are selected. After sentence segmentation, USAS semantic tags and MWEs are automatically annotated using the PyMUSAS rule-based tagger. The dataset contains approximately 10,000 to 100,000 samples, with each language edition split into a training set and a validation set. Each record includes the following fields: text (processed article text), id (unique identifier), page_id (Wikipedia page ID), title (article title), url (article URL), version (version identifier), start_end_sentence_character_indexes (list of character offset ranges for sentences), tokens (list of tokenized text organized by sentences), tags (list of the most probable USAS tags for each token), other_tags (list of other valid USAS tags for each token), and mwes (list of MWE tags). The dataset is stored in zstd-compressed Parquet files. It is licensed under CC BY-SA 4.0 and GFDL.
Multilingual USAS Silver Labelled Wikipedia Articles 数据集详情
数据集概述
- 数据集名称: Multilingual USAS Silver Labelled Wikipedia Articles
- 语言: 多语言(英语、荷兰语、葡萄牙语、西班牙语、丹麦语、意大利语、芬兰语、中文)
- 规模: 10,000 < n < 100,000 条数据
- 许可证: CC-BY-SA-4.0 和 GFDL
数据集用途
该数据集可用于训练 USAS 语义标注器和多词表达式(MWE)识别器。
数据来源与处理流程
来源
- 源文本来自 HuggingFace 的
HuggingFaceFW/finewiki数据集 - 仅包含被评为 Good (GA) 或 Featured (FA) 的文章(使用
ucrelnlp/wikipedia-ga-fa-ids中的文章 ID 列表筛选)
处理流程
- 筛选出GA或FA评级的文章
- 排除人工筛选测试集中的文章
- 移除家族树表格、数学公式和其他表格
- 剥离 Markdown 格式
- 删除少于 50 个 tokens 的文章
- 进行精确和 MinHash 去重
- 使用语言特定的 spaCy 句子分割器进行句子切分
- 使用 PyMUSAS 基于规则的标注器对每个句子进行 USAS 语义标签和 MWE 标注
数据集结构
数据格式
- 数据以 zstd 压缩的 Parquet 文件存储
- 每个配置按语言分为
train和validation子集
数据字段
| 字段 | 描述 |
|---|---|
text |
处理后的文章文本 |
id |
文章唯一标识符 |
page_id |
Wikipedia 页面 ID |
title |
文章标题 |
url |
文章 URL |
version |
页面修订版本标识符 |
start_end_sentence_character_indexes |
每个句子的字符偏移量列表 |
tokens |
句子分词后的 token 列表 |
tags |
PyMUSAS 规则标注器预测的 USAS 标签 |
other_tags |
token 的其他有效 USAS 标签 |
mwes |
多词表达式标签 |
数据拆分
- 每个语言独立拆分为训练集和验证集
- 验证集容量由百分比和最大文档数两者中先达到者决定
- 拆分基于页面 ID 的哈希确定,可复现
数据集配置
包含 8 个语言配置:da(丹麦语)、nl(荷兰语)、fi(芬兰语)、it(意大利语)、pt(葡萄牙语)、es(西班牙语)、zh(中文)、en(英语)
构建与联系
- 数据集维护者: 兰卡斯特大学 UCREL 研究组
- 代码仓库: https://github.com/UCREL/wikipedia-USAS-processing
- 联系方式: ucrel@lancaster.ac.uk
- 数据集作者: UCREL 团队、Andrew Moore、Paul Rayson