DrivingVQA-conflict
收藏资源简介:
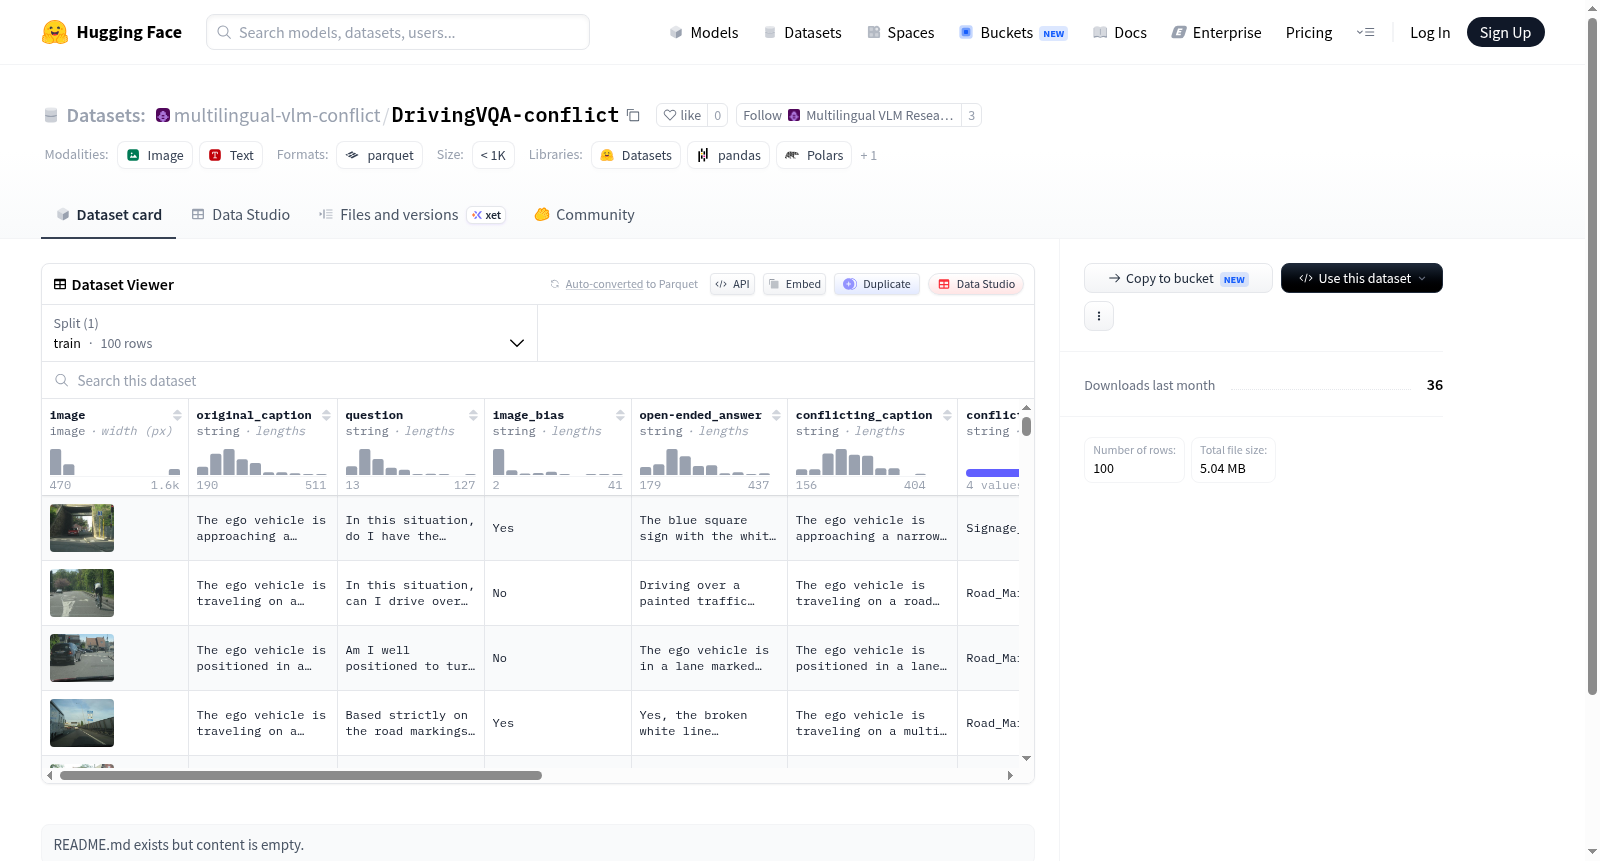
该数据集是一个多模态数据集,旨在研究视觉-语言任务中可能存在的偏见与内容冲突。数据集包含100个训练样本,每个样本由图像及其相关的多种文本标注构成。核心字段包括:image(原始图像)、original_caption(图像原始描述)、question(相关问题)、image_bias(图像中存在的偏见描述)、open-ended_answer(针对问题的开放式答案)、conflicting_caption(与图像或原始描述存在冲突的描述)、conflict_type(冲突类型)、text_bias(文本中存在的偏见描述)、conflicting_open-ended_answer(存在冲突的开放式答案)以及distractor(干扰项)。此外,还包含serial_no(序列号)和language(语言标识)字段。数据集结构表明其适用于分析和评估模型在存在偏见信息或矛盾上下文时的鲁棒性、公平性及推理能力,可能的应用场景包括偏见检测、矛盾识别、视觉问答(VQA)的对抗性测试等。
This multimodal dataset aims to investigate biases and content conflicts that may arise in vision-language tasks. It contains 100 training samples, each consisting of an image and its associated multiple text annotations. The core fields of the dataset are as follows: image (raw original image), original_caption (original description of the image), question (relevant question), image_bias (description of biases present in the image), open-ended_answer (open-ended answer to the question), conflicting_caption (description that conflicts with the image or its original caption), conflict_type (type of conflict), text_bias (description of biases present in the text), conflicting_open-ended_answer (conflicting open-ended answer), and distractor (distractor element). Additionally, the dataset includes the serial_no (serial number) and language (language identifier) fields. The dataset's structure makes it suitable for analyzing and evaluating a model's robustness, fairness, and reasoning ability when dealing with biased information or contradictory contexts. Potential application scenarios include bias detection, conflict recognition, adversarial testing for visual question answering (VQA), and other related use cases.
数据集概述:DrivingVQA-conflict
数据集链接: https://huggingface.co/datasets/multilingual-vlm-conflict/DrivingVQA-conflict
数据集简介
DrivingVQA-conflict 是一个用于多语言视觉语言模型冲突评估的数据集,专注于驾驶场景下的视觉问答任务。该数据集旨在测试模型在面对图像与文本描述之间存在冲突时的表现。
数据特征
数据集包含以下特征字段:
- image:图像数据
- original_caption:原始图像描述
- question:提出的问题
- image_bias:图像偏向信息
- open-ended_answer:基于原始描述的开放式答案
- conflicting_caption:与原始描述冲突的文本描述
- conflict_type:冲突类型
- text_bias:文本偏向信息
- conflicting_open-ended_answer:基于冲突描述的开放式答案
- distractor:干扰项信息
- serial_no:序列号(整数类型)
- language:语言标识
数据集规模
- 训练集(train):共 100 个样本,占用约 4.98 MB 存储空间
- 总下载大小:约 4.92 MB
- 总数据集大小:约 4.98 MB
数据集配置
- 配置名称:default
- 数据文件路径:
data/train-*