scientific-sft-grpo-data
收藏资源简介:
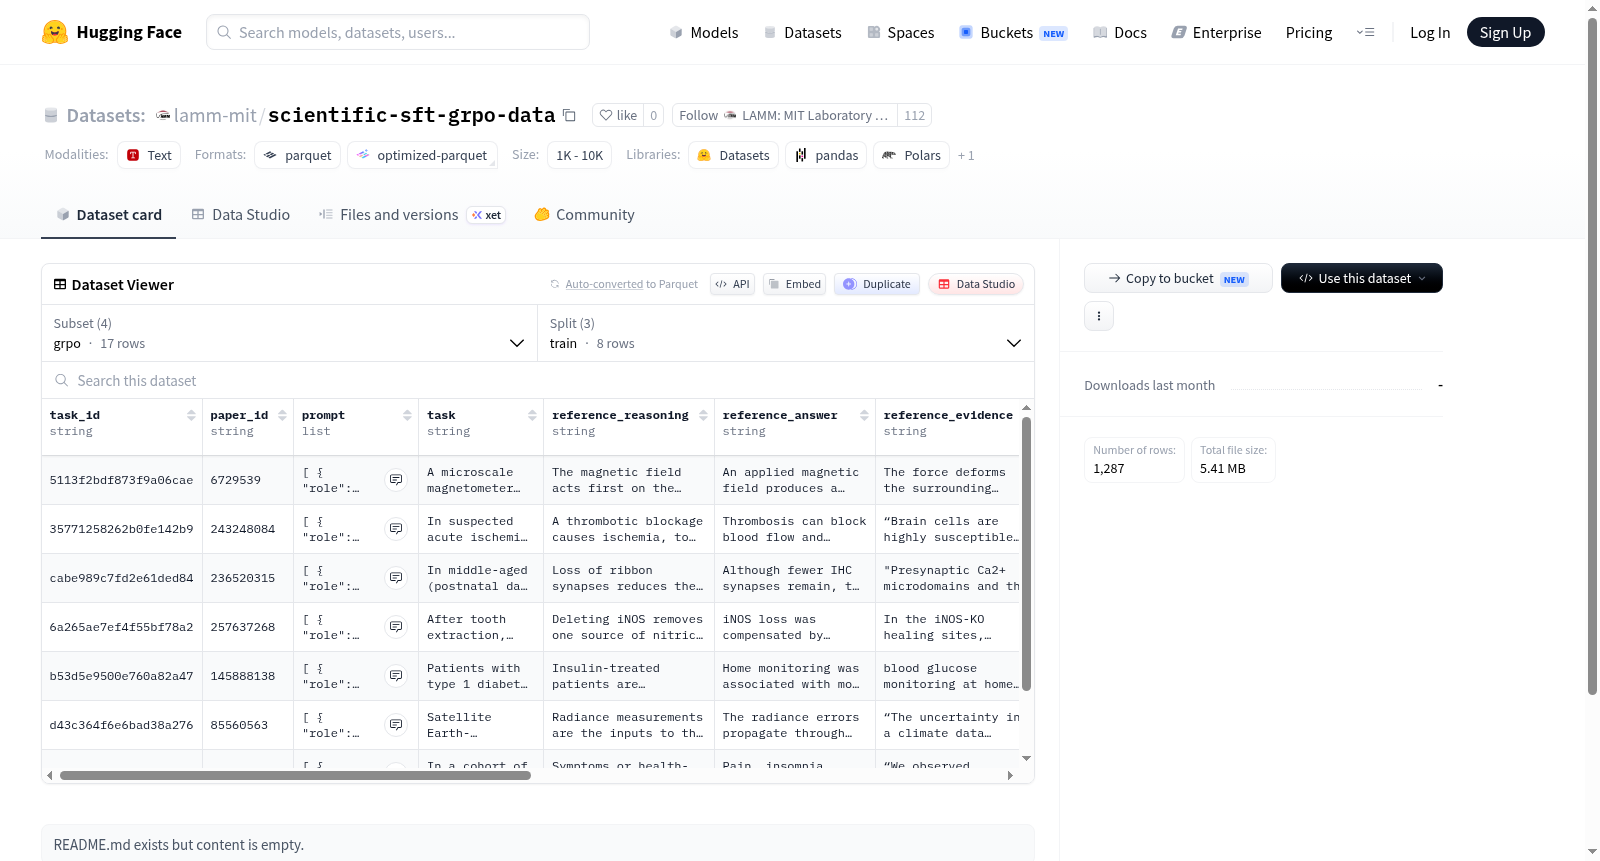
该数据集包含两个配置(grpo和sft),旨在支持自然语言处理中的高级任务,特别是推理、因果分析和指令遵循。grpo配置提供了结构化的任务实例,每个实例包含唯一的任务ID和论文ID、一个由角色和内容组成的对话式提示、任务描述、参考推理过程、参考答案、支持证据、详细的机制步骤列表、表示原因与效果关系的因果链接列表、完成任务所需的概念列表,以及数据的来源许可证和URL。该配置包含训练集(8个样本)、验证集(4个样本)和测试集(5个样本),总计17个样本。sft配置则侧重于监督微调,每个实例包含任务ID、论文ID、一个由角色和内容组成的提示、一个对应的由角色和内容组成的补全(响应),以及来源信息。该配置包含训练集(19个样本)和验证集(1个样本),总计20个样本。两个配置的数据均以结构化格式组织,适用于训练和评估能够进行多步推理、因果解释和遵循复杂指令的语言模型。
This dataset comprises two configurations (grpo and sft), intended to support advanced natural language processing (NLP) tasks, particularly reasoning, causal analysis, and instruction following. The grpo configuration provides structured task instances, each including a unique task ID and paper ID, a dialogic prompt structured with role and content pairs, task description, reference reasoning process, reference answer, supporting evidence, a detailed list of mechanistic steps, a list of causal links representing cause-effect relationships, a list of concepts required for task completion, as well as the data source license and URL. This configuration includes a training set (8 samples), a validation set (4 samples), and a test set (5 samples), totaling 17 samples. The sft configuration focuses on supervised fine-tuning, with each instance containing a task ID, paper ID, a prompt consisting of role and content pairs, a corresponding completion (response) composed of role and content pairs, and source information. This configuration includes a training set (19 samples) and a validation set (1 sample), totaling 20 samples. Data from both configurations are organized in structured formats, suitable for training and evaluating language models capable of multi-step reasoning, causal explanation, and following complex instructions.
数据集概述
该数据集名为 scientific-sft-grpo-data,由 lamm-mit 组织提供,包含四个子配置(config_name),分别用于不同的训练和评估场景。
配置与规模
| 配置名称 | 用途 | 训练集(样本数) | 验证集(样本数) | 测试集(样本数) | 总大小(字节) |
|---|---|---|---|---|---|
| grpo | GRPO 训练 | 8 | 4 | 5 | 73,265 |
| scientific_design_grpo | 科学设计 GRPO 训练 | 500 | 75 | 100 | 3,035,948 |
| scientific_design_sft | 科学设计 SFT 训练 | 500 | 75 | 无 | 2,475,963 |
| sft | SFT 训练 | 19 | 1 | 无 | 44,297 |
特征字段
- grpo:包含 task_id、paper_id、prompt(role 和 content)、task、reference_reasoning、reference_answer、reference_evidence、mechanism_steps(字符串列表)、causal_links(cause 和 effect)、required_concepts(字符串列表)、source_license、source_url。
- scientific_design_grpo:包含 task_id、paper_id、task_family、prompt(role 和 content)、task、required_constraints(字符串列表)、evaluation_criteria(字符串列表)、acceptable_alternatives(字符串列表)、failure_modes(字符串列表)、source_license、source_url。
- scientific_design_sft:包含 task_id、paper_id、task_family、prompt(role 和 content)、completion(role 和 content)、source_license、source_url。
- sft:包含 task_id、paper_id、prompt(role 和 content)、completion(role 和 content)、source_license、source_url。
数据划分
每个子配置的数据按 split 划分,具体文件路径为:
- grpo:train-、validation-、test-*
- scientific_design_grpo:train-、validation-、test-*
- scientific_design_sft:train-、validation-
- sft:train-、validation-
许可与来源
- source_license:记录了每个样本的原始许可信息。
- source_url:提供了每个样本的原始来源链接。
数据来源
该数据集的数据来源于科学论文,具体通过 paper_id 字段标识,并结合 task_id 进行任务类型区分。