
遇见数据集

SINAI/ALIA-es-cultural

收藏
Hugging Face2026-05-05 更新2026-05-10 收录
官方服务:

资源简介:

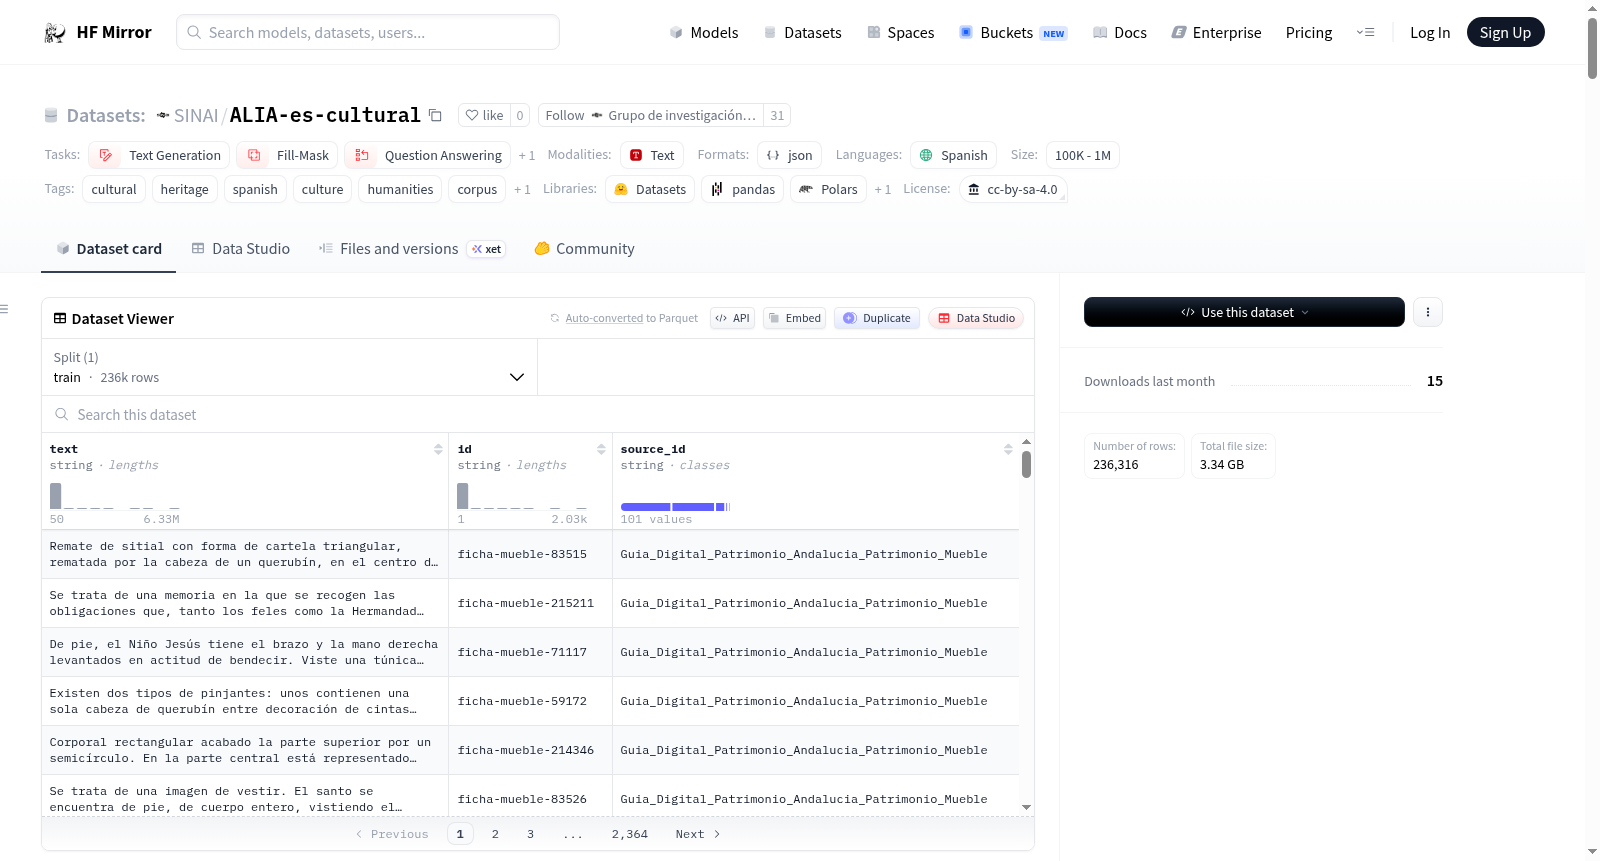
ALIA西班牙文化与遗产语料库是一个战略性开放数据基础设施,旨在支持数字人文、文化分析和西班牙语NLP的研究与创新。该语料库整合了来自西班牙的异构官方和学术资源,形成一个统一的精选数据集,提供了广泛且结构化的文化遗产文档访问。包含236,399个实例和946,467,028个标记,来自102个源数据集,为文化遗产领域的专业语言技术开发提供了坚实基础。语料库集成了遗产清单、专业期刊、档案记录、机构出版物以及关于物质和非物质遗产的描述性资源,旨在为数字人文、文化机构、档案管理员、历史学家、语言学家和AI从业者提供同质化和可重用的文本基础。

The ALIA Spanish Culture and Heritage Corpus is a strategic open data infrastructure intended to support research and innovation in digital humanities, cultural analytics, and Spanish NLP. This corpus integrates heterogeneous official and academic resources from Spain to form a unified curated dataset, offering broad, structured access to cultural heritage documents. It comprises 236,399 instances and 946,467,028 tokens, drawn from 102 source datasets, providing a robust foundation for the development of specialized language technologies within the cultural heritage domain. The corpus incorporates heritage inventories, specialized journals, archival records, institutional publications, and descriptive resources pertaining to tangible and intangible heritage, with the goal of delivering a homogenized and reusable textual foundation for digital humanities scholars, cultural institutions, archivists, historians, linguists, and AI practitioners.
提供机构:
SINAI
搜集汇总
数据集介绍
SINAI/ALIA-es-cultural 数据集图片
构建方式
ALIA-es-cultural数据集的构建基于对西班牙文化遗产领域异构官方与学术资源的系统性整合。研究团队从102个公开可访问的数据源中采集文档,涵盖遗产编目、机构出版物、学术期刊及开放知识库等多元类型。运用MinerU文档解析工具与datatrove清洗框架,执行了格式归一化、西班牙语文本筛选、近似重复内容去重以及编码错误修正等步骤。最终以统一的结构化schema存储为Parquet格式,确保了数据的法律可复用性与下游NLP任务的兼容性。
特点
该数据集的核心特色在于其规模与异质性的有机结合。包含236,399个实例与约9.46亿个token,覆盖从区域级遗产清单(如安达卢西亚数字指南)到高影响力学术期刊(如CSIC系列)的广泛文本类型。数据来源的多样性使得语料库能够反映从正式机构文献到民间文化记录的完整叙事光谱,为数字人文中的语义检索、术语提取与主题发现提供了丰富的语义维度。
使用方法
用户可通过HuggingFace Datasets库便捷加载,支持完整下载与流式读取两种模式。每条记录包含文档标识符、清洗后的文本内容及来源标签。该语料库主要面向西班牙文化遗产领域的大语言模型训练、问答系统开发及信息检索任务。亦可用于文本分类与掩码填充等经典NLP场景,或作为领域适应微调的预训练语料,推动文化遗产计算的纵深发展。
背景与挑战
背景概述
ALIA-es-cultural语料库是西班牙数字人文与自然语言处理领域的一项重要战略数据基础设施,由西班牙研究机构主导创建,旨在为文化遗产领域的语言技术研究提供大规模、结构化且可复用的开放数据资源。该语料库整合了来自102个官方与学术源的数据,涵盖遗产清单、专业期刊、档案记录、机构出版物及有形与无形文化遗产的描述性资源,总计包含236,399个实例和超过9.46亿个token,成为西班牙语文化遗产领域规模最大的文本数据集之一。其构建服务于ALIA倡议,支持大型语言模型训练、文化遗产信息检索、问答系统及数字人文中的术语提取与主题发现等计算任务,显著推动了西班牙语文化遗产的数字化分析与人工智能应用。
当前挑战
该数据集面临的核心挑战在于解决文化遗产领域自然语言处理中的多项难题:首先,文化遗产文本高度领域化,涉及大量专业术语、历史语域和多样化文体,通用语言模型难以有效建模,亟需领域专用语料提升语义理解与生成能力;其次,数据来源异构性显著,涵盖官方目录、学术期刊、维基百科、视听档案等多种类型,格式与深度参差不齐,需设计统一清洗与标准化流程以保障数据质量。在构建过程中,团队面临跨源格式归一化、语言过滤与质量校验、大规模去重以及编码错误修正等技术挑战,同时需确保所有数据符合开放许可与隐私保护要求,最终通过MinerU解析与datatrove清洗管道实现高效处理。
常用场景
经典使用场景
ALIA-es-cultural语料库为西班牙文化遗产领域的自然语言处理研究提供了坚实的数据基石。其最经典的应用场景在于训练和评估面向文化遗产文本的大型语言模型,特别是在西班牙语环境下,通过整合超过23万条、近9.5亿词元的异构文档,使模型能够深入理解遗产名录、学术期刊、档案记录以及机构出版物中蕴含的丰富历史话语与制度叙事。
实际应用
在实际应用层面,该语料库支撑了文化遗产导向的信息检索系统、基于历史文献的问答系统以及机构档案的智能分析工具。例如,博物馆和遗产机构可借助基于此数据集训练的模型,实现对藏品描述、考古报告与无形文化记录的自动化分类与语义搜索,从而优化公共文化服务的可及性与知识传播效率。
衍生相关工作
此语料库的发布催生了一系列相关研究工作,包括基于其构建的西班牙语文化遗产专用语言模型(如ALIA系列)、面向遗产文本的命名实体识别与关系抽取方法,以及融合多源异构数据的知识图谱构建技术。此外,它还为文档解析工具MinerU与数据清洗框架datatrove在人文领域的应用提供了实证基准,推动了开源工具在文化遗产数据处理中的标准化进程。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

