
遇见数据集

lightonai/gpqa_diamond_multilingual

收藏
Hugging Face2026-05-27 更新2026-06-14 收录
官方服务:

资源简介:

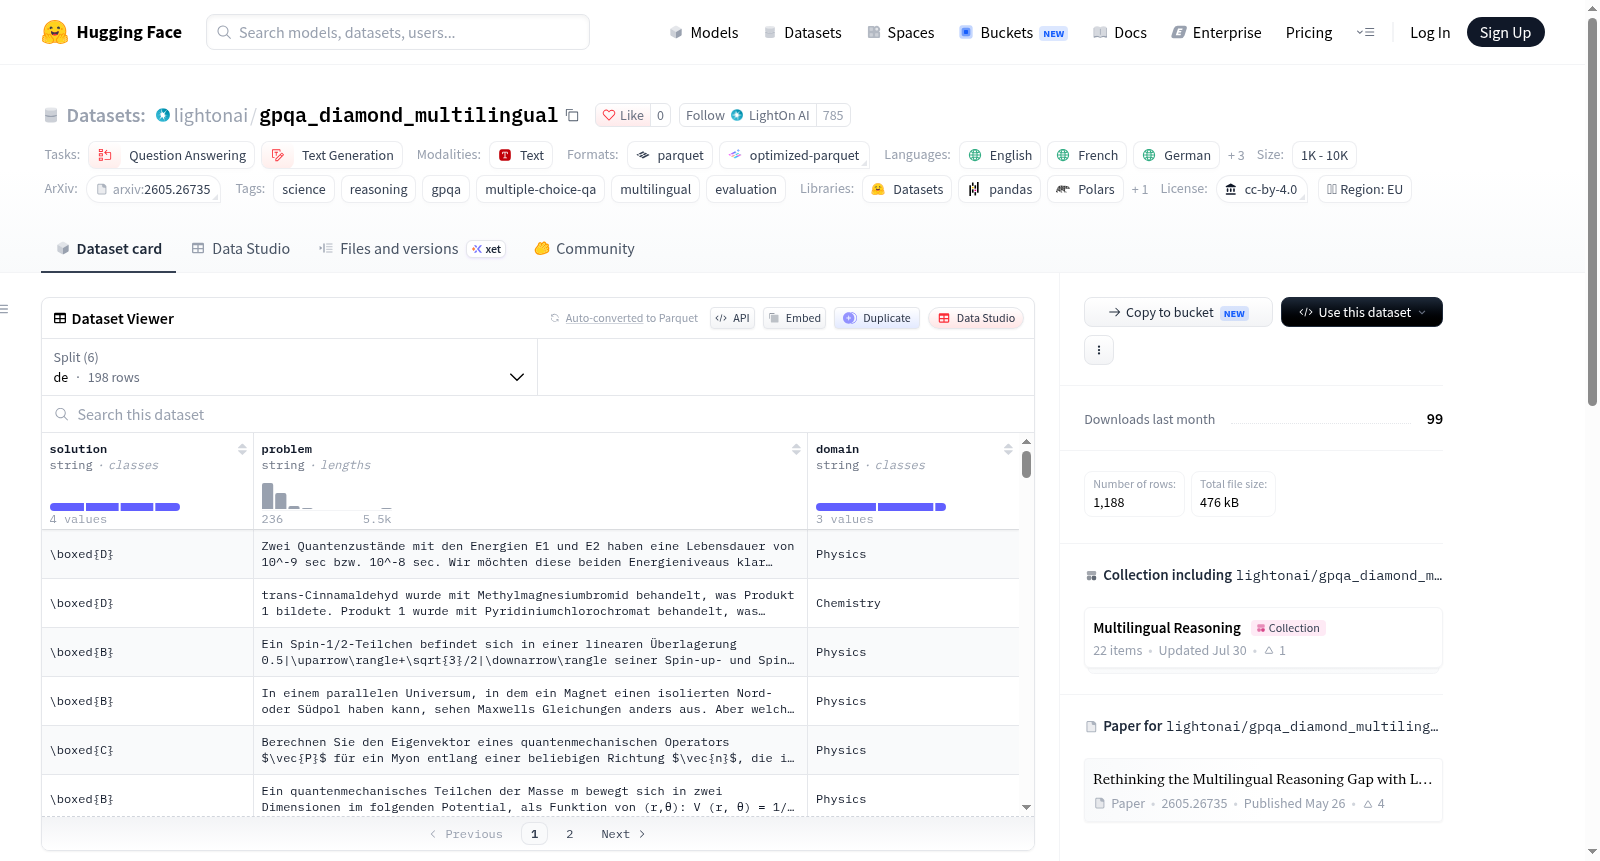
GPQA Diamond Multilingual 是基准数据集 GPQA Diamond 的多语言版本,涵盖六种语言:英语、法语、德语、西班牙语、中文和斯瓦希里语。每个样本是生物学、物理学或化学领域的研究生水平多项选择题,由领域专家编写和验证,并翻译成五种目标语言。此版本是修正版,修复了翻译中的错误和伪影。数据集与论文Rethinking the Multilingual Reasoning Gap with Layer Swap一同发布。

GPQA Diamond Multilingual is the multilingual variant of the benchmark dataset GPQA Diamond, covering six languages: English, French, German, Spanish, Chinese, and Swahili. Each sample consists of graduate-level multiple-choice questions in biology, physics, or chemistry, which were authored and validated by domain experts, and translated into the five target languages. This is a corrected version that fixes translation errors and artifacts. The dataset was released alongside the paper *Rethinking the Multilingual Reasoning Gap with Layer Swap*.
提供机构:
lightonai
搜集汇总
数据集介绍
lightonai/gpqa_diamond_multilingual 数据集图片
构建方式
该数据集以GPQA Diamond英文基准为源,选取生物学、物理学与化学领域的研究生水平多项选择题,经由领域专家撰写并校验,随后由专业译员转译为法语、德语、西班牙语、汉语和斯瓦希里语五种目标语言。作为对先前shanchen/gpqa_diamond_mc_multilingual版本的修正,构建过程着重修复翻译伪影与语义偏差,确保各语言版本在科学概念与逻辑推理上保持等价,从而为多语言推理评测提供可靠基础。
使用方法
研究者可通过HuggingFace数据集接口直接加载,利用task_categories中的question-answering与text-generation配置进行多语言推理评测。使用时可按语言字段筛选子集,对比模型在源语言与目标语言上的表现差异,或结合层交换等干预方法分析多语言推理鸿沟。建议引用配套论文,并在报告中注明版本修正背景,以确保结果可复现。
背景与挑战
背景概述
面向研究生层次科学推理能力的评估长期依赖英语基准,GPQA Diamond以其经领域专家撰写并验证的生物、物理、化学选择题成为衡量模型深层知识的重要标尺。然而,其单语属性限制了跨语言推理能力的考察,多语言评估资源的匮乏亦制约了相关研究。在此背景下,gpqa_diamond_multilingual应运而生,由Lasbordes、Chatelain与Seddah等研究人员构建,将GPQA Diamond扩展至英语、法语、德语、西班牙语、汉语和斯瓦希里语六种语言,并作为修正版本修复了此前多语言版本中的翻译瑕疵。该数据集为探究多语言推理差距提供了可靠基准,对跨语言模型评估与低资源语言研究具有推动作用。
当前挑战
该数据集所应对的领域问题在于,如何在保持研究生级别科学问题难度与专业性的前提下,实现跨六种语言的高质量评估,从而揭示模型在多语言环境中的推理一致性。构建过程中面临的挑战包括:科学术语在法语、德语、西班牙语、汉语和斯瓦希里语中的精确对译与语境适配,避免翻译导致的歧义或难度漂移;确保修正版本相较原多语言版本确实消除了翻译伪影与错误;以及维持各语言样本在语义等价性与选项区分度上的均衡。这些挑战共同构成了多语言科学推理基准建设的核心难点。
常用场景
经典使用场景
在跨语言推理与科学知识评测领域,gpqa_diamond_multilingual 最经典的使用场景是作为多语言基准,评估大语言模型在英语、法语、德语、西班牙语、中文及斯瓦希里语六种语言下对研究生级别生物、物理、化学多选题的解答能力。该数据集通过专家撰写并验证的题目,以及经修正的翻译版本,为研究者提供公平且可复现的测试平台,用以比较模型在不同语言间的表现差异,揭示多语言推理中的性能鸿沟。
解决学术问题
该数据集直面多语言评测中翻译质量参差、语言覆盖有限及领域知识不均衡等常见学术难题。其修正版消除了先前翻译伪影与错误,为探究语言资源丰富度对推理能力的影响提供了可靠素材。通过系统考察模型在六种语言上的准确率,研究者可量化多语言推理差距,进而检验诸如层交换等干预策略的有效性,对推动公平、鲁棒的多语言模型研究具有方法论意义。
实际应用
在实际应用中,gpqa_diamond_multilingual 可服务于多语言智能辅导系统、跨国科研协作平台及教育科技产品的开发与验证。例如,基于该数据集微调或评估的模型能够以用户母语提供研究生水平的科学问题解答,辅助非英语背景的学习者获取高阶知识。同时,该数据集亦可用于检测模型在低资源语言(如斯瓦希里语)上的推理短板,指导实际部署中的语言适配与性能优化。
数据集最近研究
最新研究方向
围绕大语言模型多语言推理能力的评估与诊断,gpqa_diamond_multilingual数据集推动了跨语言科学推理基准的精细化构建。该数据集基于GPQA Diamond研究生水平科学多选题,覆盖英语、法语、德语、西班牙语、中文和斯瓦希里语六种语言,为探究模型在低资源语言与高资源语言间的推理性能差异提供了标准化测试平台。与此数据集同期发布的Layer Swap研究,聚焦于多语言推理鸿沟的成因与缓解策略,通过层级交换机制分析模型内部表征的跨语言迁移特性。该方向的研究意义在于揭示多语言模型在专业科学推理任务中的语言偏见与知识迁移规律,为构建更公平、鲁棒的多语言推理系统提供实证依据。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

