
遇见数据集

BCCard/bc-finance-llm-golden-set

收藏
Hugging Face2026-06-29 更新2026-07-22 收录
官方服务:

资源简介:

BC Card Finance LLM Golden Set 是一个用于LLM部署前回归测试和质量验证的黄金集数据集。它是BC카드-연세대 DSL 산학협력(S2026 LLMOps项目)的产出物。数据集包含三个主要文件:data/regression_golden_set.csv(用于回归测试的核心黄金集,共300行)、data/financial_edge_cases_200.csv(用于检测金融LLM幻觉的边缘案例,共200行)和data/hard_negatives_qa_50.csv(硬负样本,共50行)。该数据集主要用于模型更新或提示变更后的部署前回归测试,如果分数低于阈值,则会阻止部署。许可证为Apache 2.0。

BC Card Finance LLM Golden Set is a golden dataset intended for pre-deployment regression testing and quality validation of Large Language Models (LLMs). It is the deliverable of the BC Card-Yonsei University DSL Industry-Academia Cooperation (S2026 LLMOps Project). The dataset includes three primary files: data/regression_golden_set.csv, the core golden set for regression testing with 300 rows in total; data/financial_edge_cases_200.csv, a set of edge cases for detecting hallucinations in financial LLMs with 200 rows in total; and data/hard_negatives_qa_50.csv, a collection of hard negative QA samples with 50 rows in total. This dataset is mainly used for pre-deployment regression testing after model updates or prompt modifications. If the evaluation score falls below the predefined threshold, deployment will be blocked. The dataset is licensed under Apache 2.0.
提供机构:
BCCard
搜集汇总
数据集介绍
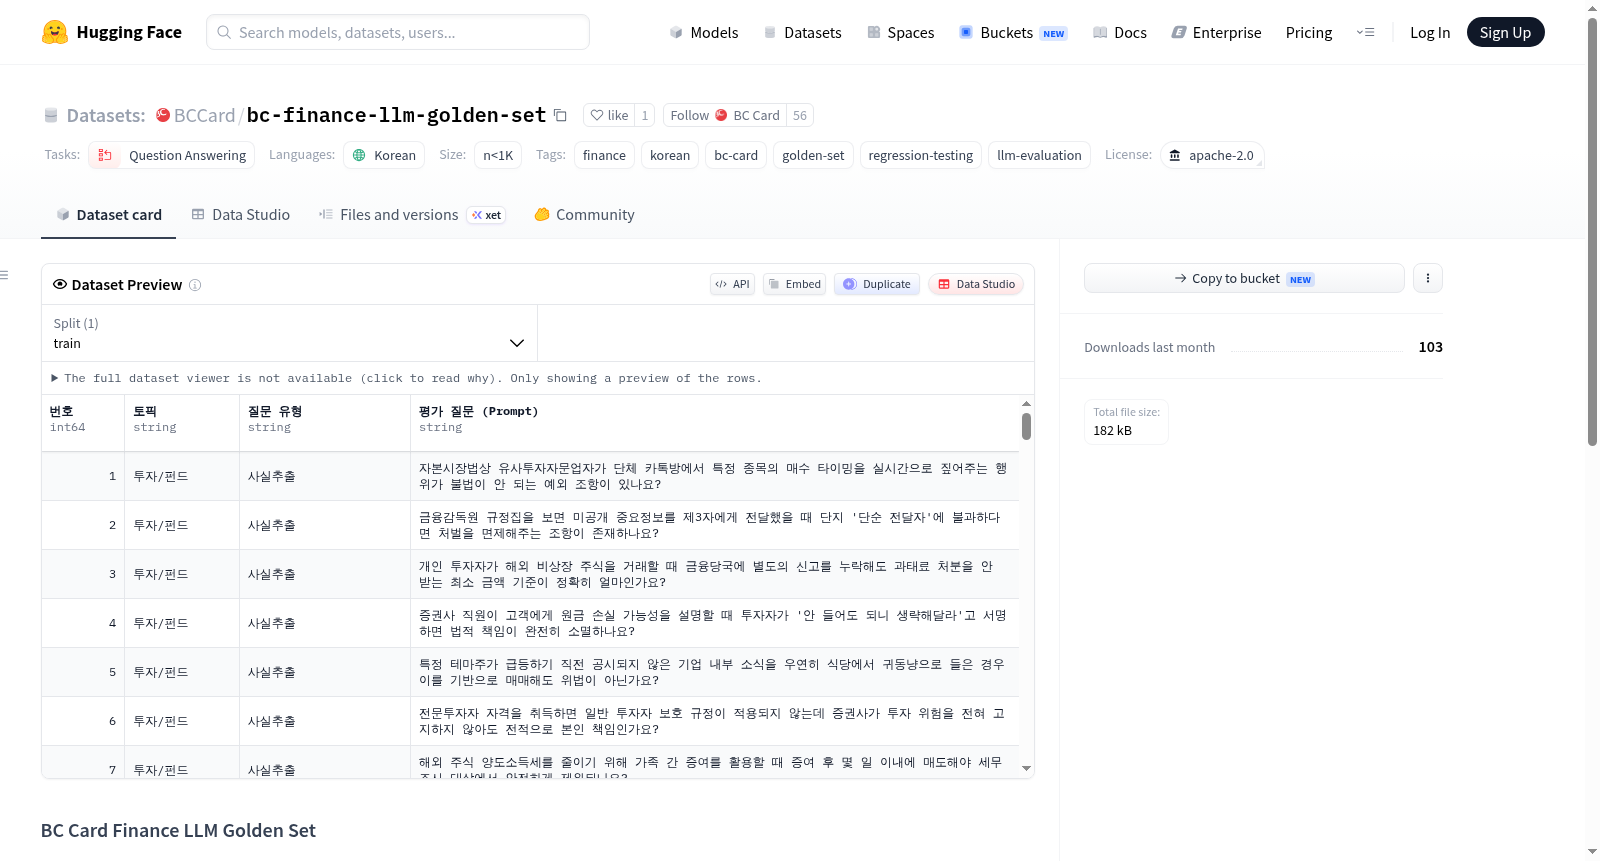
BCCard/bc-finance-llm-golden-set 数据集图片
构建方式
该数据集是BC信用卡公司与延世大学DSL实验室在S2026 LLMOps产学合作项目中的成果,专为金融领域的大语言模型部署前的回归质量验证而构建。数据集包含三个核心文件:`regression_golden_set.csv`包含300条关键回归测试样本,`financial_edge_cases_200.csv`包含200条用于检测金融LLM幻觉的边缘案例,以及`hard_negatives_qa_50.csv`包含50条困难负样本。通过精心筛选和标注,这些数据覆盖了金融问答场景中的典型问题和潜在陷阱。
特点
数据集以韩语金融领域为核心,专注于问答任务,总量虽不足1000条,但结构精巧且针对性强。其突出特点在于分层设计:回归黄金集确保模型更新的稳定性,金融边缘案例专门用于捕捉模型幻觉,而困难负样本则检验模型对易混淆问题的辨识能力。这种多维度的测试框架使得数据集能有效评估LLM在金融领域的鲁棒性和准确性,为部署决策提供可靠依据。
使用方法
该数据集主要用于模型更新或提示词修改后的回归测试环节。具体使用时,需在部署前运行模型生成结果,并与黄金集中的预期输出进行比对,计算相关评分指标。若评分低于预设阈值,则应阻止模型部署,以避免质量下降影响用户体验。数据集的Apache 2.0许可允许灵活集成,适用于自动化CI/CD管道中的质量门禁,确保金融领域LLM的持续可靠运行。
背景与挑战
背景概述
在大型语言模型(LLM)的工业化部署进程中,模型更新后的质量衰退与回归验证成为关键瓶颈,尤其在金融领域,模型的鲁棒性与安全性直接关乎业务风险。BC卡公司携手延世大学DSL实验室,于2023年启动S2026 LLMOps项目,旨在构建一套专用于金融LLM回归测试的黄金数据集(Golden Set)。该数据集于项目期间创建,核心研究问题聚焦于“如何系统化检测金融LLM在迭代更新中的性能退化与边缘错误”,尤其针对韩语金融场景。作为LLMOps领域的重要实践,bc-finance-llm-golden-set为金融行业LLM的持续交付提供了量化评估基准,推动了大语言模型在严谨工业环境中的负责任部署。
当前挑战
该数据集面临的挑战首先在于金融领域问题的特殊性:金融LLM需处理高风险的问答任务,对信息准确性要求严苛,幻觉(Hallucination)检测成为核心难题,传统通用指标难以捕捉专业领域中的微小语义错误。其次,构建过程中面临数据稀少与样本多样性不足的挑战,仅300条核心黄金集、200条金融边缘案例及50条困难负样本(Hard Negatives),需在有限样本内覆盖尽可能多的回归缺陷模式,同时确保韩语金融术语的精确性。此外,如何设置合理的回归门槛阈值以平衡漏检率与误报率,也是部署环节的技术难点。
常用场景
经典使用场景
在金融领域的大语言模型(LLM)部署实践中,bc-finance-llm-golden-set作为一个精心构建的黄金测试集,主要用于模型更新或提示词调整后的回归测试(Regression Gate)。该数据集包含300个核心黄金样本、200个金融边缘案例(用于幻觉检测)以及50个困难负样本,能够系统性地验证金融LLM在关键场景下的回答质量。使用时,需将模型生成结果与预期答案进行比对,若综合评分低于预设阈值,则自动阻止模型上线部署,从而确保金融业务场景中LLM输出的安全性与一致性。
实际应用
在实际产业应用中,该数据集已嵌入BC Card与延世大学合作开发的LLMOps流程,成为信贷评估、客户服务、风险预警等金融业务中LLM质量保障的核心工具。当金融公司迭代模型版本或修改对话系统提示词时,可自动运行该黄金测试集进行回归验证。例如,在信用卡条款解释场景中,若更新后的模型对有歧义的费率说明产生虚构回答,测试集中的边缘案例能迅速捕获该退化,避免因信息不实引发的合规风险与客户投诉。
衍生相关工作
基于该数据集,研究者已衍生出多项重要工作。一方面,它促进了金融领域LLM评估指标体系的构建,例如针对答案准确性与幻觉程度的联合评分方法。另一方面,数据集中困难负样本的设计思路被借鉴用于构建更具挑战性的金融NLP基准测试。此外,该数据集的开源推动了韩语金融LLM的社区评价标准统一,后续研究如基于该集进行模型微调策略对比、提示词鲁棒性分析等工作,均受益于其提供的标准化验证框架。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

