
遇见数据集

KGGen_PURE

收藏
Hugging Face2026-08-13 更新2026-08-14 收录
官方服务:

资源简介:

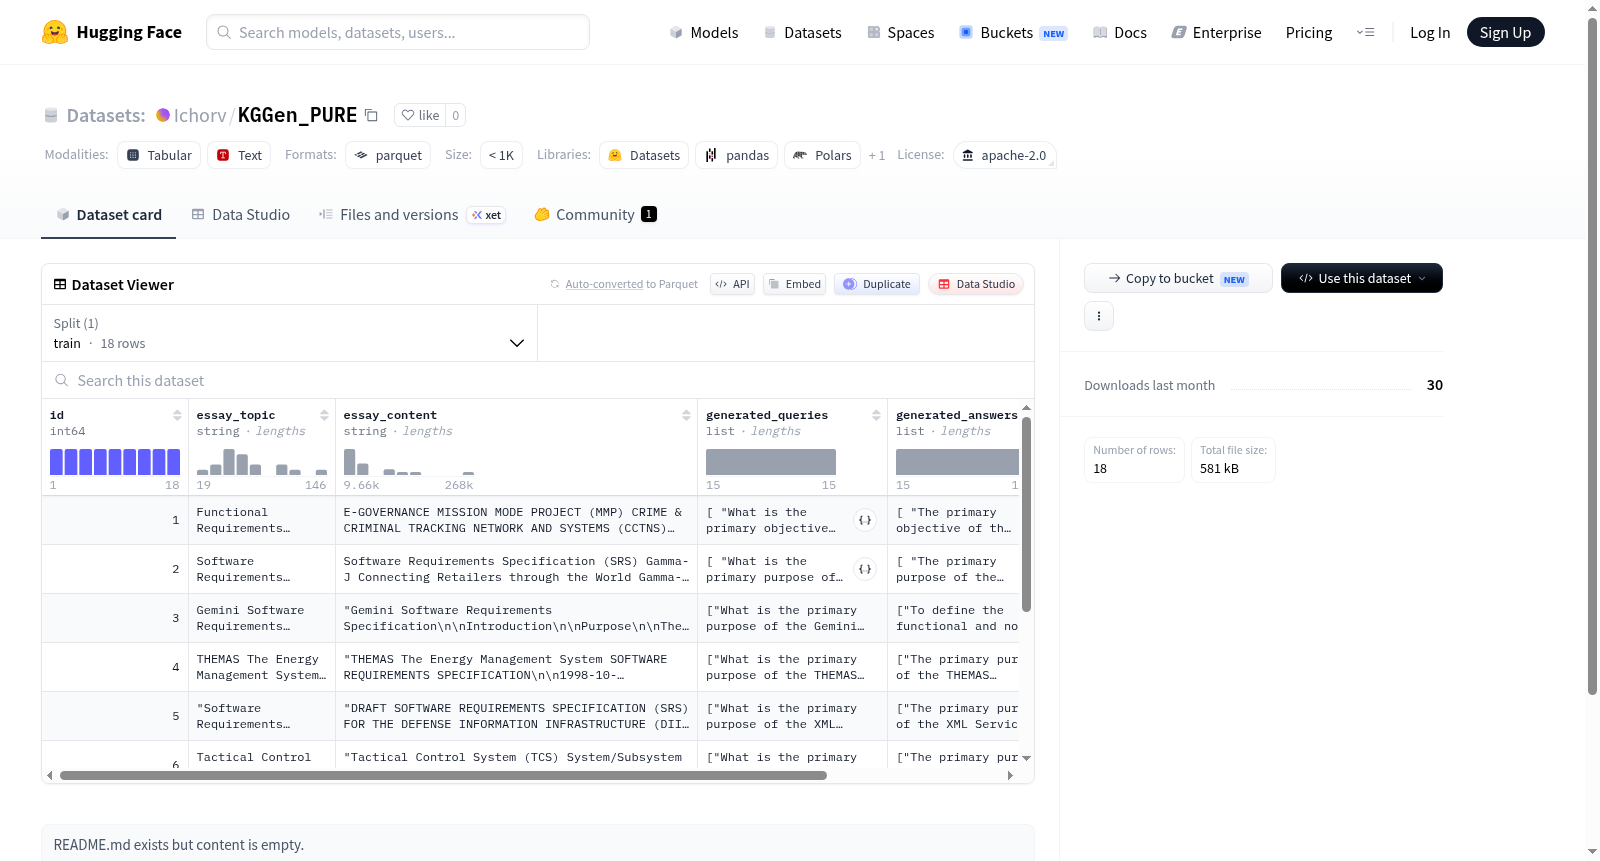
该数据集包含18个样本,每个样本由文章主题(essay_topic)、文章内容(essay_content)以及基于文章生成的查询(generated_queries)和答案(generated_answers)组成。查询数量(num_generated_queries)也一并提供。该数据集可用于训练和评估基于文章内容生成查询和答案的模型,适用于问答生成、信息检索、阅读理解等任务。数据集仅提供训练集,文件格式为Parquet或类似格式,总大小约1.2MB。

The dataset contains 18 samples, each consisting of an essay topic (essay_topic), essay content (essay_content), and generated queries (generated_queries) and answers (generated_answers) based on the essay. The number of generated queries (num_generated_queries) is also provided. This dataset can be used to train and evaluate models that generate queries and answers based on essay content, suitable for tasks such as question answering generation, information retrieval, and reading comprehension. The dataset only provides a training set, in Parquet or similar format, with a total size of approximately 1.2MB.

创建时间:
2026-08-12
原始信息汇总

KGGen_PURE 数据集详情

基本信息

  • 许可证:Apache-2.0
  • 数据集大小:下载大小约 580 KB,总大小约 1.2 MB
  • 数据规模:训练集包含 18 个样本

数据配置

  • 默认配置名称:default
  • 数据文件路径data/train-*(采用通配符匹配多个分片文件)
  • 数据划分:仅提供 train 划分,共 18 个示例

字段说明

字段名 类型 描述
id int64 样本唯一标识符
essay_topic string 文章主题
essay_content string 文章正文内容
generated_queries list[string] 基于文章生成的问题列表
generated_answers list[string] 对应生成问题的答案列表
num_generated_queries int64 生成的问题数量

数据用途

该数据集包含 18 篇文章及其对应生成的问题-答案对,适用于知识图谱生成、问答系统训练、信息抽取等领域的研究与开发。数据以 Apache-2.0 协议开放,可自由使用和修改。
搜集汇总
数据集介绍
KGGen_PURE 数据集图片
构建方式
KGGen_PURE数据集是在知识图谱生成领域的一项创新性构建成果,其构建过程精心打磨,旨在为学术研究提供高质量的语料资源。该数据集包含18个样本,每个样本均由一个唯一的标识符、一个关于文章主题的描述、一篇完整的文章内容以及由模型生成的一系列查询和答案组成。构建方法通过结合预训练语言模型与精心设计的提示策略,自动生成与文章主题相关的多样查询及对应答案,从而在数据层面实现了从非结构化文本到结构化知识图谱的桥梁搭建。每个样本均附带生成查询的数量,便于研究者对生成过程进行量化分析。
使用方法
使用KGGen_PURE数据集时,研究者可直接通过HuggingFace Datasets库加载数据,其默认的配置文件简化了数据获取流程。该数据集主要用于训练和评估知识图谱生成模型,以及相关自然语言处理任务,如查询生成、答案推理等。利用其结构化的字段,研究人员可以针对性地微调模型,以提升其提取实体关系、生成逻辑查询的能力。同时,数据集中提供的生成查询数量,可作为评估模型生成多样性和覆盖度的指标。由于数据集规模适中,亦适合作为快速验证新算法或接口的测试床,推动知识图谱领域的技术迭代。
背景与挑战
背景概述
KGGen_PURE数据集诞生于知识图谱与自然语言处理交叉领域,由研究团队于近年构建,旨在应对从非结构化文本中自动生成知识图谱查询对(query-answer)的挑战。该数据集以18个精心挑选的论文主题为核心,每个主题包含一篇完整论文内容及对应的生成查询与答案,形式为(essay_topic, essay_content, generated_queries, generated_answers)。其核心研究问题在于评估和推动语言模型在特定领域(如学术论文)中理解和生成结构化知识的能力,为知识图谱构建、信息抽取和问答系统提供基准。尽管规模精简,KGGen_PURE通过高质量标注和主题多样性,为小样本学习、少样本推理及领域适应研究提供了独特价值,其Apache-2.0许可促进了学术与工业界的广泛采用,对推动知识密集型NLP任务的发展具有潜在影响力。
当前挑战
KGGen_PURE所面临的挑战多维且深刻。在领域问题层面,其旨在解决从长篇幅学术文本中自动生成精确、语义连贯的查询-答案对的核心难题,这要求模型不仅具备深度的文本理解能力,还需掌握领域知识的结构化表达,超越了传统信息抽取的局限。构建过程中,挑战尤为显著:仅18个样本的规模凸显了数据稀缺性,如何确保每个主题下生成查询的多样性(数量不等)与答案的准确性,需要人工精校与自动生成的反复迭代。此外,数据集的类型(string与list)混合增加了预处理复杂性,而缺乏验证集和测试集划分,限制了模型评估的客观性与泛化能力的可靠测量。这些挑战共同构成了推动该领域发展的关键障碍,需通过扩大数据规模、引入跨领域主题及标准化评估协议来逐步克服。
常用场景
经典使用场景
KGGen_PURE数据集作为知识图谱生成领域的基准资源,其经典使用场景聚焦于评估和提升基于大语言模型的查询-答案对生成能力。该数据集包含18条结构化样本,每条样本由议论文主题、正文内容及对应的生成查询与答案构成,为研究者提供了从非结构化文本中抽取知识三元组并构建查询-答案对的标准化测试平台。其设计支持对生成模型的鲁棒性、一致性和语义覆盖度进行系统性验证,尤其适用于检索增强生成(RAG)系统中知识库构建环节的算法优化与性能对标。
解决学术问题
该数据集有效缓解了知识图谱自动构建中缺乏高质量黄金标准的问题,为学术研究提供了可控的基准数据以量化模型在知识抽取、语义对齐和查询生成上的表现。通过预设多种主题的作文样本,它助力探索如何从长文本中精准辨识实体关系、消除歧义并生成多样化查询,从而推动了领域内关于数据稀疏性、噪声鲁棒性以及生成多样性等核心难题的实证研究。其公开可复现的特性亦促进了跨模型比较和可重复实验的学术规范。
实际应用
在实际应用中,KGGen_PURE可赋能智能教育辅导系统,基于作文内容自动生成知识点问答,支持个性化学习路径的构建。同时,它可服务于企业级知识管理平台,将非结构化文档转化为结构化知识库,提升信息检索效率。此外,该数据集还可用于自动化评估工具的开发,对语言模型生成的问答质量进行客观打分,进而优化内容型产品的用户交互体验,例如智能客服与内容推荐系统。
数据集最近研究
最新研究方向
KGGen_PURE数据集聚焦于知识图谱生成与查询合成的交叉领域,其最新研究方向在于利用大型语言模型自动生成多样化的查询-答案对,以增强对文本语义的深层理解与推理能力。该数据集包含18个高质量训练样本,每个样本蕴含了主题、文章内容及多组生成查询与答案,为信息检索、自动问答及知识抽取提供了精细化的基准。其研究意义在于推动从静态文本到动态知识结构的转化,促进模型在少样本场景下的泛化性能,并支撑开放域问答系统与教育评估工具的革新。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

