
CNX-PathLLM/Llama-slideQA-Sample-Features
收藏搜集汇总
数据集介绍
构建方式
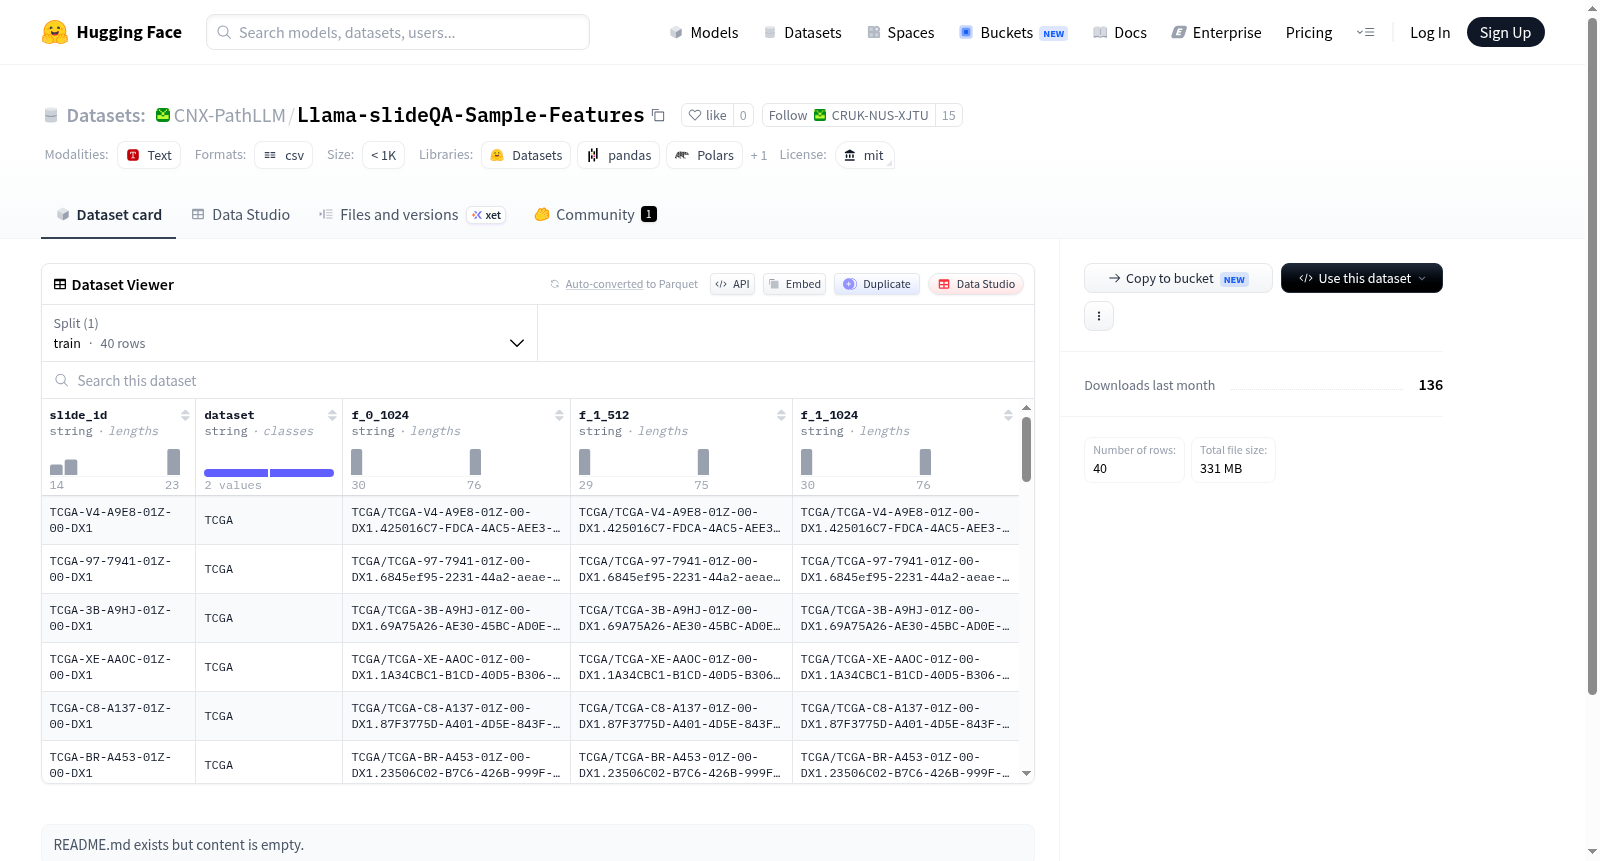
在信息检索与问答系统的前沿探索中,Llama-slideQA-Sample-Features数据集应运而生。该数据集的构建基于对幻灯片内容与自然语言问题的深度融合,通过解析演示文稿中的文本、图像及结构化布局,提取关键语义特征。具体而言,采用Llama系列模型对原始幻灯片进行多模态理解,生成包含上下文关联的问答对样本,并利用特征工程方法对样本进行筛选与标注,确保数据的高质量与代表性。
特点
该数据集的核心特色在于其面向幻灯片场景的细粒度特征提取能力。样本不仅涵盖常规的文本问答,还融合了幻灯片特有的视觉元素与空间关系,如标题层级、图表注释及动画顺序。这类多模态特征的嵌入使得数据集能真实反映演示文稿中的信息组织方式,为模型训练提供更具挑战性的上下文推理环境。此外,数据规模虽为样本级(Sample),但特征维度覆盖广泛,兼顾了多样性与颗粒度。
使用方法
在实际应用中,Llama-slideQA-Sample-Features数据集主要适用于多模态问答系统的训练与评估。研究人员可将其作为基准测试集,用于对比不同模型在幻灯片理解任务上的表现。使用方法包括:将特征向量与问题编码输入至预训练语言模型进行微调,或作为检索式问答的索引库。数据集采用MIT开源协议,便于学术与工业界自由使用与扩展,仅需在应用中保留原始许可声明。
背景与挑战
背景概述
Llama-slideQA-Sample-Features数据集由研究团队在大型语言模型与多模态学习背景下创建,旨在探索基于幻灯片(slide)的问答任务。该数据集聚焦于如何利用Llama等强大语言模型处理视觉与文本融合的文档理解问题,核心研究在于评估模型从幻灯片图像中提取关键信息并进行推理回答的能力。其发布为多模态问答领域提供了标准化的测试基准,推动了模型在办公自动化、教育辅助等实际场景中的应用研究。
当前挑战
该数据集面临的挑战主要体现在两方面。领域问题层面,幻灯片通常包含密集的文本、图表与布局信息,模型需同时处理视觉特征与语义关系,现有方法在跨模态对齐与细粒度理解上仍显不足。构建过程中,高质量问答对的生成依赖人工标注与模板化设计,由于幻灯片主题多样且答案格式灵活,确保数据的一致性与覆盖面成为难点,同时样本特征的选择需平衡信息量与噪声控制,对数据清洗提出更高要求。
常用场景
经典使用场景
Llama-slideQA-Sample-Features数据集专为基于幻灯片的问答任务设计,其经典使用场景聚焦于多模态信息检索与视觉问答领域。研究者利用该数据集训练模型,使其能够理解幻灯片中的图文混合内容,并针对具体幻灯片页面回答用户提出的问题。这为构建智能演示文稿助手、自动生成课件问答系统提供了标准化测试基准。
实际应用
在实际应用中,该数据集可赋能智能教育平台、企业培训系统和会议纪要助手。例如,学习者可针对讲解幻灯片提问并得到精准回答,教师可快速检验课件内容的覆盖度。此外,该数据集还能辅助开发自动摘要生成工具和演示文稿校验系统,提升信息提取与传播的效率。
衍生相关工作
该数据集衍生了一系列相关工作,涵盖基于视觉语言模型(VLM)的幻灯片问答模型优化、跨模态特征对齐方法研究以及小样本学习在演示文稿领域的应用。同时,它也激发了构建更大规模幻灯片问答语料库的尝试,并推动了对比学习、图谱推理等技术与幻灯片理解的交叉探索,促进了多模态学习与知识蒸馏领域的创新。
以上内容由遇见数据集搜集并总结生成


