
phyloforfun/HLT_MICH_Angiospermae_SLTPvA_v1-0__OCR-C25-L25-E25-R05
收藏数据链接:
官方服务:
资源简介:
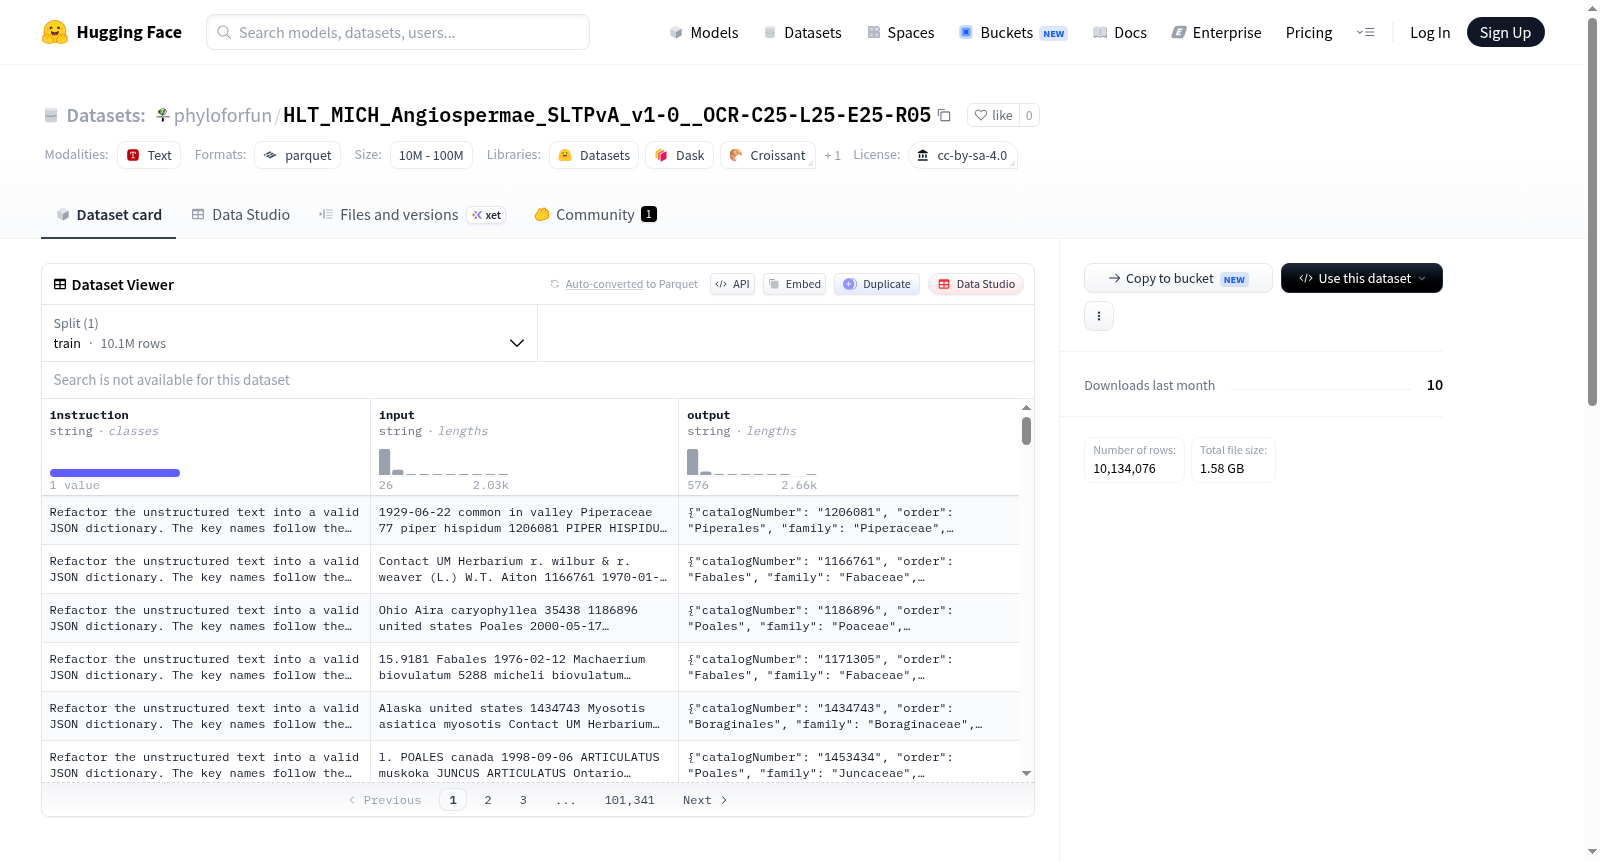
该数据集采用Alpaca格式,包含所有截至2023年11月28日的MICH被子植物条目。数据集还包含合成OCR处理,模拟了OCR噪声和错误。具体来说,25%的单元格会随机变为全大写,25%的单元格会随机变为全小写,25%的行会进行合成OCR增强,5%的字符在OCR增强行中会经历替换、删除或插入错误。此外,OCR增强行还会随机插入字符串以模拟OCR噪声。系统消息要求将非结构化文本重构为符合Darwin Core Archive标准的JSON字典。
该数据集采用Alpaca格式,包含所有截至2023年11月28日的MICH被子植物条目。数据集还包含合成OCR处理,模拟了OCR噪声和错误。具体来说,25%的单元格会随机变为全大写,25%的单元格会随机变为全小写,25%的行会进行合成OCR增强,5%的字符在OCR增强行中会经历替换、删除或插入错误。此外,OCR增强行还会随机插入字符串以模拟OCR噪声。系统消息要求将非结构化文本重构为符合Darwin Core Archive标准的JSON字典。
提供机构:
phyloforfun原始信息汇总
数据集概述
数据集信息
- 特征:
instruction: 字符串类型input: 字符串类型output: 字符串类型
- 分割:
train: 16878481512 字节, 10134076 个样本
- 下载大小: 1579045698 字节
- 数据集大小: 16878481512 字节
- 配置:
default: 数据文件路径为data/train-*
- 许可证: cc-by-sa-4.0
数据集格式
- 格式: Alpaca 格式
- 内容: 截至2023年11月28日(v1-0)的所有MICH Angiospermae条目
合成OCR
- C25: 25%的单元格将随机全部大写
- L25: 25%的单元格将随机全部小写
- E25: 所有行中的25%将进行合成OCR增强
- R05: 在OCR增强行中,每个字符有5%的几率发生替换、删除或插入错误
- 额外: OCR增强行中还会随机插入字符串以模拟OCR噪声
系统消息
- 任务: 将非结构化文本重构为有效的JSON字典
- 键名: 遵循Darwin Core Archive标准
- 内容填充: 如果键缺少内容,则插入空字符串
- JSON结构: json { "catalogNumber": "", "order": "", "family": "", "scientificName": "", "scientificNameAuthorship": "", "genus": "", "subgenus": "", "specificEpithet": "", "verbatimTaxonRank": "", "infraspecificEpithet": "", "identifiedBy": "", "recordedBy": "", "recordNumber": "", "verbatimEventDate": "", "habitat": "", "occurrenceRemarks": "", "associatedTaxa": "", "country": "", "stateProvince": "", "county": "", "municipality": "", "locality": "", "decimalLatitude": "", "decimalLongitude": "", "verbatimCoordinates": "", "minimumElevationInMeters": "", "maximumElevationInMeters": "" }
搜集汇总
数据集介绍
构建方式
该数据集基于密歇根大学植物标本馆(MICH)中被子植物门(Angiospermae)的馆藏记录构建,数据截止至2023年11月28日(版本v1-0)。所有条目被转化为Alpaca格式,形成指令-输入-输出的三元组结构。为确保模型能够处理真实世界中常见的OCR噪声,数据集引入了合成OCR增强技术:25%的单元格被随机转换为全大写(C25),25%的单元格被随机转换为全小写(L25),25%的行整体接受OCR扰动(E25),其中每个字符有5%的概率发生替换、删除或插入错误(R05),并随机插入字符串模拟噪声。最终数据集包含约1013万条训练样本,总大小约16.9 GB。
使用方法
数据集以HuggingFace Datasets格式存储,可直接通过加载默认配置(default)读取训练分片(train-*)。使用时应将输入字段(input)中的非结构化文本与系统指令(system message)结合,引导模型输出符合预定义JSON schema的结构化数据。数据集采用CC-BY-SA-4.0许可协议,允许自由使用与修改。推荐在微调时采用指令微调范式,将instruction字段作为任务描述,input作为含噪声的原始文本,output作为目标JSON字符串。由于数据量庞大,建议使用流式加载或分片处理以优化内存占用。
背景与挑战
背景概述
在生物多样性信息学领域,将非结构化的自然历史标本记录转化为结构化数据是推动生态研究、分类学进展和保护生物学应用的关键步骤。由phyloforfun团队于2023年11月28日创建的HLT_MICH_Angiospermae_SLTPvA_v1-0__OCR-C25-L25-E25-R05数据集,聚焦于密歇根大学植物标本馆(MICH)中的被子植物(Angiospermae)条目,旨在通过合成光学字符识别(OCR)噪声模拟,构建一个大规模、多变的训练资源。该数据集以Alpaca格式组织,包含超过1000万条训练样本,核心研究问题在于训练语言模型将混乱文本精准重构为符合达尔文核心档案(Darwin Core Archive)标准的JSON字典。其影响力体现在为自动化的生物标本数据清洗与标准化提供了基准,推动了自然语言处理在生态信息学中的深度应用。
当前挑战
该数据集面临的挑战首先体现在领域问题的复杂性上:生物标本记录常因历史手写、印刷质量低下或OCR错误而包含大量噪声,例如大小写不一致、字符替换、删除与插入错误,以及随机字符串干扰,这使得从非结构化文本中准确提取并映射至26个达尔文核心字段(如科学名、地点坐标、栖息地描述)成为一项艰巨任务。其次,在构建过程中,合成噪声的配置(如25%全大写、25%全小写、25%行应用OCR增强)需平衡真实性与多样性,避免过度拟合特定噪声模式;同时,处理超过1000万条样本的庞大规模时,须确保数据一致性,例如对无内容字段插入空字符串,并维护JSON结构的严格语法,这对数据验证与计算资源提出了极高要求。
常用场景
经典使用场景
该数据集专为生物多样性信息学中的文本结构化任务而设计,其经典使用场景是将非结构化的植物标本记录转化为符合达尔文核心档案标准的JSON字典。通过模拟光学字符识别(OCR)过程中常见的噪声类型——包括随机全大写、全小写、字符替换、删除与插入错误,以及随机字符串插入——数据集构建了一个高度逼真的训练环境,用于评估和提升语言模型在真实世界OCR噪声下的鲁棒性与泛化能力。
解决学术问题
在学术研究中,该数据集解决了自然语言处理与生物多样性数据交叉领域的一个关键瓶颈:如何从海量、噪声充斥的历史标本标签中自动提取并标准化结构化信息。传统方法依赖人工转录,耗时且易出错。该数据集通过提供大规模、带噪声的指令微调样本,使研究者能够训练模型自动完成从非结构化文本到结构化字段的转换,显著提升了信息提取的准确性与效率,为构建大规模、可计算的生物多样性知识图谱奠定了数据基础。
实际应用
在实际应用中,该数据集可服务于自然历史博物馆、植物标本馆以及生态监测机构的数据数字化流程。通过部署基于该数据集训练的模型,机构能够将纸质或扫描件中的标本标签信息自动批量转换为可查询的数据库记录,从而加速全球生物多样性数据的开放共享与整合。此外,其模拟的OCR噪声场景也适用于其他领域的文档解析任务,如历史文献数字化或医疗记录结构化。
数据集最近研究
最新研究方向
该数据集聚焦于植物标本数字化与自然语言处理交叉领域的前沿探索,利用合成OCR增强技术模拟真实世界中的文本噪声与格式变异,旨在提升从非结构化植物学记录到结构化Darwin Core标准JSON的自动转换能力。研究关注点在于如何通过大规模、多样化的训练样本(涵盖大小写随机化、字符替换、删除与插入错误)增强模型对现实标本标签中常见书写变体与光学识别误差的鲁棒性。这一方向与全球生物多样性信息学中加速标本数据化的迫切需求紧密相连,尤其在应对历史标本数字化过程中海量手写体与打印体混合文本的挑战方面具有重要实践意义。该数据集的构建为开发更智能、更准确的生物多样性信息提取系统奠定了坚实基础,推动了植物分类学数据在生态研究与保护决策中的高效利用。
以上内容由遇见数据集搜集并总结生成


