
RuoliuYang/ULVR-Bench-clean
收藏官方服务:
资源简介:
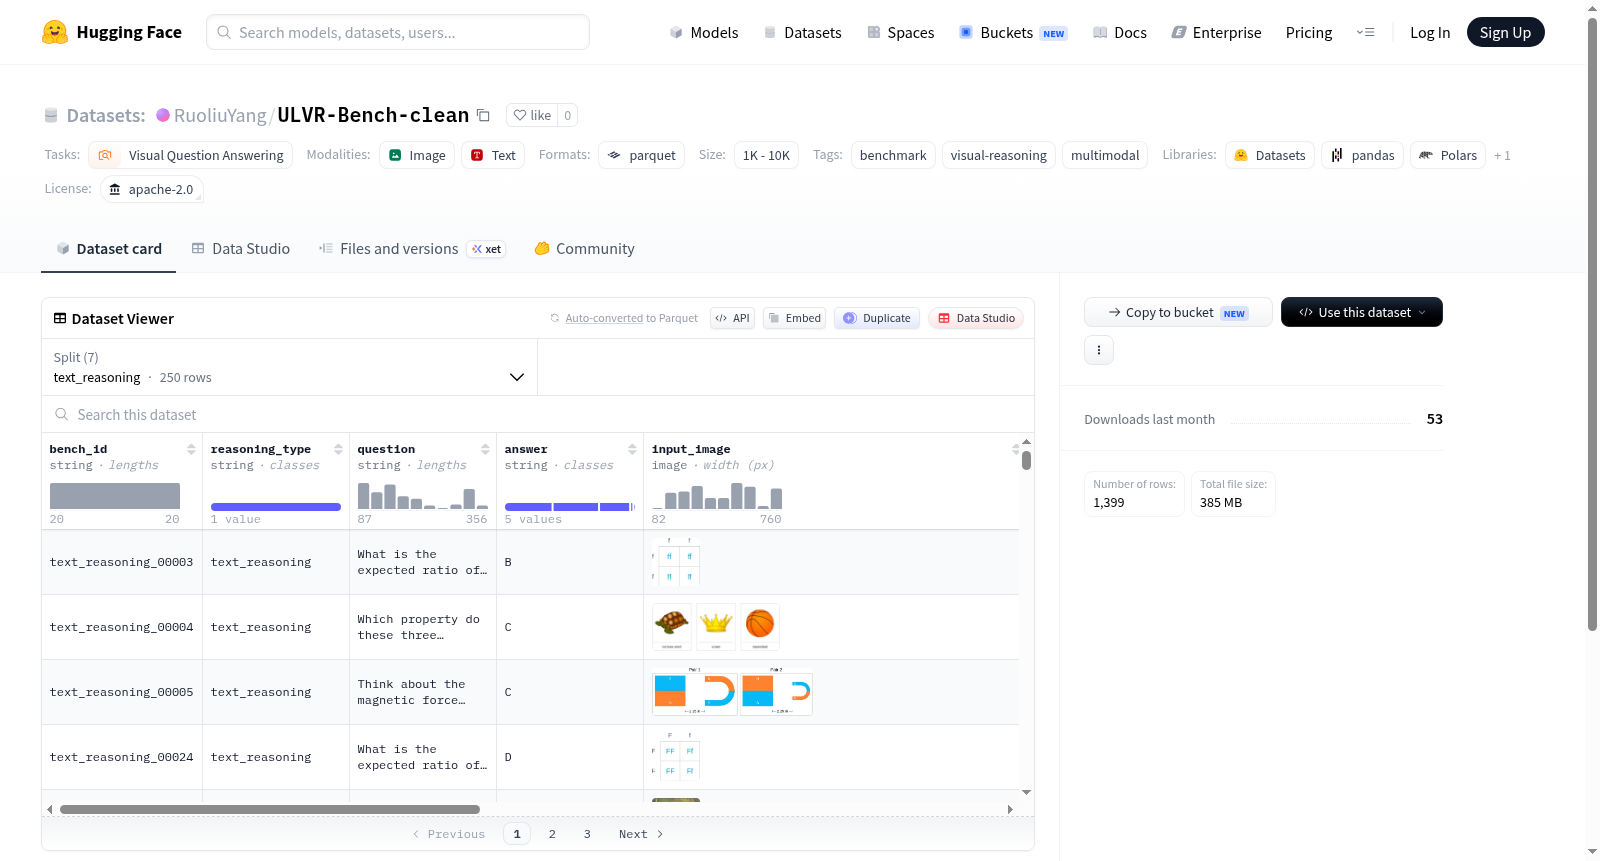
ULVR-Bench(clean)是一个包含1,399个经过筛选样本的数据集,覆盖7种推理类型的分割;评估标准为最终答案准确性。地面真值已根据权威来源验证,并移除了低价值或地面真值错误的项目;分割是平衡的。图像嵌入了HuggingFace图像特征(可预览)。
ULVR-Bench (clean) is a curated dataset containing 1,399 filtered samples, with splits covering 7 types of reasoning. The evaluation criterion is the accuracy of the final answer. The ground truth has been verified against authoritative sources, and items with low value or incorrect ground truth have been removed. The dataset splits are balanced. Images are embedded with HuggingFace image features, which are available for preview.
提供机构:
RuoliuYang搜集汇总
数据集介绍
构建方式
ULVR-Bench-clean 数据集由1,399个精挑细选的样本组成,横跨七种不同的推理类型子集,涵盖文本推理、边界框推理、场景图推理、视觉表示推理、图表推理、文档推理及辅助推理。每个样本的最终答案准确性均经过严格验证,通过与权威标准来源比对确保真实标签无误,并剔除了低质量或标签错误的条目。此外,各子集在样本数量上保持均衡,以消除偏倚。图片内嵌了可预览的 Hugging Face 图像特征,便于直接可视化。
使用方法
ULVR-Bench-clean 可用于评测视觉问答或多模态推理模型的最终答案准确率。用户可通过加载 Hugging Face 数据集接口,按需选择特定推理子集(如 text_reasoning 或 chart_reasoning)进行分项测试。数据集以 Parquet 格式存储,支持高效读取,配合内嵌图片特征即可快速构建评估流程。推荐将模型预测与真实标签对比,以计算跨子集的综合表现,从而洞察模型在各类推理场景中的优势与局限。
背景与挑战
背景概述
ULVR-Bench-clean是一个专为多模态视觉推理评估而设计的基准数据集,创建于近年,由致力于视觉语言理解的研究机构开发。其核心研究问题在于系统化评估多模态模型在多样化推理场景下的表现,涵盖文本推理、边界框推理、场景图推理、视觉表征推理、图表推理、文档推理及辅助推理七个子任务。该数据集通过精心筛选的1,399个样本,确保了标注质量与任务平衡性,对推动多模态学习领域的标准化评测具有重要影响力,为模型在复杂视觉-语言交互中的能力提供了可靠度量。
当前挑战
该数据集主要解决多模态模型在视觉推理任务中面临的领域挑战,包括模型对场景中隐含空间关系、逻辑关联及跨模态信息整合的薄弱理解能力,尤其是在图表与文档等结构化视觉场景中的泛化不足。构建过程中,挑战体现为从海量候选样本中滤除低质量或标注错误的图片,并确保七类推理分组的样本均衡分配,同时需对答案进行严格验证以保证基准测试的可靠性。最终形成的clean版本通过移除噪声数据,提升了评测的准确性与公平性。
常用场景
经典使用场景
ULVR-Bench-clean数据集作为多模态视觉推理领域的标杆性评估基准,其核心应用场景在于系统性地评测视觉-语言模型在复杂推理任务上的表现。该数据集精心策划了1,399个样本,跨越文本推理、边界框推理、场景图推理、视觉表征推理、图表推理、文档推理及辅助推理七大维度,为研究者提供了一个覆盖广泛推理类型的标准化测试平台。通过在此基准上进行测评,研究人员能够客观衡量模型在理解图像细节、解析空间关系、处理结构化信息以及跨模态对齐等关键能力上的优劣,从而推动视觉-语言模型从简单的图像描述迈向深层次认知理解的发展。
解决学术问题
该数据集精准回应了多模态领域中一个长期存在的学术挑战:如何构建一个高质量、无噪声且覆盖全面推理类型的评估基准。此前的研究常受限于数据污染、标注错误或任务单一等问题,导致模型性能评估的可靠性和泛化性存疑。ULVR-Bench-clean通过剔除低价值样本和标注错误项,并经由权威来源进行真值验证,有效解决了评估结果的可信度问题。其意义在于为学术界提供了一个纯净、平衡且严谨的测试环境,使得不同模型在视觉推理能力上的比较更加公平和透明,从而加速了更为鲁棒和智能的多模态理解算法的研究进程。
实际应用
在实际应用层面,ULVR-Bench-clean所涵盖的推理能力直接服务于众多高价值产业场景。例如,图表推理和文档推理能力可赋能智能办公系统,实现自动化的财务报告分析和票据信息提取;场景图推理和边界框推理技术则能够提升自动驾驶系统中对道路环境与障碍物的理解精度;而视觉表征推理与文本推理的结合,可应用于医疗影像辅助诊断,帮助模型从复杂医学图像中定位病灶并理解其临床描述。此外,该基准所推动的模型进步,还能显著增强智能客服、视觉问答助手以及内容审核系统在处理多模态信息时的准确性与可靠性。
数据集最近研究
最新研究方向
ULVR-Bench-clean作为多模态视觉推理基准的最新研究方向,聚焦于构建细粒度、结构化且高质量的逻辑推理评估体系。该数据集通过划分文本推理、边界框推理、场景图推理、视觉表征推理等七类专业化子集,精准检验模型在复杂视觉场景下的认知深度,尤其针对当前多模态大模型在图表解析、文档理解及辅助推理等前沿热点任务中的系统性短板。其地面真值经权威来源验证,剔除噪音与错误项,确保了评估的可靠性与公平性,显著推动了面向真实世界应用的多模态推理能力量化研究,对于提升自主导航、智能文档分析等实际系统的鲁棒性具有深远影响。
以上内容由遇见数据集搜集并总结生成


