
UltraSuite-Cleft-Audio
收藏官方服务:
资源简介:
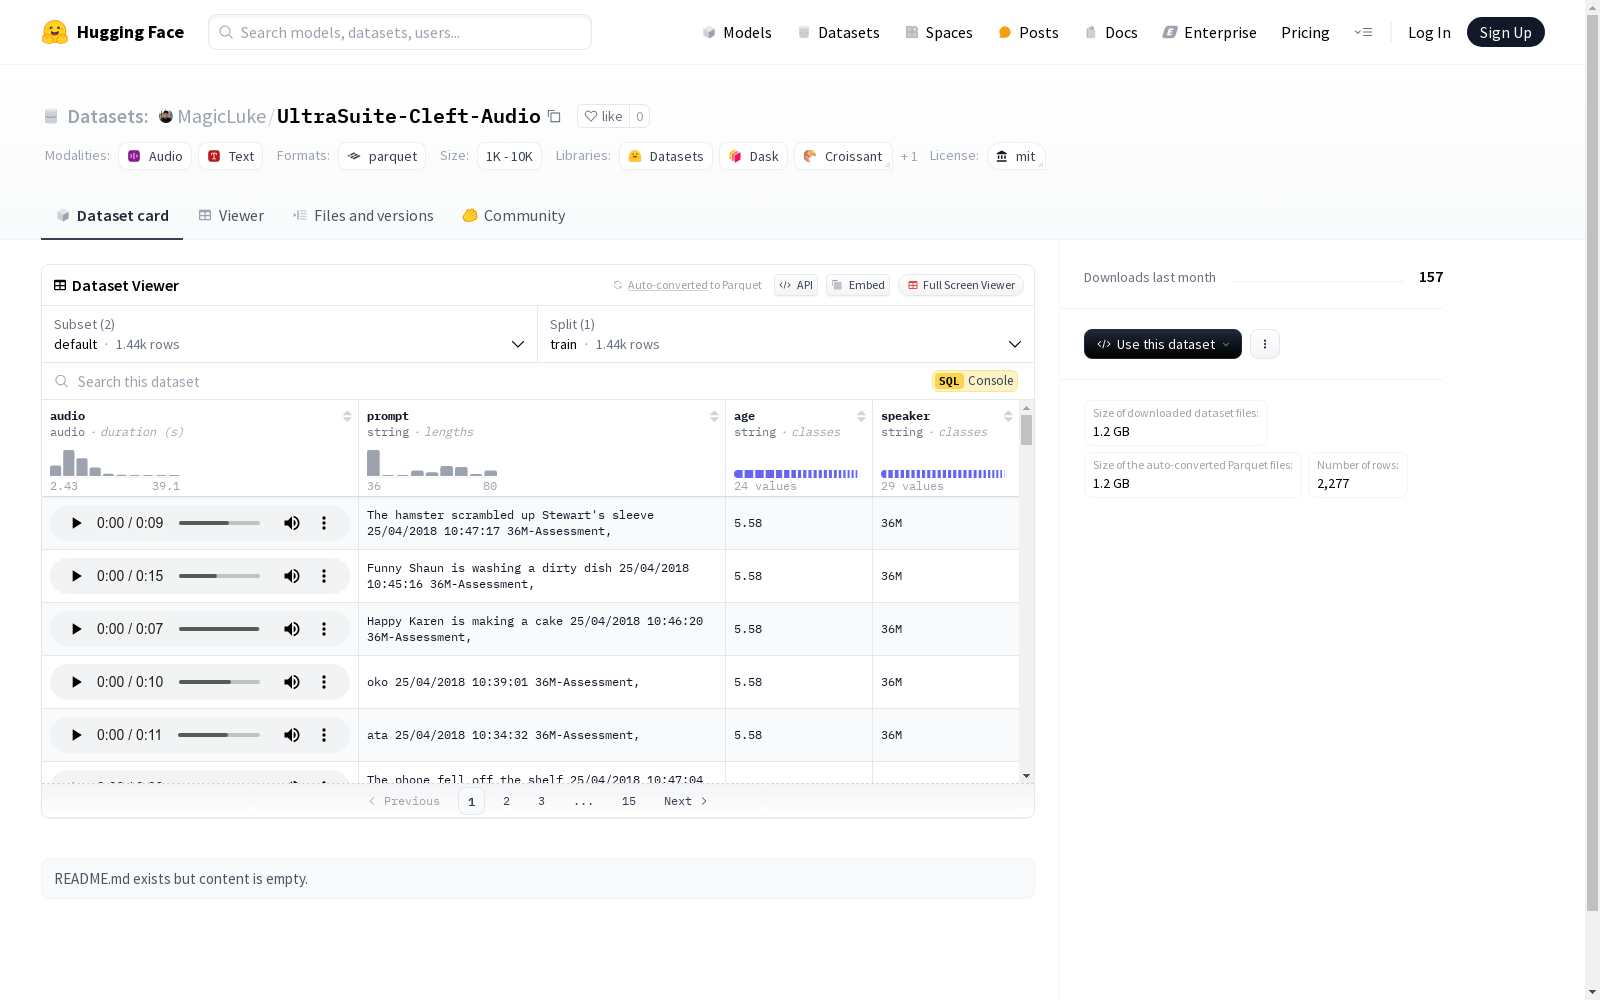
该数据集包含音频文件、提示文本、年龄和说话者信息。音频文件的特征类型为音频,提示文本、年龄和说话者信息均为字符串类型。数据集分为一个训练集,包含1441个样本,总大小为660496361.607字节。数据集的下载大小为623254630字节。
This dataset contains audio files, prompt texts, age information, and speaker information. The audio files are of the audio feature type, whereas the prompt texts, age information, and speaker information are all string-type data. The dataset comprises a single training set with 1441 samples, and its total size is 660496361.607 bytes. The download size of the dataset is 623254630 bytes.
创建时间:
2024-12-01
原始信息汇总
UltraSuite-Cleft-Audio 数据集概述
许可证
- MIT
数据集信息
特征
- audio: 音频数据,数据类型为
audio - prompt: 提示信息,数据类型为
string - age: 年龄信息,数据类型为
string - speaker: 说话者信息,数据类型为
string
数据分割
- train: 训练集
- 字节数: 660496361.607
- 样本数: 1441
数据大小
- 下载大小: 623254630 字节
- 数据集大小: 660496361.607 字节
配置
- config_name: default
- data_files:
- split: train
- path: data/train-*
- data_files:
搜集汇总
数据集介绍
构建方式
UltraSuite-Cleft-Audio数据集的构建基于对语音数据的精细采集与整理。该数据集包含了多个配置版本,其中'default'配置涵盖了1441个训练样本,而'v1.0'配置则进一步细分为多个子集,每个子集对应不同性别和年龄段的语音样本。数据集的构建过程中,语音数据被标准化为16kHz的采样率,确保了数据的一致性和可用性。此外,每个样本均附带了提示信息、年龄和说话者标识,以便于后续的分析与应用。
特点
UltraSuite-Cleft-Audio数据集的显著特点在于其多样性和精细分类。数据集不仅涵盖了广泛的年龄段和性别,还通过不同的配置版本提供了灵活的使用选择。每个语音样本均附带详细的元数据,如提示信息和说话者标识,这为语音分析和模型训练提供了丰富的上下文信息。此外,数据集的音频质量经过标准化处理,确保了在不同应用场景下的稳定表现。
使用方法
UltraSuite-Cleft-Audio数据集适用于多种语音处理任务,包括但不限于语音识别、语音合成和语音情感分析。用户可以根据具体需求选择不同的配置版本,并利用附带的元数据进行精细化的模型训练。数据集的音频文件可以直接用于特征提取或模型输入,而提示信息和说话者标识则可用于增强模型的上下文理解能力。通过合理的数据划分和预处理,该数据集能够为语音技术研究提供坚实的基础。
背景与挑战
背景概述
UltraSuite-Cleft-Audio数据集由专业研究人员和机构创建,专注于收集和分析与唇腭裂患者相关的语音数据。该数据集的核心研究问题在于探索唇腭裂对语音特征的影响,以及如何通过语音分析技术为患者提供更精准的诊断和治疗方案。通过收集不同年龄段和性别的患者语音样本,研究人员旨在揭示语音特征与唇腭裂之间的复杂关系,从而推动语音病理学和语言治疗领域的发展。
当前挑战
UltraSuite-Cleft-Audio数据集在构建过程中面临多项挑战。首先,收集高质量的语音数据需要克服患者语音多样性和个体差异的难题,确保数据的代表性和准确性。其次,数据标注和分类过程中需处理语音特征的复杂性,如音调、语速和发音清晰度等,这些特征因患者个体差异而变化。此外,数据集的多样性和规模也带来了存储和处理上的技术挑战,需确保数据的高效管理和分析。
常用场景
经典使用场景
UltraSuite-Cleft-Audio数据集在语音学和语言病理学领域中具有广泛的应用。该数据集主要用于研究唇腭裂患者的语音特征,通过分析不同年龄段和性别的语音样本,研究者可以深入探讨语音产生的生理和病理机制。此外,该数据集还可用于开发和验证语音识别系统,特别是在处理非典型语音模式时,提升系统的鲁棒性和准确性。
衍生相关工作
基于UltraSuite-Cleft-Audio数据集,许多相关研究工作得以展开。例如,有研究者利用该数据集开发了新的语音特征提取算法,以更准确地识别和分类不同类型的语音障碍。此外,该数据集还激发了多篇关于语音生成模型和语音合成技术的论文,推动了语音处理领域的技术进步。
数据集最近研究
最新研究方向
在语音处理领域,UltraSuite-Cleft-Audio数据集的最新研究方向主要集中在语音障碍患者的语音特征分析与建模。该数据集通过收集不同年龄段和性别的语音样本,为研究者提供了丰富的语音数据资源,尤其是在唇腭裂患者的语音特征研究中具有重要意义。前沿研究聚焦于利用深度学习技术对这些语音样本进行精细化分析,以期为语音障碍的诊断和治疗提供更为精准的工具。此外,该数据集的应用还扩展至语音合成与识别领域,旨在提升针对特殊语音群体的语音技术性能,从而推动语音处理技术的包容性与普适性发展。
以上内容由遇见数据集搜集并总结生成


