ArXivSignals
收藏资源简介:
ArXivSignals是一个持续更新、按日期分区的数据集,收录了arXiv预印本平台中人工智能、机器学习及相关领域的学术论文。该数据集的核心价值在于提供了由大型语言模型(LLM)生成的增强信号,旨在辅助研究人员快速筛选和理解论文。数据集包含两个主要配置:1)papers配置(默认),为每篇论文提供完整的元数据(如标题、摘要、作者、分类)以及LLM衍生的丰富信息,包括0-100分的兴趣度与信号评分、一句话核心摘要、论文贡献类型(如新方法、数据集、综述)、所属机构标签、主题关键词以及部分论文的详细Markdown总结。2)thumbnails配置,提供每篇论文的ID及其首页渲染的缩略图。数据来源分为两部分:论文的文献目录信息(标题、摘要、作者等)来自arXiv(CC0许可),而所有增强字段(评分、标签、摘要等)则由ArXivSignals项目通过LLM分析生成,并以CC-BY-4.0许可发布。数据集每日更新(通常为周日至周四),覆盖范围侧重于AI/ML类别,并非arXiv的完整镜像。它适用于文本分类、信息检索、文本摘要、特征提取等任务,可作为论文推荐、研究趋势分析或快速文献调研的开放资源。
ArXivSignals is a continuously updated, date-partitioned dataset that collects academic papers in artificial intelligence, machine learning and related fields from the arXiv preprint platform. The core value of this dataset lies in providing augmented signals generated by large language models (LLMs), aiming to assist researchers in quickly screening and understanding papers. The dataset includes two main configurations: 1) The `papers` configuration (default) provides complete metadata for each paper (such as title, abstract, authors, categories) and rich LLM-derived information, including an interest and signal score ranging from 0 to 100, a one-sentence core summary, paper contribution types (such as new methods, datasets, reviews), affiliation tags, topic keywords, and detailed Markdown summaries for some papers. 2) The `thumbnails` configuration provides the ID of each paper and its homepage-rendered thumbnails. The data sources are divided into two parts: the bibliographic information of the papers (title, abstract, authors, etc.) comes from arXiv (CC0 license), while all augmented fields (scores, tags, summaries, etc.) are generated by the ArXivSignals project through LLM analysis and released under the CC-BY-4.0 license. The dataset is updated daily (usually Sunday to Thursday), and its coverage focuses on AI/ML categories rather than being a complete mirror of arXiv. It is applicable to tasks such as text classification, information retrieval, text summarization, and feature extraction, and can serve as an open resource for paper recommendation, research trend analysis, or rapid literature review.
数据集名称:ArXivSignals — Daily arXiv Papers with LLM Signal & Summaries
数据集链接: https://huggingface.co/datasets/taesiri/ArXivSignals
许可协议: CC-BY-4.0
语言: 英语
任务类别: 文本分类、文本检索、摘要、特征提取
数据规模: 1K < 样本量 < 100K
数据集简介
这是一个持续更新的、按天分区的arXiv论文数据集(涵盖AI/ML及相关类别),通过大语言模型(LLM)进行富化,为每篇论文提供0–100的重要性评分、主题/实验室标签、一行总结,并为部分论文提供详细的全文摘要。该数据集用于驱动 arxivsignals.io 服务,并作为开放研究资源发布。
数据集配置(Configs)
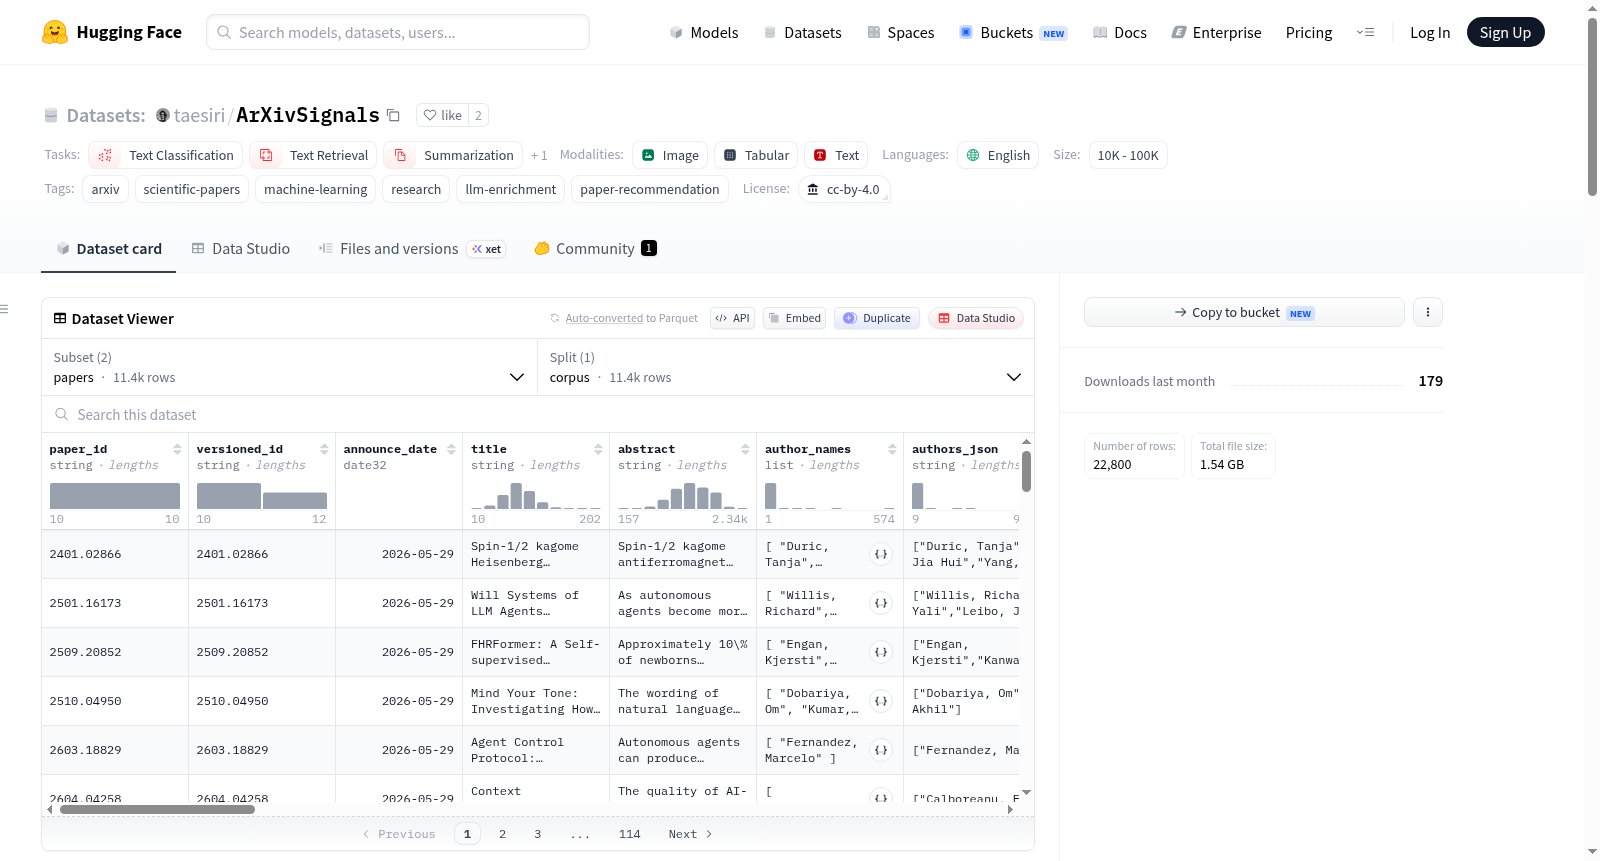
papers(默认):每行代表一篇论文,包含参考文献信息、LLM富化结果及标签。thumbnails:包含paper_id和论文第一页的渲染图像(PIL图片格式)。
两个配置均按 announce_date 进行分区(路径格式:data/papers/date=YYYY-MM-DD/…),可直接使用Parquet读取器读取指定日期。每个配置仅包含一个名为 corpus 的拆分,代表全量数据,无训练/测试划分。
主要字段说明(papers 配置)
| 字段名 | 类型 | 来源 | 说明 |
|---|---|---|---|
paper_id |
字符串 | arXiv | 去掉版本的arXiv规范ID |
versioned_id |
字符串 | arXiv | 带版本后缀的arXiv ID |
announce_date |
日期 | arXiv | 分区键 |
title, abstract |
字符串 | arXiv | 论文标题和摘要 |
author_names |
列表[字符串] | arXiv | 作者显示名称 |
authors_json |
字符串 | arXiv | 完整的作者结构(JSON格式) |
categories |
列表[字符串] | arXiv | 论文类别,如["cs.CV","stat.ML"] |
primary_category |
字符串 | arXiv | 主要类别 |
page_count |
整数 | arXiv | 论文页数 |
one_liner |
字符串 | ArXivSignals(LLM) | 不超过20个单词的核心总结 |
contribution_type |
字符串 | ArXivSignals(LLM) | 贡献类型(如新方法、数据集、综述等) |
affiliations |
列表[字符串] | ArXivSignals(LLM) | 从论文中提取的机构信息 |
interest_score |
整数 | ArXivSignals(LLM) | 提取时的兴趣估计分数(0–100) |
interest_reason |
字符串 | ArXivSignals(LLM) | 兴趣分数的简短理由(≤15词) |
releases_code, claims_sota |
布尔值 | ArXivSignals(LLM) | 是否发布代码、是否声称SOTA |
signal_score |
整数 | ArXivSignals(LLM) | 排名信号,基于固定规则评分的0–100分数 |
signal_reason |
字符串 | ArXivSignals(LLM) | 该分数给出的原因 |
signal_model |
字符串 | ArXivSignals | 生成 signal_score 的模型 |
summary_long |
字符串 | ArXivSignals(LLM) | 详细的Markdown格式摘要(仅部分论文有) |
summary_graph_json |
字符串 | ArXivSignals(LLM) | 结构化的架构图(JSON格式),可能为null |
summary_model |
字符串 | ArXivSignals | 生成摘要的模型 |
extraction_model |
字符串 | ArXivSignals | 生成标签和一行总结的模型 |
enriched_at |
字符串 | ArXivSignals | 富化时间戳 |
keyword_slugs / keyword_labels |
列表[字符串] | ArXivSignals(LLM) | 规范化的主题标签 |
lab_slugs / lab_labels |
列表[字符串] | ArXivSignals(LLM) | 识别出的实验室/机构 |
free_keywords |
列表[字符串] | ArXivSignals(LLM) | 自由形式的特定术语 |
数据来源与许可
- 参考文献字段(标题、摘要、作者、类别等)来源于arXiv,遵循 CC0 许可协议。
- 富化字段(信号评分、标签、摘要、一行总结)为ArXivSignals原创分析结果,采用 CC-BY-4.0 许可协议。
数据集中不包含PDF或LaTeX源码,仅包含元数据、富化结果及低分辨率的第一页缩略图。如需移除某篇论文的缩略图或富化结果,可在数据集讨论区提出。
注意事项
- 富化结果由模型生成,信号评分、摘要和标签可能存在错误或偏差,仅作为快速筛选的参考,不应视为绝对真理。每行数据中通过
*_model字段记录了生成模型的来源。 - 覆盖范围偏向于ArXivSignals追踪的AI/ML类别,并非arXiv的完整镜像。
- 数据在管道运行的大部分日期(约周日到周四)更新,当有新的摘要添加到较早的论文时,某些日期可能在提交历史中重新出现。
引用方式
bibtex @misc{arxivsignals_dataset, title = {ArXivSignals: Daily arXiv Papers with LLM Signal and Summaries}, author = {ArXivSignals}, url = {https://arxivsignals.io}, note = {Hugging Face dataset} }