TheFinAI/freebsd-cvs-archive
收藏资源简介:
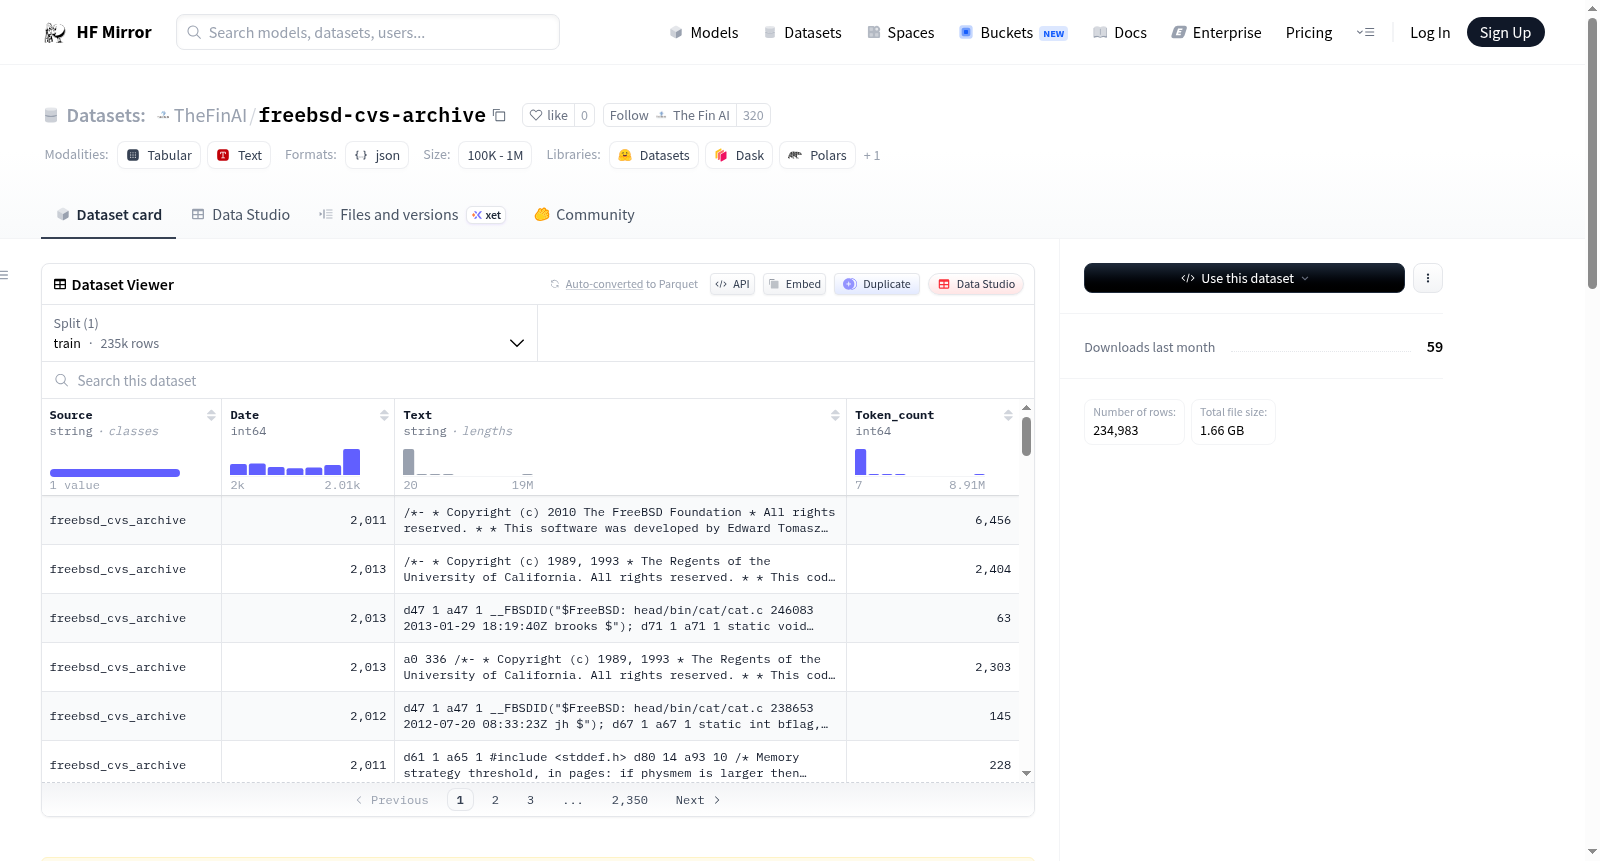
# 📦 FreeBSD CVS Archive (C/C++) ## Dataset Summary **FreeBSD CVS Archive (C/C++)** is a large-scale dataset of source code extracted from the historical FreeBSD CVS repository. The dataset focuses on **C and C++ source files**, providing structured samples suitable for code modeling, analysis, and benchmarking. Each sample includes: - the dataset source - commit year - extracted code content - token count (computed using GPT tokenizer) This dataset is designed for: - code language modeling - software evolution analysis - code understanding and generation - benchmarking LLMs on real-world system code --- ## Dataset Structure Each record follows a simple JSONL format: ```jsonl { "Source": "freebsd-cvs-archive", "Date": 2003, "Text": "... C/C++ source code ...", "Token_count": 512 } ``` ## Fields Source: Name of the dataset Date: Year extracted from CVS revision metadata Text: Raw C/C++ code snippet Token_count: Number of tokens computed using tiktoken (cl100k_base) ## Source Data The dataset is derived from: FreeBSD CVS archive ([historical version control system](https://download.freebsd.org/development/CVS-archive/)) ## Processing Processing Pipeline The dataset was constructed using the following steps: Parse CVS revision files Extract revision metadata (commit date → year) Extract text blocks (code sections between CVS delimiters) Filter samples (remove empty or short entries) Keep only C/C++ code Compute token counts using tiktoken Split into fixed-size JSONL shards
# 📦 FreeBSD CVS 存档(C/C++) ## 数据集概述 **FreeBSD CVS 存档(C/C++)**是从历史FreeBSD CVS版本控制系统仓库中提取的大规模源代码数据集。本数据集聚焦**C与C++源代码文件**,提供适用于代码建模、分析与基准测试的结构化样本。 每个样本包含以下内容: - 数据集来源 - 提交年份 - 提取的代码内容 - Token计数(采用GPT分词器计算) 本数据集适用于以下场景: - 代码语言建模 - 软件演化分析 - 代码理解与生成 - 针对真实世界系统代码的大语言模型(Large Language Model,LLM)基准测试 --- ## 数据集结构 每条记录采用简洁的JSONL格式: jsonl { "Source": "freebsd-cvs-archive", "Date": 2003, "Text": "... C/C++ 源代码 ...", "Token_count": 512 } ## 字段说明 Source: 数据集名称 Date: 从CVS修订元数据中提取的提交年份 Text: 原始C/C++代码片段 Token_count: 采用tiktoken(cl100k_base)计算的Token数量 ## 源数据 本数据集源自:FreeBSD CVS 存档([历史版本控制系统](https://download.freebsd.org/development/CVS-archive/)) ## 处理流程 ### 处理流水线 本数据集通过以下步骤构建: 1. 解析CVS修订文件 2. 提取修订元数据(将提交日期转换为年份) 3. 提取文本块(CVS分隔符之间的代码段) 4. 过滤样本(移除空条目与过短样本) 5. 仅保留C/C++代码 6. 采用tiktoken计算Token计数 7. 拆分为固定大小的JSONL分片