
alexandrainst/ragtruth-translated-hallucinations-backup
收藏数据链接:
官方服务:
资源简介:
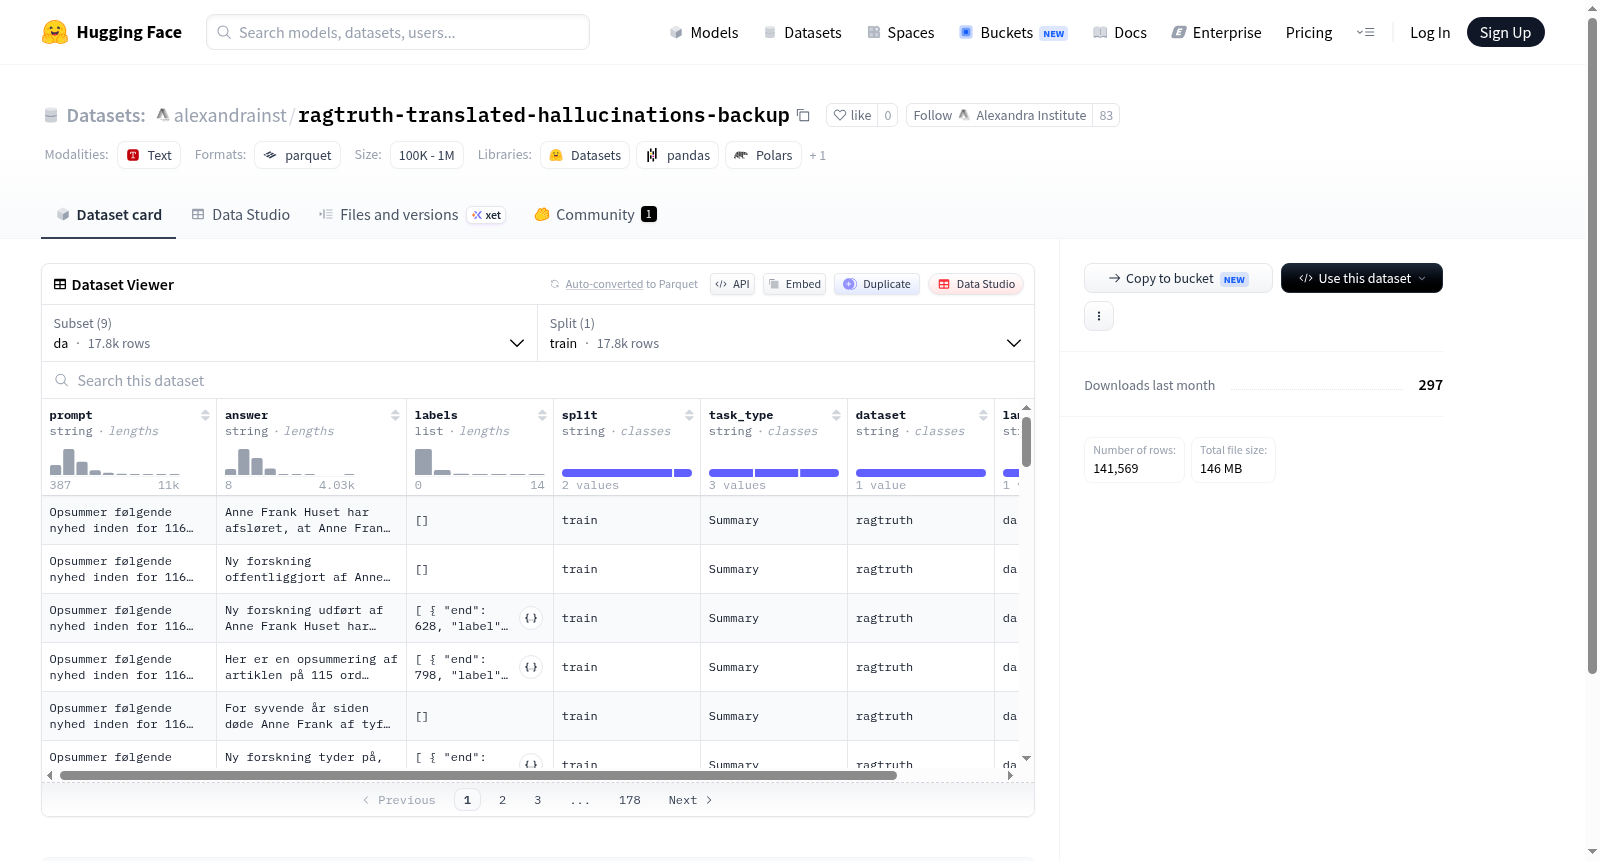
该数据集包含9种语言(丹麦语、德语、英语、西班牙语、冰岛语、斯洛文尼亚语、阿尔巴尼亚语、瑞典语、乌克兰语)的命名实体识别(NER)数据。每个样本包含提示(prompt)、答案(answer)、实体标签(labels,包括起始位置、结束位置和标签类型)、分割(split)、任务类型(task_type)、数据集来源(dataset)和语言(language)。每个语言配置仅包含训练集,样本数量从988到17790不等。
This dataset contains Named Entity Recognition (NER) data for 9 languages (Danish, German, English, Spanish, Icelandic, Slovenian, Albanian, Swedish, Ukrainian). Each sample includes a prompt, answer, entity labels (with start, end, and label type), split, task type, dataset source, and language. Each language configuration only includes a training set, with sample sizes ranging from 988 to 17790.
提供机构:
alexandrainst搜集汇总
数据集介绍
构建方式
在检索增强生成(RAG)技术日益普及的背景下,幻觉现象成为制约大语言模型可靠性的关键挑战。RAGTruth-Translated-Hallucinations-Backup数据集应运而生,其构建过程以跨语言标注为核心。基于原始RAGTruth数据,研究者通过专业翻译工具将英文问答对及标注扩展至丹麦语、德语、西班牙语、冰岛语、斯洛文尼亚语、阿尔巴尼亚语、瑞典语和乌克兰语共九种语言。每条数据包含用户提示、模型回答、基于字符级别的幻觉标签(标注起始位置、结束位置及标签类型)、任务类型、数据来源及语言标识,形成结构化的幻觉标注体系。
特点
该数据集呈现出鲜明的多语言平衡特性:除斯洛文尼亚语约千条外,其余语言均包含约1.7万条训练样本,确保跨语言研究的基础规模。每个样本均提供细粒度字符级幻觉标注,将回答中可能存在的事实性错误、逻辑矛盾或信息缺失精确标记,并区分不同任务类型(如对话、摘要等)。数据集覆盖斯堪的纳维亚语系、日耳曼语系、罗曼语族、斯拉夫语族等多种语言族,为评估RAG系统在不同语言环境下的幻觉表现提供了宝贵的基准测试资源。
使用方法
使用该数据集时,可通过HuggingFace Datasets库指定配置名称加载对应语言子集,例如以'dataset.load_dataset("ragtruth-translated-hallucinations-backup", "en", split="train")'的形式获取英语数据。每条样本中的labels字段包含起始位置、结束位置及标签类型,研究者可据此提取模型回答中的幻觉片段,计算跨度召回率、精确率等指标。数据集提供train分片,适用于训练跨语言幻觉检测模型或评估RAG系统的忠实度表现,也可用作微调多语言生成模型的对抗性样本。
背景与挑战
背景概述
ragtruth-translated-hallucinations-backup数据集由多语言研究者团队构建,旨在探讨检索增强生成(RAG)系统中幻觉现象的跨语言特征。该数据集于2023年左右创建,覆盖丹麦语、德语、英语等9种语言,每个子集包含约1.6万至1.8万条样本,聚焦于模型在给定提示和上下文后生成答案时的忠实度问题。其核心研究问题是量化并分类RAG模型在不同语言中产生的幻觉类型(如事实性错误或上下文偏离),从而为多语言自然语言处理提供了关键基准。该数据集的发布填补了现有幻觉检测资源主要集中在英语上的空白,推动了低资源语言环境下模型可靠性的评估,对提升多语言AI系统的可信度具有重要影响。
当前挑战
该数据集面临的领域挑战在于RAG系统生成的答案虽基于外部知识库,却常偏离事实或上下文,这种幻觉现象在跨语言场景下尤为显著,因不同语言的知识覆盖与模型训练不均导致误差模式各异。构建过程中的挑战包括:多语言标注的一致性难以保证,需要跨语言团队统一幻觉界定标准;数据收集需平衡各语言的样本量与代表性,如斯洛文尼亚语子集仅988条,远少于其他语言;翻译后标注的漂移问题,即原始语言中的幻觉标注在翻译后可能失去准确语义,需人工复核以确保标签可靠性。这些复杂性考验着数据集的鲁棒性与泛化能力。
常用场景
经典使用场景
在检索增强生成(RAG)系统的研究中,准确识别并定位模型生成的幻觉内容(hallucinations)是评估系统可靠性的核心任务。该数据集提供了多语言(涵盖英语、德语、西班牙语、阿尔巴尼亚语等九种语言)的Prompt-Answer对,并在每个答案中以字符级粒度标注了幻觉片段的起始位置、结束位置及具体标签。经典用法是将其作为训练或测试集,用于构建能够检测RAG系统中答案与检索上下文之间不一致性的分类模型或序列标注模型,从而量化模型生成内容的事实准确性。
实际应用
在实际产业部署中,RAG系统被广泛用于智能客服、知识问答、医疗辅助诊断等场景,而生成内容的幻觉可能导致严重的信息误导。本数据集可用于开发自动化的幻觉审查流水线,帮助部署RAG服务的企业或平台自动标记并纠正模型产生的虚假信息。例如,在多语言客服场景中,系统可借助基于该数据集训练的检测模型,精准定位并高亮中文、英语等不同语言回复中与知识库矛盾的片段,从而辅助人工审核并提升最终输出内容的可信度与安全性。
衍生相关工作
该数据集衍生了一系列重要的研究工作,包括基于跨语言预训练模型(如mBERT、XLM-R)的幻觉检测器开发,以及针对低资源语言(如斯洛文尼亚语、冰岛语)的迁移学习方法探索。此外,利用其字符级标注特性,部分工作将其与序列标注框架(如BiLSTM-CRF或Transformer-CRF)结合,实现了对各种RAG系统(如FiD、Atlas)生成结果的细粒度质量评估。还有研究基于该数据集提出了若干针对RAG幻觉类型的分类体系,从而引导后续工作更精准地定义和缓解不同类型的事实性错误。
以上内容由遇见数据集搜集并总结生成


