
遇见数据集

Harvard-DCML/tis-dolci-subset-datasets-SmolLM3-3B-Base

收藏
Hugging Face2026-05-26 更新2026-05-31 收录
官方服务:

资源简介:

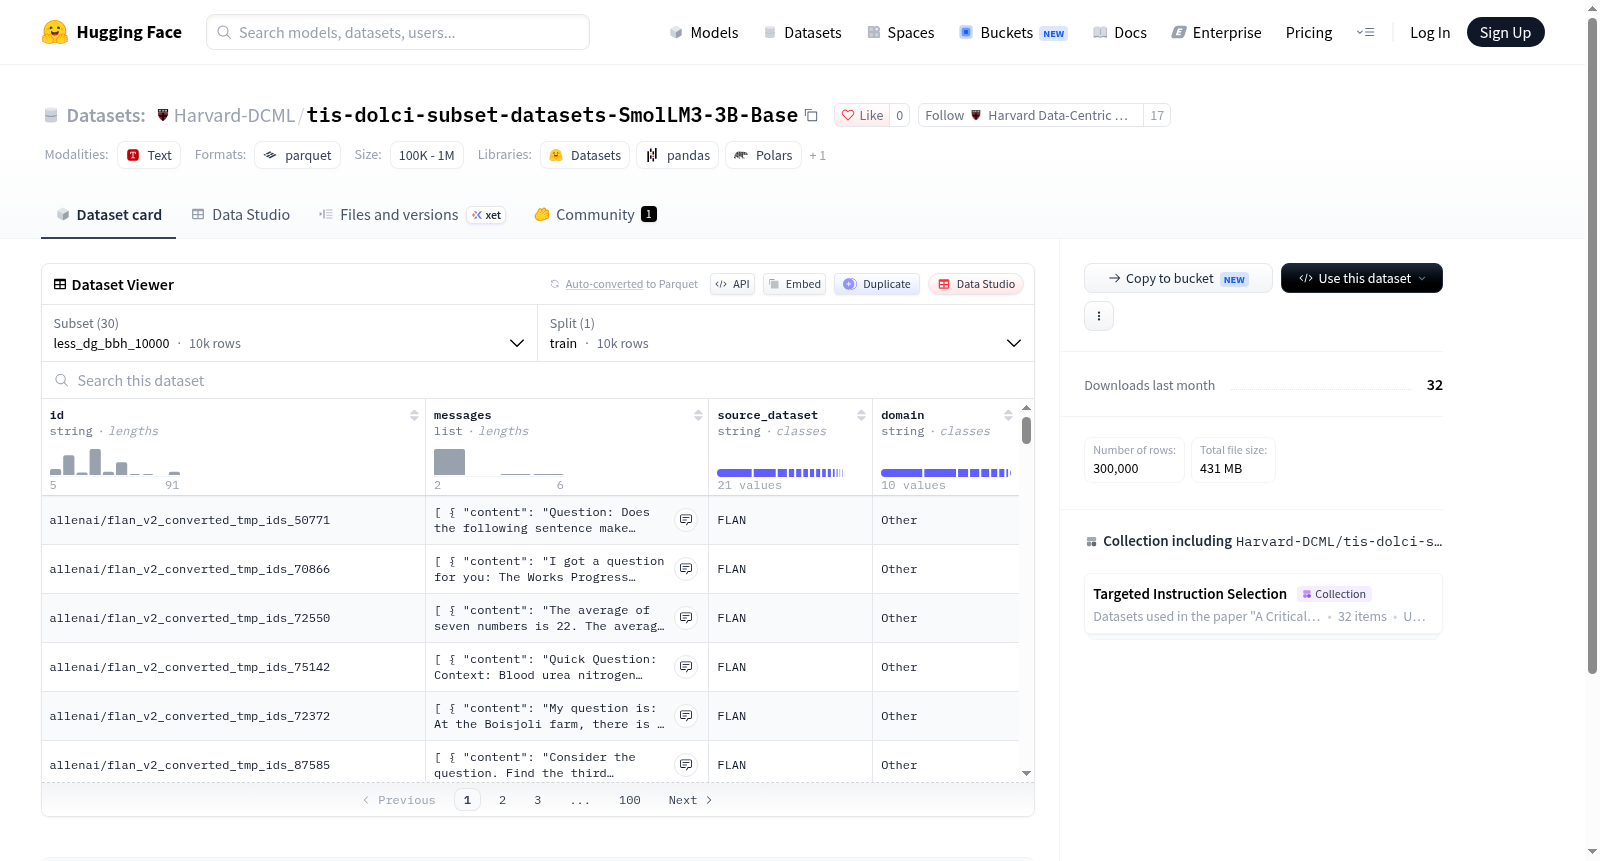
该数据集包含多个配置,每个配置基于不同的源数据集(如BBH、Codex、GSM8K、MMLU-Pro、TyDiQA)和采样方法(如less_dg、less_knn_kde、less_knn_uniform、less_rr、less_uot、rds_rr)生成,用于训练或评估语言模型。每个配置包含10000个训练示例,特征包括id、消息列表(含内容、角色等)、源数据集和领域信息。数据集旨在支持多样化任务,如推理、问答和代码生成,通过不同采样策略增强模型泛化能力。

This dataset includes multiple configurations, each generated from different source datasets (e.g., BBH, Codex, GSM8K, MMLU-Pro, TyDiQA) and sampling methods (e.g., less_dg, less_knn_kde, less_knn_uniform, less_rr, less_uot, rds_rr), designed for training or evaluating language models. Each configuration contains 10,000 training examples, with features such as id, messages list (including content, role, etc.), source dataset, and domain information. The dataset aims to support diverse tasks like reasoning, question answering, and code generation, enhancing model generalization through varied sampling strategies.
提供机构:
Harvard-DCML
搜集汇总
数据集介绍
Harvard-DCML/tis-dolci-subset-datasets-SmolLM3-3B-Base 数据集图片
构建方式
在大语言模型数据筛选与课程学习的研究背景下,该数据集的构建依托SmolLM3-3B-Base模型,针对BBH、Codex、GSM8K、MMLU Pro和TydiQA五个下游任务领域,分别采用LESS、KNN-KDE、KNN-Uniform、LESS-RR、LESS-UOT以及RDS-RR等多种数据选择策略,从原始语料中筛选出每类任务一万条训练样本,并以统一的对话消息格式进行序列化封装,最终形成三十个可独立加载的子集配置。
特点
该数据集以多领域、多策略的交叉组合为核心特征,涵盖推理、代码、数学、知识问答和多语言问答等异质任务,每个子集均保持一万条样本的均衡规模。样本以包含角色、内容、函数调用等字段的结构化消息列表呈现,并附带来源数据集与领域标签,便于追溯数据血缘并支撑跨策略的对比分析。
使用方法
研究者可通过HuggingFace datasets库以配置名加载任意子集,例如指定less_dg_gsm8k_10000即可获取对应策略与领域的训练数据。加载后可直接用于监督微调或数据选择效果的消融实验,借助source_dataset与domain字段进行分组统计与性能归因分析,从而评估不同数据筛选策略在特定任务上的效用差异。
背景与挑战
背景概述
随着大语言模型在自然语言处理领域的广泛应用,数据选择策略对模型微调效果的影响日益受到关注。tis-dolci-subset-datasets-SmolLM3-3B-Base数据集由HuggingFace社区研究人员构建,旨在为SmolLM3-3B-Base模型提供系统化的子集数据选择实验基准。该数据集整合了BBH、Codex、GSM8K、MMLU-Pro及TyDiQA五个核心基准,通过LESS、RDS等多种数据选择算法生成不同配置的训练子集,每类子集均包含一万条样本。其核心研究问题在于探究不同数据选择策略对模型下游任务性能的影响,为数据高效利用与模型微调优化提供了重要的实证基础,对推动数据-centric的人工智能研究具有显著价值。
当前挑战
该数据集所面对的领域挑战在于,如何在有限的计算资源下从大规模语料中甄选出最具训练价值的数据子集,从而提升模型在推理、代码生成、数学解题及多语言问答等多样化任务上的泛化能力。构建过程中的主要挑战包括:确保不同数据选择算法生成子集的可比性与公平性,维持各子集在领域覆盖和难度分布上的均衡性,以及在大规模数据筛选过程中平衡计算开销与选择质量。此外,如何验证所选子集在跨任务迁移中的有效性,避免因选择偏差导致模型性能下降,亦是亟待解决的关键问题。
常用场景
经典使用场景
在大规模语言模型的数据选择与训练优化领域,该数据集构成了一个系统化的实验基准。其经典使用场景在于,研究者以SmolLM3-3B-Base为基座模型,针对BBH、Codex、GSM8K、MMLU-Pro与TyDiQA五类下游任务,分别采用LESS-DG、LESS-KNN-KDE、LESS-KNN-Uniform、LESS-RR、LESS-UOT、RDS-RR等多条数据选择策略,从训练语料中筛选出各一万条样本,形成可对照的实验组。每条样本以对话消息结构封装,并标注来源数据集与领域标签,便于复现不同选择策略对模型能力的影响,从而在统一框架下开展数据价值评估。
实际应用
在工业级模型研发流程中,该数据集可用于筛选高价值训练样本,帮助团队在算力预算受限时优先保留对推理、代码、数学、多语言问答等能力贡献显著的语料。其实践价值体现在以少量数据达到接近全量训练的效果,从而缩短迭代周期、减少存储与计算开销。同时,多策略配置便于工程人员依据具体业务目标选择匹配的筛选方案,例如面向代码生成或跨语言问答场景时,可分别选取相应配置进行快速验证与部署前的数据准备。
衍生相关工作
围绕该数据集,一系列工作得以展开与延伸。研究者可基于其配置比较不同选择策略的迁移表现,进而发展更稳健的数据估值方法;亦可将其用于蒸馏、课程学习与持续预训练的实验设计,探究数据选择与训练调度之间的交互作用。该数据集还为自动化数据筛选工具的开发提供评测基准,促进数据选择与大模型对齐、能力评估等方向的交叉融合,逐步形成以数据为中心的方法论谱系。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

