ri-conicet
收藏资源简介:
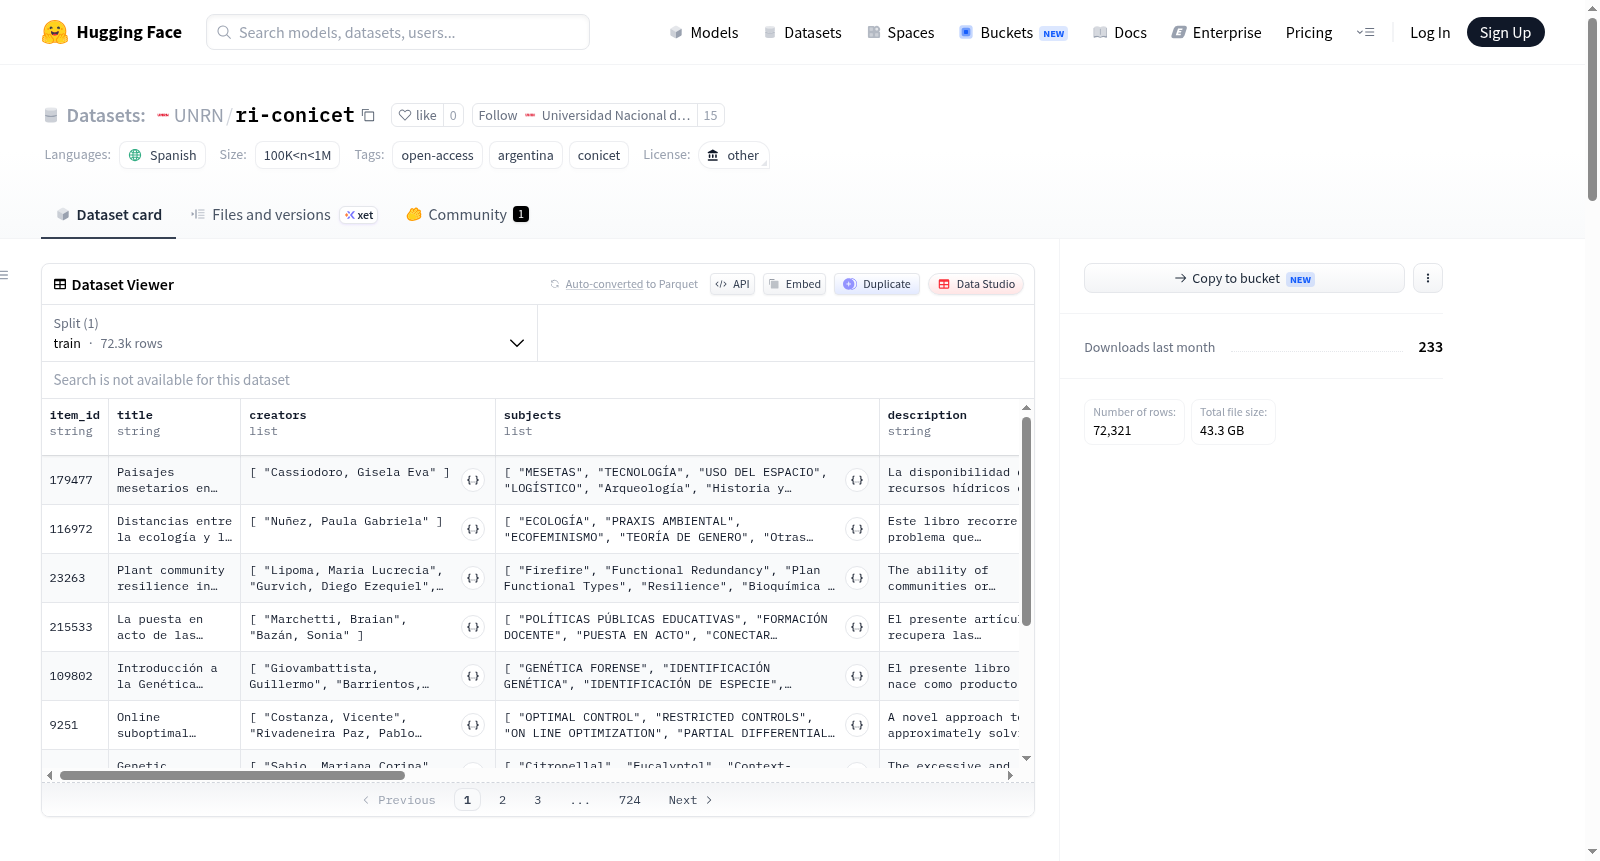
RI CONICET 数据集是阿根廷国家科学技术研究委员会(CONICET)机构知识库 CONICET Digital 的快照。该数据集收录了 CONICET 全部科研产出的元数据,以及开放获取的 PDF 全文。数据来源为 ri.conicet.gov.ar 的 OAI-PMH 2.0 接口,由阿根廷国立里奥内格罗大学(UNRN)的应用科学、工程与技术研究所(CITA)维护,并定期自动更新。数据集包含约 26.6 万条记录,每条记录对应一篇科研产出,其元数据字段包括:item_id(唯一标识符)、title(标题)、creators(作者列表)、subjects(关键词/主题)、description(摘要)、date(出版日期)、type(文献类型)、language(语言代码,多为 spa)、publisher(出版机构)、rights(访问权限,如开放获取、受限等)、formats(比特流格式)、deleted(是否已删除)、fetched_at(采集时间戳)、pdf(PDF 文件路径,仅开放获取且有 PDF 时存在)、embedding(PDF 文本的 1024 维浮点嵌入向量,基于 Jina embeddings v5 omni 模型)。数据以 Parquet 格式存储元数据,PDF 按 shard 组织。该数据集适用于学术研究、文献计量分析、自然语言处理、信息检索等任务。使用时需注意尊重各作品的版权条款,大部分采用 CC BY-NC 许可,受限或 embargo 状态的出版物不包含 PDF。
The RI CONICET dataset is a snapshot of CONICET Digital, the institutional repository of the National Scientific and Technical Research Council (CONICET) of Argentina. It contains metadata for all scientific outputs of CONICET, as well as open-access PDF full texts. The data is sourced from the OAI-PMH 2.0 interface of ri.conicet.gov.ar, maintained by the Institute of Applied Sciences, Engineering and Technology (CITA) of the National University of Río Negro (UNRN), and is regularly updated automatically. The dataset includes approximately 266,000 records, each corresponding to a scientific output, with metadata fields including: item_id (unique identifier), title, creators (list of authors), subjects (keywords/topics), description (abstract), date (publication date), type (document type), language (language code, mostly spa), publisher (publishing institution), rights (access rights, such as open access, restricted, etc.), formats (bitstream formats), deleted (whether deleted), fetched_at (collection timestamp), pdf (PDF file path, only available for open-access items with PDF), and embedding (1024-dimensional floating-point embedding vector of the PDF text, based on the Jina embeddings v5 omni model). Metadata is stored in Parquet format, and PDFs are organized by shard. The dataset is suitable for academic research, bibliometric analysis, natural language processing, information retrieval, and other tasks. Users should respect the copyright terms of each work; most are licensed under CC BY-NC, and restricted or embargoed publications do not include PDFs.
数据集概述
RI CONICET 是一个包含阿根廷国家科学与技术研究委员会(CONICET)机构知识库完整元数据及开放获取PDF文件的快照数据集,数据源自 CONICET Digital 机构知识库(ri.conicet.gov.ar,基于 DSpace 系统),涵盖 266,824 篇科技出版物。该数据集由 CITA - UNRN(国立里奥内格罗大学应用科学、工程与技术研究所)维护,通过 OAI-PMH 2.0 协议从 ri.conicet.gov.ar 自动采集,并持续增量更新。数据集中元数据快照与 PDF 语料库会随时间增长并自动更新。
数据规模与语言
- 数据量:100K 至 1M 条记录之间
- 主要语言:西班牙语(es)
- 许可证:其他(具体作品遵循各自版权条款)
- 出版类型:文献类型使用
info:eu-repo/semantics/...语义词汇标记
数据集结构
| 路径 | 内容 |
|---|---|
data/metadata.parquet |
元数据表,每行对应一篇出版物 |
papers/<shard>/<item_id>.pdf |
开放获取PDF文件,<shard> 为 item_id // 20000 的两位数分片(例如 papers/08/179477.pdf) |
元数据字段说明
| 列名 | 类型 | 描述 |
|---|---|---|
item_id |
str | DSpace 唯一ID(如 179477),由它可推导 handle 和 OAI ID |
title |
str | 出版物标题 |
creators |
list[str] | 作者列表 |
subjects |
list[str] | 关键词或学科分类 |
description |
str | 摘要 |
date |
str | 出版日期(格式为 AAAA 或 AAAA-MM) |
type |
str | 文献类型(info:eu-repo/semantics/...) |
language |
str | ISO 639 语言代码(主要为 spa) |
publisher |
str | 出版机构 |
rights |
str | 访问权限(openAccess、restrictedAccess、embargoedAccess、closedAccess 等) |
formats |
list[str] | 位流格式(如 application/pdf) |
deleted |
bool | 是否已从知识库删除(罕见) |
fetched_at |
datetime | 记录采集时间 |
pdf |
str/None | 若已发布PDF则为 papers/<shard>/<item_id>.pdf,否则为 None |
embedding |
list[float] (1024) / None | PDF文本的float32嵌入向量(模型为 citecca-embeddings,即 Jina embeddings v5 omni,1024维);若无开放PDF、PDF为扫描件无可提取文本或仍在处理中则为 None |
关键说明:
- 开放获取 定义为
rights == "info:eu-repo/semantics/openAccess" pdf为None的两种情况:闭锁/受限出版物(不公开PDF)以及开放出版物但PDF尚未采集(语料库持续增长,列会随快照更新)- 当
pdf非None时,文件一定存在于数据集中 - OAI ID 和 handle 均由
item_id推导,不重复存储
使用方式
Python 加载(使用 Hugging Face datasets 库):
python from datasets import load_dataset
ds = load_dataset("UNRN/ri-conicet", data_files="data/metadata.parquet", split="train") ds[0]["title"]
仅筛选有PDF的开放获取出版物
ds.filter(lambda r: r["pdf"] is not None)
PDF 下载:
bash
下载单个PDF(分片路径:papers/<item_id // 20000>/<id>.pdf)
hf download UNRN/ri-conicet papers/08/179477.pdf
下载完整语料库(体积达数千GB,请谨慎操作)
hf download UNRN/ri-conicet papers
许可证与使用说明
- 每篇出版物的权利归其作者/机构所有,多数采用 CC BY-NC 类许可
- 受限或处于禁运期的出版物 不包含 PDF(需向作者申请访问)
- 建议仅用于研究目的,非商业用途,并遵守各作品的使用条款
引用方式
参考引用格式(BibTeX):
@misc{ri-conicet-hf-2026, title = {RI CONICET: metadatos completos y PDFs de acceso abierto}, author = {CITA - Universidad Nacional de Rio Negro}, month = aug, year = {2026}, publisher = {Hugging Face}, journal = {Hugging Face}, howpublished = {url{https://huggingface.co/datasets/UNRN/ri-conicet}} }
⚠️ 注意:该数据集仍在建设中,数据采集持续进行,元数据快照和PDF语料库会随时间自动更新。如需一次性获取完整知识库,请等待采集完成。