
遇见数据集

open-llm-leaderboard/details_ValiantLabs__ShiningValiant

收藏
Hugging Face2023-12-31 更新2024-03-04 收录
官方服务:

资源简介:

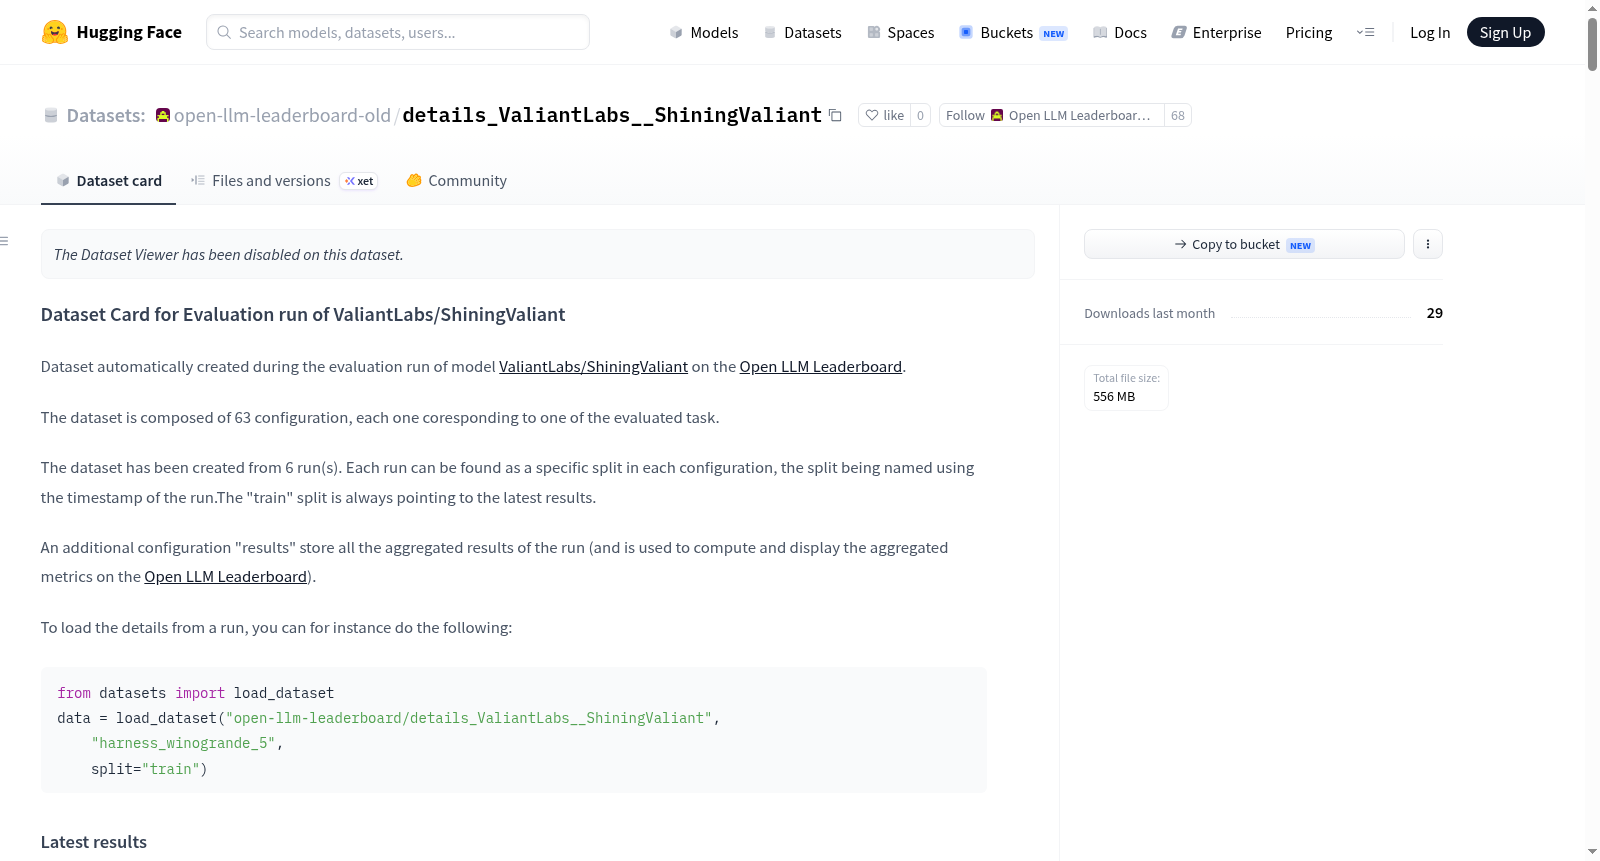
该数据集是在模型ValiantLabs/ShiningValiant在Open LLM Leaderboard上进行评估时自动创建的。数据集由63个配置组成,每个配置对应一个评估任务。数据集由6次运行生成,每次运行的结果作为一个特定的分割存储在配置中,分割名称使用运行的时间戳。train分割始终指向最新的结果。此外,还有一个名为results的配置,存储了所有运行的聚合结果,并用于计算和显示Open LLM Leaderboard上的聚合指标。

This dataset was automatically created when the model ValiantLabs/ShiningValiant was evaluated on the Open LLM Leaderboard. It consists of 63 configurations, each corresponding to one evaluation task. The dataset is generated from 6 runs, with the results of each run stored as a specific split within its corresponding configuration, where the split name uses the timestamp of the run. The 'train' split always points to the most recent results. In addition, there is a configuration named 'results' that stores the aggregated results from all runs and is used to calculate and display the aggregate metrics on the Open LLM Leaderboard.

提供机构:
open-llm-leaderboard
原始信息汇总

数据集概述

数据集组成

  • 该数据集包含63个配置,每个配置对应一个评估任务。
  • 数据集由6次运行结果组成,每次运行的结果可以在每个配置中找到,以运行的时间戳命名的特定分割形式存储。
  • "train"分割始终指向最新的结果。
  • 一个额外的配置"results"存储所有运行的聚合结果,用于计算和显示在Open LLM Leaderboard上的聚合指标。

数据加载示例

python from datasets import load_dataset data = load_dataset("open-llm-leaderboard/details_ValiantLabs__ShiningValiant", "harness_winogrande_5", split="train")

最新结果

  • 最新结果来自2023-12-31T03:38:52.399457运行,包含多个任务的评估指标,如准确率(acc)、标准化准确率(acc_norm)等。

配置详情

  • harness_arc_challenge_25: 包含多个时间戳的分割,如2023-09-02T11:23:20.160582、2023-09-22T22:26:27.274686等。
  • harness_gsm8k_5: 包含2023-12-10T02:25:26.345827和2023-12-31T03:38:52.399457等分割。
  • harness_hellaswag_10: 包含多个时间戳的分割,如2023-09-02T11:23:20.160582、2023-09-22T22:26:27.274686等。
  • harness_hendrycksTest_5: 包含多个时间戳的分割,如2023-09-02T11:23:20.160582等,涉及多个子任务。
搜集汇总
数据集介绍
open-llm-leaderboard/details_ValiantLabs__ShiningValiant 数据集图片
构建方式
在大型语言模型评估的广阔领域中,该数据集专为追踪ValiantLabs/ShiningValiant模型在Open LLM Leaderboard上的表现而构建。其构建过程基于六次独立的评估运行,每次运行均对应一个以时间戳命名的特定数据分割。数据集由63个配置组成,每个配置映射至一个被评估的基准任务,如ARC-Challenge、HellaSwag、GSM8K及涵盖多学科知识的MMLU等。此外,一个名为'results'的独立配置存储了所有运行的聚合结果,用于计算并展示排行榜上的综合指标。训练集分割始终指向最新一次运行的数据,确保用户能获取到最新的评估细节。
特点
该数据集的核心特征在于其时间序列结构与任务细粒度。每个配置下的数据分割以运行时间戳命名,清晰记录了模型在不同时间点的性能演变,为纵向分析提供了宝贵资源。数据集覆盖了从常识推理、数学求解到专业领域知识等63项多样化任务,每一项任务均包含详细的性能指标,如准确率及其标准误差。这种多维度的评估体系不仅反映了模型的综合能力,还揭示了其在特定领域(如天文学、法学)的突出表现或潜在短板,为开发者提供了精细化的优化方向。
使用方法
使用该数据集时,研究人员可通过Hugging Face的datasets库便捷加载。例如,调用load_dataset函数并指定配置名称(如'harness_winogrande_5')及分割(如'train')即可获取最新评估数据。对于历史分析,可依据时间戳分割(如'2023_12_31T03_38_52.399457')加载特定运行细节。加载后的数据以Parquet格式存储,包含各任务的原始输入与模型输出,便于进行自定义的误差分析或性能对比。聚合结果则可通过'results'配置直接访问,为快速生成报告或排行榜展示提供了标准化接口。
背景与挑战
背景概述
随着大规模语言模型在自然语言处理领域取得突破性进展,如何系统性地评估其综合能力成为学术界与工业界共同关注的核心问题。Open LLM Leaderboard由HuggingFace团队于2023年创建,旨在为开源语言模型提供标准化、可复现的性能评测框架。该数据集记录了ValiantLabs/ShiningValiant模型在Leaderboard上的完整评估过程,涵盖63个不同配置的评测任务,包括ARC挑战集、HellaSwag常识推理、MMLU多学科知识、TruthfulQA真实性评估、WinoGrande代词消解以及GSM8K数学推理等基准测试。数据集由六次独立运行结果构成,每次运行的时间戳被用作数据切分的标识,最新结果汇总于2023年12月31日的评估轮次。这一系统性评测体系不仅为模型开发者提供了横向比较的客观依据,更推动了开源大模型社区在透明度和可复现性方面的发展,成为衡量模型进步的重要标尺。
当前挑战
该数据集所解决的领域问题在于构建一个全面、公平且可复现的语言模型评估基准,以克服传统人工评测成本高、主观性强以及不同研究间难以直接比较的困境。在构建过程中面临多重挑战:首先,需要设计涵盖知识推理、常识理解、数学计算、伦理判断等多维度的评测任务集,确保评估结果能够反映模型的真实能力而非单一领域的过拟合;其次,不同评测任务的数据格式、评价指标(如准确率、标准化准确率、MC1/MC2分数)和采样策略(如few-shot示例数量)存在显著差异,需要统一的接口进行标准化处理;再者,模型在多次运行间可能因随机性产生结果波动,如何通过多次运行取最新结果的方式平衡计算成本与统计可靠性成为实践难题;最后,随着新型模型和评测任务的不断涌现,如何动态更新评测集合而不破坏历史可比性,对数据集的架构设计提出了持续性挑战。
常用场景
经典使用场景
在大型语言模型评估领域,该数据集作为Open LLM Leaderboard的标准化评测结果仓库,经典使用场景在于系统性地追踪并比较模型ShiningValiant在63项不同任务上的表现。研究者可通过加载特定配置(如harness_winogrande_5)获取细粒度评测数据,从而深入分析模型在常识推理、科学知识、数学计算等维度的能力边界。这种结构化存储方式使得纵向对比不同时间戳的多次运行结果成为可能,为模型迭代优化提供了量化依据。
实际应用
在实际应用中,该数据集为模型选型与部署提供了关键决策依据。企业可通过解析ShiningValiant在GSM8K数学推理(acc=0.565)与TruthfulQA事实一致性(mc2=0.558)上的表现,评估其在教育辅助或知识问答场景的适用性。同时,winogrande任务中84.1%的指代消解准确率,暗示了该模型在需要深层语义理解的工业级NLP管道中的潜在价值。
衍生相关工作
该数据集衍生了一系列关于评测方法论与模型能力图谱的经典工作。研究者基于其多时间戳快照特性,开发了用于检测模型性能波动的时间序列分析框架。此外,63个任务配置的细粒度结果催生了能力雷达图可视化工具,使得跨模型对比从单一排行榜延伸至多维度能力剖面。这些衍生工作进一步强化了该数据集作为大模型标准化评测基石的学术地位。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

