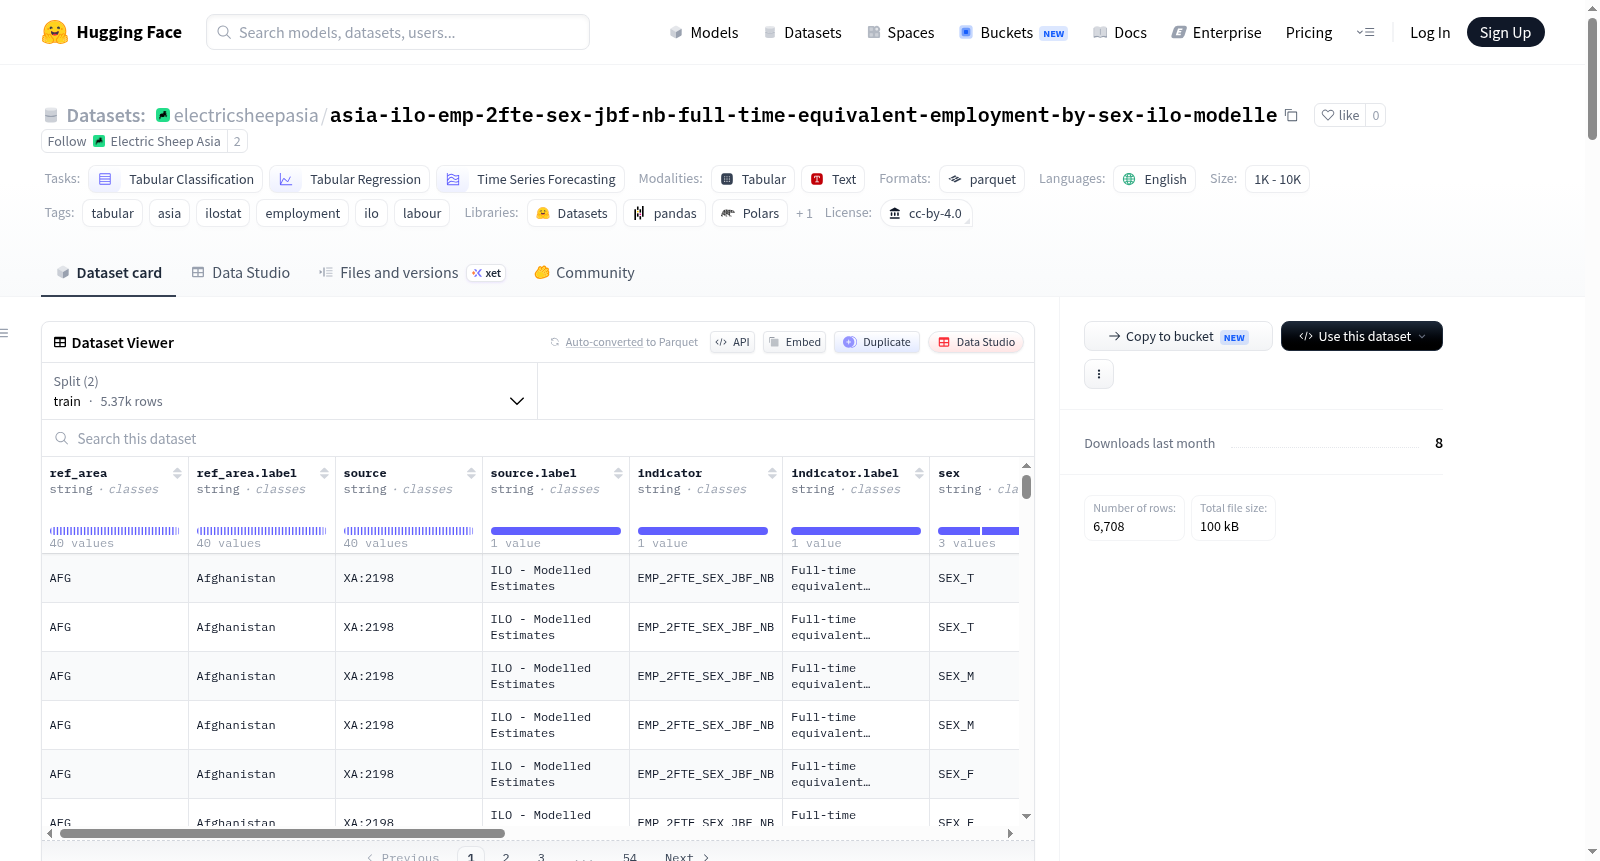
electricsheepasia/asia-ilo-emp-2fte-sex-jbf-nb-full-time-equivalent-employment-by-sex-ilo-modelle
收藏资源简介:
该数据集包含关于亚洲全职等效就业的观测数据,按性别划分,基于国际劳工组织(ILO)的模型估计。数据覆盖49个亚洲国家,时间跨度为2005年至2027年,共有6,708个观测值,涉及一个独特指标(EMP_2FTE_SEX_JBF_NB),用于衡量全职等效就业人数(以千计)。数据来源于ILOSTAT(ILO的中央统计数据库),经过标准化处理,包括国家代码、来源、指标、性别分类、年份和观测值等列,适用于表格分类、回归和时间序列预测任务。数据集由Electric Sheep Asia重新打包,以促进机器学习应用。
--- license: CC BY 4.0 language: - 英语(en) task_categories: - 表格分类 - 表格回归 - 时间序列预测 multilinguality: 单语言 size_categories: - 1000 < 样本数 < 10000 tags: - 表格数据 - 亚洲 - ILOSTAT - 就业 - ILO - 劳动力 pretty_name: "按性别划分的全职当量就业人数——国际劳工组织(International Labour Organization,ILO)2025年11月建模估计值(单位:千)| 亚洲地区(ILOSTAT)" --- # 按性别划分的全职当量就业人数——国际劳工组织(International Labour Organization,ILO)2025年11月建模估计值(单位:千)| 亚洲地区(ILOSTAT) 🌏 **共6708条观测样本** · **覆盖49个亚洲国家** · **时间跨度为2005年至2027年** · *由[Electric Sheep Asia](https://huggingface.co/electricsheepasia)重新整理发布*      ## 快速概览(TL;DR) 本数据集包含**6708条就业相关观测样本**,覆盖**49个亚洲国家**,时间跨度为**2005年至2027年**,仅包含**1项独立指标**。 ## 数据来源 **ILOSTAT**是国际劳工组织(International Labour Organization,ILO)的核心统计数据库,是全球领先的劳动力统计权威数据源。其收录的指标涵盖就业、失业、薪资、工作时长、童工、非正规经济、社会保障、职业伤害以及可持续发展目标(Sustainable Development Goals,SDG)的体面工作目标等领域,数据来源于全国劳动力调查、家庭收入调查、机构调查以及行政记录。该数据库覆盖全球200余个经济体,由国际劳工组织统计司负责数据的标准化处理。 - **数据源**:[ILOSTAT](https://www.ilo.org/shinyapps/bulkexplorer/?id=EMP_2FTE_SEX_JBF_NB) - **发布方**:国际劳工组织(International Labour Organization,ILO) - **许可协议**:[CC BY 4.0](https://creativecommons.org/licenses/by/4.0/) - **主题**:就业 ## 数据处理方法 本数据集直接从ILOSTAT的REST API接口`https://rplumber.ilo.org/data/indicator?id=EMP_2FTE_SEX_JBF_NB`拉取原始数据,并筛选出亚洲地区的ISO 3166-1 alpha-3国家代码对应的样本。ILOSTAT采用国际劳工统计会议(International Conference of Labour Statisticians,ICLS)制定的定义对原始调查微观数据进行标准化处理;数据来源信息将在`source.label`字段中标记,以确保可追溯性。 ## 地理覆盖范围 共覆盖49个亚洲国家,以下按数据行数排序展示部分国家示例: | 国家代码 | 数据行数 | 起始年份 | 终止年份 | |---------|-----:|-----------:|----------:| | `AFG` | 138 | 2005 | 2027 | | `ARE` | 138 | 2005 | 2027 | | `ARM` | 138 | 2005 | 2027 | | `AZE` | 138 | 2005 | 2027 | | `BGD` | 138 | 2005 | 2027 | | `BHR` | 138 | 2005 | 2027 | | `BRN` | 138 | 2005 | 2027 | | `BTN` | 138 | 2005 | 2027 | | `CHN` | 138 | 2005 | 2027 | | `CYP` | 138 | 2005 | 2027 | | `GEO` | 138 | 2005 | 2027 | | `IDN` | 138 | 2005 | 2027 | | `IND` | 138 | 2005 | 2027 | | `IRN` | 138 | 2005 | 2027 | | `IRQ` | 138 | 2005 | 2027 | | ... | 另有34个国家 | | | ## 指标示例 - `EMP_2FTE_SEX_JBF_NB` — 按性别划分的全职当量就业人数——国际劳工组织(ILO)2025年11月建模估计值(单位:千) ## 数据结构 | 字段名 | 数据类型 | 字段说明 | 示例值 | |--------|------|-------------|---------| | `ref_area` | `string` | ISO 3166-1 alpha-3 国家代码 | `AFG` | | `ref_area.label` | `string` | 英文国家名称 | `阿富汗` | | `source` | `string` | ILOSTAT 来源代码(如劳动力调查) | `XA:2198` | | `source.label` | `string` | 英文来源名称 | `ILO - 建模估计值` | | `indicator` | `string` | ILOSTAT 指标代码 | `EMP_2FTE_SEX_JBF_NB` | | `indicator.label` | `string` | 英文指标名称 | `按性别划分的全职当量就业人数……` | | `sex` | `string` | 性别细分维度(SEX_T=总计,SEX_M=男性,SEX_F=女性) | `SEX_T` | | `sex.label` | `string` | — | `总计` | | `classif1` | `string` | 第一分类变量(年龄、教育程度、就业状态等) | `JBF_FTE_FTE40` | | `classif1.label` | `string` | — | `全职当量:基于40小时工时……` | | `time` | `int64` | 观测年份 | `2027` | | `obs_value` | `float64` | 观测指标值(单位详见指标定义) | `7752.571` | | `obs_status` | `string` | 观测状态标记(如临时、不可靠) | `A` | | `obs_status.label` | `string` | — | `已调整` | ## 数据细分维度 以下字段提供数据细分维度: - **`sex`**(共3个唯一值):`SEX_T`、`SEX_M`、`SEX_F` ## 数据质量与注意事项 - 数据为年度频率。部分指标同时发布月度或季度序列,本数据集未包含此类数据。 - 当同一国家×年份的同一指标存在多个数据源时,将采用国际劳工组织选定的“最优数据源”。 - 细分维度字段(`sex`、`classif1`、`classif2`)仅在指标支持对应细分时才会包含非空值。 ## 使用方法 以下是使用示例代码: python from datasets import load_dataset ds = load_dataset("electricsheepasia/asia-ilo-emp-2fte-sex-jbf-nb-full-time-equivalent-employment-by-sex-ilo-modelle") df = ds["train"].to_pandas() print(df.head()) ### 按国家筛选 python indonesia = df[df["ref_area"] == "IDN"] ### 生成单个指标的时间序列图表 python sample = (df[df["indicator"] == "EMP_2FTE_SEX_JBF_NB"] .sort_values("time")) sample.plot(x="time", y="obs_value", title="EMP_2FTE_SEX_JBF_NB") ### 转换为国家-年份交叉矩阵 python matrix = (df[df["indicator"] == "EMP_2FTE_SEX_JBF_NB"] .pivot_table(index="time", columns="ref_area", values="obs_value")) print(matrix.tail()) ## 引用格式 请使用以下BibTeX格式引用本数据集: bibtex @misc{asia_ilo_emp_2fte_sex_jbf_nb_full_time_equivalent_employment_by_sex_ilo_modelle_2027, title = {Full-time equivalent employment by sex -- ILO modelled estimates, Nov. 2025 (thousands) | Asia (ILOSTAT)}, author = {International Labour Organization (ILO)}, year = {2027}, url = {https://www.ilo.org/shinyapps/bulkexplorer/?id=EMP_2FTE_SEX_JBF_NB}, publisher = {HuggingFace Datasets, repackaged by Electric Sheep Asia}, howpublished = {url{https://huggingface.co/datasets/electricsheepasia/asia-ilo-emp-2fte-sex-jbf-nb-full-time-equivalent-employment-by-sex-ilo-modelle}} } ## 许可协议 本数据集采用[CC BY 4.0](https://creativecommons.org/licenses/by/4.0/)许可协议发布。 原始数据版权归国际劳工组织(ILO)所有。使用本数据集时,请同时引用上述原始数据源及Electric Sheep Asia的重新整理版本。 ## 关于Electric Sheep Electric Sheep是Electric Sheep使命的一部分:旨在构建一个统一的、可直接用于机器学习的亚洲地区数据层,托管于HuggingFace平台。我们从权威开源数据源获取数据,对数据模式进行标准化处理,打包为Parquet格式,并发布格式统一的数据集卡片,以便研究人员和开发者仅需使用`load_dataset()`即可在数秒内开始工作。 浏览完整数据集集合:[huggingface.co/electricsheepasia](https://huggingface.co/electricsheepasia) --- _数据溯源:2026年5月28日通过Electric Sheep管道获取。源URL:https://www.ilo.org/shinyapps/bulkexplorer/?id=EMP_2FTE_SEX_JBF_NB_