
Donnees_internes_doctrine_45
收藏官方服务:
资源简介:
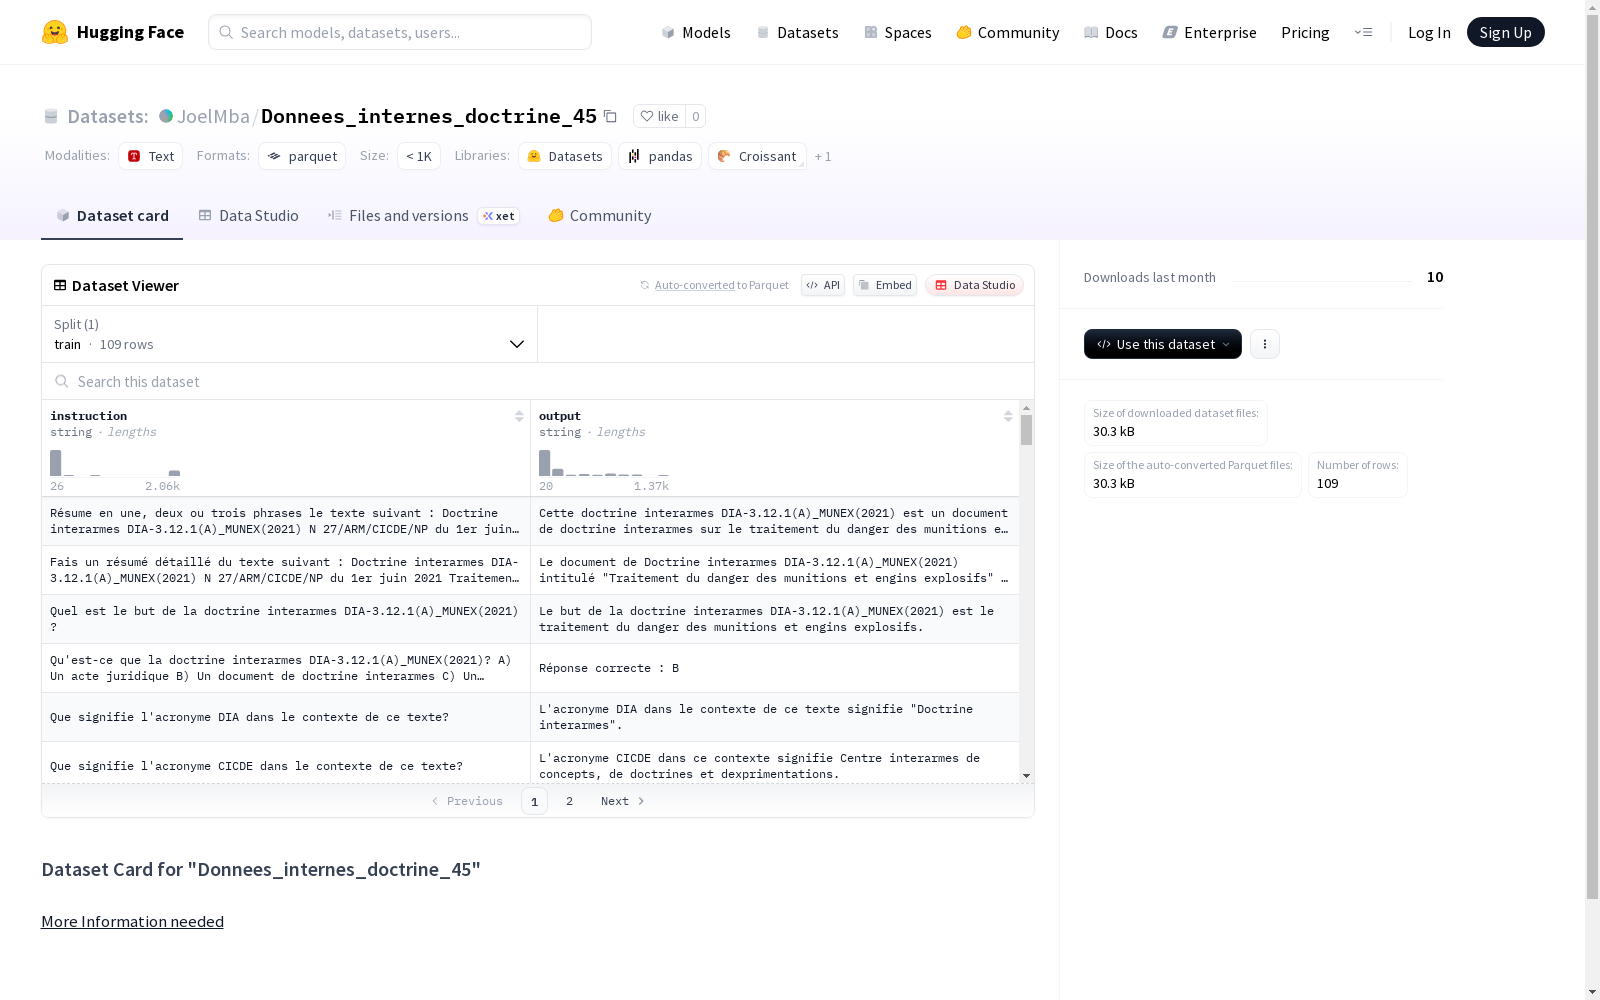
该数据集包含指令(instruction)和输出(output)两个字段,均为文本类型。数据集仅包含训练集划分,共有109个样本,数据集大小为74135字节,下载大小为30290字节。数据集的详细描述信息未在README中提供。
This dataset includes two fields: `instruction` and `output`, both of which are text-type data. The dataset only consists of a training split, with a total of 109 samples. The size of the dataset is 74135 bytes, and its download size is 30290 bytes. No detailed description information for this dataset is provided in the README.
创建时间:
2025-05-27
原始信息汇总
数据集概述
基本信息
- 数据集名称: Donnees_internes_doctrine_45
- 存储位置: Hugging Face数据集库
数据集结构
- 特征:
instruction: 字符串类型output: 字符串类型
- 数据划分:
train:- 字节数: 74135
- 样本数: 109
数据规模
- 下载大小: 30290字节
- 数据集大小: 74135字节
配置信息
- 默认配置:
- 数据文件路径:
data/train-*
- 数据文件路径:
搜集汇总
数据集介绍
构建方式
在法学文献数字化处理的背景下,Donnees_internes_doctrine_45数据集通过系统收集和整理内部法律教义数据构建而成。该过程涉及从可靠来源提取结构化文本,确保每条记录包含清晰的指令和对应输出,以109个训练样本的形式呈现,总数据量约为74KB,体现了对法律领域知识的高效组织。
使用方法
用户可通过加载默认配置直接访问训练分割,数据文件以标准格式存储于指定路径。该数据集适用于微调语言模型以处理法律指令遵循任务,使用时需依据特征结构解析instruction和output字段,结合具体场景进行预处理,从而提升模型在法律领域的推理能力。
背景与挑战
背景概述
在法学信息化浪潮的推动下,Donnees_internes_doctrine_45数据集应运而生,旨在系统整理法律条文与司法实践之间的内在关联。该数据集由专业法律研究机构于近期构建,聚焦于法律指令与对应裁决结果的映射关系,为法律智能分析提供结构化数据支撑。其核心价值在于将抽象的法律条文转化为可计算的知识单元,促进了法律文本挖掘、判决预测等领域的实证研究发展。
当前挑战
法律文本固有的专业性与多义性构成首要挑战,如何精准捕捉条文中的隐含逻辑需要深层的领域知识。数据构建过程中面临标注一致性难题,不同法律专家对相同条款可能存在差异化解读。此外,法语法律术语的精确转换要求语言模型具备跨领域的语义理解能力,而小规模样本(109条数据)对模型泛化性能形成显著制约。
常用场景
经典使用场景
在法律信息处理领域,Donnees_internes_doctrine_45数据集以其结构化指令-输出对形式,为法律文本生成任务提供了典型应用场景。该数据集常用于训练模型理解法律指令并生成相应法律文档或分析结果,例如基于特定法律条文自动生成案例摘要或合规建议,有效支持法律智能系统的开发与优化。
解决学术问题
该数据集主要针对法律自然语言处理中的指令遵循与内容生成难题,为研究法律文本的语义解析和逻辑推理提供了基准资源。通过提供高质量的法律指令-输出样本,它助力解决法律领域低资源环境下模型泛化能力不足的问题,推动了法律人工智能的可解释性与专业化发展。
实际应用
在实际应用中,该数据集可作为法律科技工具的核心训练数据,用于构建智能法律咨询系统或文档自动化平台。例如,律师事务所可利用其训练模型快速生成初步法律意见书,或辅助法官进行案例条款的关联分析,显著提升法律工作效率并降低人工成本。
数据集最近研究
最新研究方向
在法律文本分析领域,Donnees_internes_doctrine_45数据集作为法语法律教义数据的代表,正推动自然语言处理技术在司法智能化的前沿探索。当前研究聚焦于利用该数据集训练法律问答模型,以提升对复杂法律概念的理解和生成能力,这直接关联到欧洲人工智能法规的热点议题,如算法透明性和责任分配。其影响在于为跨语言法律AI系统提供了关键资源,促进了司法决策自动化的伦理框架构建,具有推动法律科技创新的深远意义。
以上内容由遇见数据集搜集并总结生成


