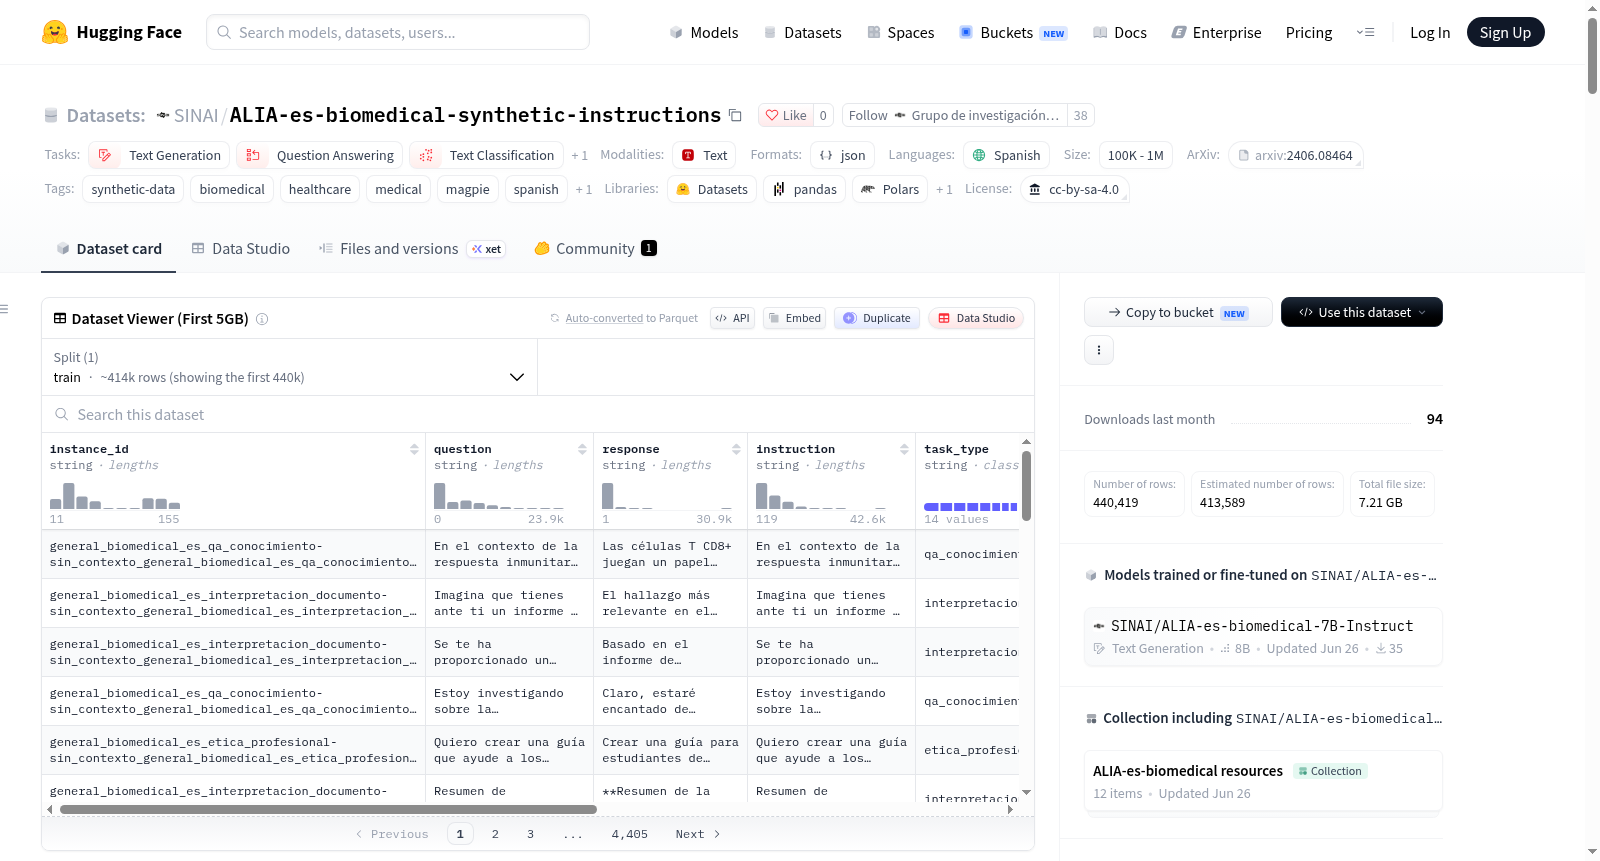
SINAI/ALIA-es-biomedical-synthetic-instructions
收藏资源简介:
该数据集包含使用指令模型生成并经过多步骤质量管道筛选的合成生物医学和医疗保健指令-响应对。生成过程遵循Magpie方法,模型首先生成用户端查询(临床问题、医疗指令或诊断任务),然后生成相应的答案。语料库包括一般提示和基于西班牙语生物医学文档(临床指南、药理学数据、医学文献和官方健康文档)构建的上下文条件提示。它涵盖多种任务类型,如临床诊断、药物信息、药物相互作用、患者教育、文档解释、命名实体识别、摘要以及医疗保健背景下的伦理推理。
--- 许可证:cc-by-sa-4.0 任务类别: - 文本生成 - 问答 - 文本分类 - 填空掩码 语言: - 西班牙语 标签: - 合成数据 - 生物医学 - 医疗保健 - 医学 - Magpie - 西班牙语 - 大语言模型训练 规模类别: - 10万<样本数<100万 配置: - 配置名称:default 数据文件: - 拆分:train 路径:"ALIA-es-biomedical-synthetic-instructions.jsonl" --- # 数据集介绍 **ALIA西班牙语生物医学合成指令语料库**是ALIA项目下基于**Magpie**方法创建的西班牙语合成指令微调资源。该语料库旨在训练与评估面向生物医学及医疗保健任务的语言模型,具备可控格式与大规模监督数据。 本语料库包含: - **639,456 条样本** - **961,073,205 个Token** - **14 种任务模态**:临床诊断、患者教育、伦理推理、文档解读、多知识层级问答、命名实体识别(NER)、摘要生成、简化任务、正误判断等。 ## 数据集细节 ### 数据集描述 本数据集包含通过指令模型生成并经过多阶段质量流程筛选的合成生物医学与医疗保健指令-回复对。生成流程遵循Magpie方法:模型首先生成用户侧查询(临床问题、医疗指令或诊断任务),随后生成对应的回复。 本语料库包含通用提示词与基于西班牙语生物医学文档(临床指南、药理学数据、医学文献、官方医疗文档)构建的带上下文提示词。涵盖多样化任务类型,如临床诊断、用药信息、药物相互作用、患者教育、文档解读、命名实体识别、摘要生成、医疗场景下的伦理推理等。 ### 数据集用途 本数据集适用于: - 西班牙语生物医学大语言模型的指令微调 - 临床与医疗问答 - 命名实体识别与医学术语抽取 - 医疗摘要生成与信息检索 - 医疗专业人员培训与患者教育应用 - 面向领域自适应与检索增强生成的生物医学系统的合成监督数据 ## 数据集结构 ### 数据实例 每条样本遵循以下结构: json { "instance_id": "CIMA_AEMPS-efectos_medicamento1", "question": "Dado el siguiente contexto: FICHA TÉCNICA - 1. NOMBRE DEL MEDICAMENTO Fisiológico B.Braun 0,9% solución para perfusión... Pregunta: ¿Cuáles son los principales efectos adversos asociados a la administración de solución fisiológica?", "response": "Los efectos adversos de la solución fisiológica al 0,9% son generalmente infrecuentes. Los más comunes incluyen: irritación local en el sitio de infusión, reacciones de hipersensibilidad, sobrecarga de volumen en pacientes con insuficiencia cardíaca o renal, e hipernatremia con uso prolongado.", "instruction": "Dado el siguiente contexto: FICHA TÉCNICA... analiza los efectos adversos potenciales.", "task_type": "efectos_medicamento", "question_variation_style": "original", "question_model": "phi-4", "response_model": "phi-4", "tokens": 542 } ### 数据字段 - **instance_id** (string): 样本的唯一标识符。 - **question** (string): 提交给模型的生成式问题或指令提示词。 - **response** (string): 生成的回复内容。 - **instruction** (string): 用于训练的完整指令文本。 - **task_type** (string): 生成模态(问题/指令/测试格式与上下文设置)。 - **question_variation_style** (string): 提示词变体策略的元数据。 - **question_model** (string): 用于生成问题/指令的模型。 - **response_model** (string): 用于生成回复的模型。 - **tokens** (int): 该样本的Token数量。 ### 数据拆分 按`task_type`的分布: | 任务类型 | 样本数量 | 占比 | | :--- | ---: | ---: | | 文档解读 | 65,832 | 10.30% | | 事实型问答 | 65,087 | 10.18% | | 专业伦理推理 | 57,712 | 9.03% | | 临床诊断 | 55,828 | 8.73% | | 知识型问答 | 55,150 | 8.62% | | 命名实体识别 | 53,617 | 8.38% | | 患者教育 | 53,441 | 8.36% | | 多回复任务 | 50,628 | 7.92% | | 正误判断 | 50,455 | 7.89% | | 简化任务 | 47,775 | 7.47% | | 正误判断 | 31,893 | 4.99% | | 定义型问答 | 29,154 | 4.56% | | 摘要生成 | 22,771 | 3.56% | | 流程型问答 | 113 | 0.02% | | **总计** | **639,456** | **100.00%** | 按`question_variation_style`的分布: | 变体样式 | 样本数量 | 占比 | | :--- | ---: | ---: | | 原始样式 | 489,612 | 76.57% | | 口语化质疑式 | 12,196 | 1.91% | | 感叹式对话 | 12,161 | 1.90% | | 带拼写错误的质疑式 | 12,127 | 1.90% | | 非正式对话 | 12,024 | 1.88% | | 质疑式 | 11,980 | 1.87% | | 带拼写错误的感叹式 | 11,861 | 1.85% | | 电报式感叹式 | 11,838 | 1.85% | | 口语化感叹式 | 11,703 | 1.83% | | 电报式 | 11,695 | 1.83% | | 带拼写错误的口语化 | 11,230 | 1.76% | | 口语化 | 10,707 | 1.67% | | 拼写错误式 | 10,377 | 1.62% | | 感叹式 | 9,945 | 1.56% | 按`question_model`的分布: | 模型 | 样本数量 | 占比 | | :--- | ---: | ---: | | phi-4 | 489,612 | 76.57% | | Qwen3.5-35B-A3B | 149,844 | 23.43% | 按`response_model`的分布: | 模型 | 样本数量 | 占比 | | :--- | ---: | ---: | | phi-4 | 313,048 | 48.96% | | qwen3.5 | 109,000 | 17.05% | | kimi-k2.5 | 72,400 | 11.32% | | gemma4 | 62,900 | 9.84% | | qwen3 | 57,404 | 8.98% | | llama-3.3 | 24,704 | 3.86% | ### 示例用法 python from datasets import load_dataset # 加载完整训练拆分数据集 data = load_dataset( "SINAI/ALIA-es-biomedical-synthetic-instructions", split="train", ) # 访问单条样本 example = data[0] print(example["instance_id"]) print(example["task_type"]) print(example["question"][:300]) print(example["response"]) 流式加载(推荐用于大文件): python from datasets import load_dataset stream_data = load_dataset( "SINAI/ALIA-es-biomedical-synthetic-instructions", split="train", streaming=True, ) for i, example in enumerate(stream_data): print(f"[{i}] {example['task_type']}") print(f"Q: {example['question'][:180]}...") print(f"A: {example['response'][:180]}... ") if i >= 2: break ## 数据集创建 ### 筛选依据 本语料库旨在为ALIA项目内的西班牙语生物医学与医疗保健语言任务提供大规模、领域专属的合成监督数据,目标是提升模型在临床问答、诊断推理、用药信息检索、患者教育与医疗文本分析中的表现。 ### 源数据 基于上下文的生成内容依托公开西班牙语生物医学与医疗保健文档(临床指南、药理学数据表、医学文献、医疗协议、官方医疗机构出版物),这些数据源自**ALIA-es-biomedical**语料库。通用生成内容则受限于基于医学知识与临床最佳实践训练的生物医学领域系统提示词。 ### 数据收集与处理 #### Magpie生成流程 生成流程遵循适配生物医学领域的Magpie方法: 1. 提供生物医学**系统提示词**(基于临床知识、医疗指南与药理学专业知识训练)。 2. 多生成模型(Phi-4、Qwen 3.5等)生成用户侧提示词,即生物医学问题/指令(临床诊断、用药效果、药物相互作用、患者教育等)。 3. 多回复模型(Phi-4、Llama-3.3、Qwen、Kimi-K2.5、Gemma4)从各自的专业视角生成对应查询的回复。 4. 对于带上下文的生成模式,会在生成前注入生物医学文档上下文。 5. 任务类型涵盖临床场景、命名实体识别、摘要生成、简化任务、伦理推理与多知识层级问答。 本实现的文档可在GitHub的[sinai-uja/ALIA-UJA/documentation/data/llms/instructions](https://github.com/sinai-uja/ALIA-UJA/tree/dev/documentation/data/llms/instructions)中查看。 #### 质量筛选与重构步骤 最终语料库遵循以下筛选策略: 1. 初始合成生成与诊断审查。 2. 使用**Galtea**基于大语言模型的质量策略,对Magpie生成的原始指令-回复输出进行过滤。 最终的训练文件即为用于下游指令微调的整合产物。 ### 标注信息 本数据集无人工标注,元数据字段均在生成与整合过程中自动生成。 ### 个人与敏感信息 本数据集源自公开生物医学与医疗资源及合成变换,已应用标准筛选流程以减少敏感或个人可识别内容。 ## 数据使用注意事项 ### 数据集的社会影响 本数据集可助力西班牙语生物医学AI系统的开发,提升医疗知识获取、临床决策支持、患者教育与医疗专业人员培训的可及性。但需负责任地使用,绝不可替代专业医疗建议。 ### 偏差讨论 潜在偏差包括: - 源自源生物医学与医疗话语的偏差,可能反映机构视角与既有实践 - 由所用多生成模型引入的偏差 - 合成语料库典型的风格同质化问题 - 源文档中某些医疗状况或治疗方案的潜在过度代表 - 西班牙语医疗术语与医疗体系固有的语言与文化偏差 - 罕见病或新兴医学知识的潜在代表性不足 ### 已知局限性 - 合成医疗回复不可作为临床建议使用,其缺乏医疗专业人员的语境与专业判断 - 部分上下文片段可能包含源自源制药或医疗文档的OCR或格式伪影 - 语料库反映西班牙语医疗术语体系,可能与其他西班牙语地区存在差异 - 任务分布虽较为均衡但并非完全统一 - 生成文本可能无法捕捉真实临床文档的细微差别 - 不同源数据的时间覆盖范围各异,部分医疗信息可能已过时 ### 引用 bibtex @misc{ALIA-es-biomedical-synthetic-instructions, title={ALIA西班牙语生物医学合成指令语料库}, author={SINAI研究组}, year={2026}, publisher={HuggingFace}, howpublished={url{https://huggingface.co/datasets/SINAI/ALIA-es-biomedical-synthetic-instructions}} } --- ## 资助信息 本工作由西班牙数字化与公共职能部资助,依托欧盟下一代欧盟计划,在ALIA项目框架内完成。 ## 致谢 本数据集的生成感谢[SCAYLE](https://www.scayle.es/)(卡斯蒂利亚-莱昂超级计算中心),其通过CALENDULA超级计算集群提供了所需的计算资源。 --- **联系方式:** [ALIA项目](https://www.alia.gob.es/) - [SINAI研究组](https://sinai.ujaen.es) - [哈恩大学](https://www.ujaen.es/) **更多信息:** [SINAI研究组](https://sinai.ujaen.es) | [ALIA-UJA项目](https://github.com/sinai-uja/ALIA-UJA)