
遇见数据集

MathArena/brokenarxiv-0426

收藏
Hugging Face2026-06-09 更新2026-06-14 收录
官方服务:

资源简介:

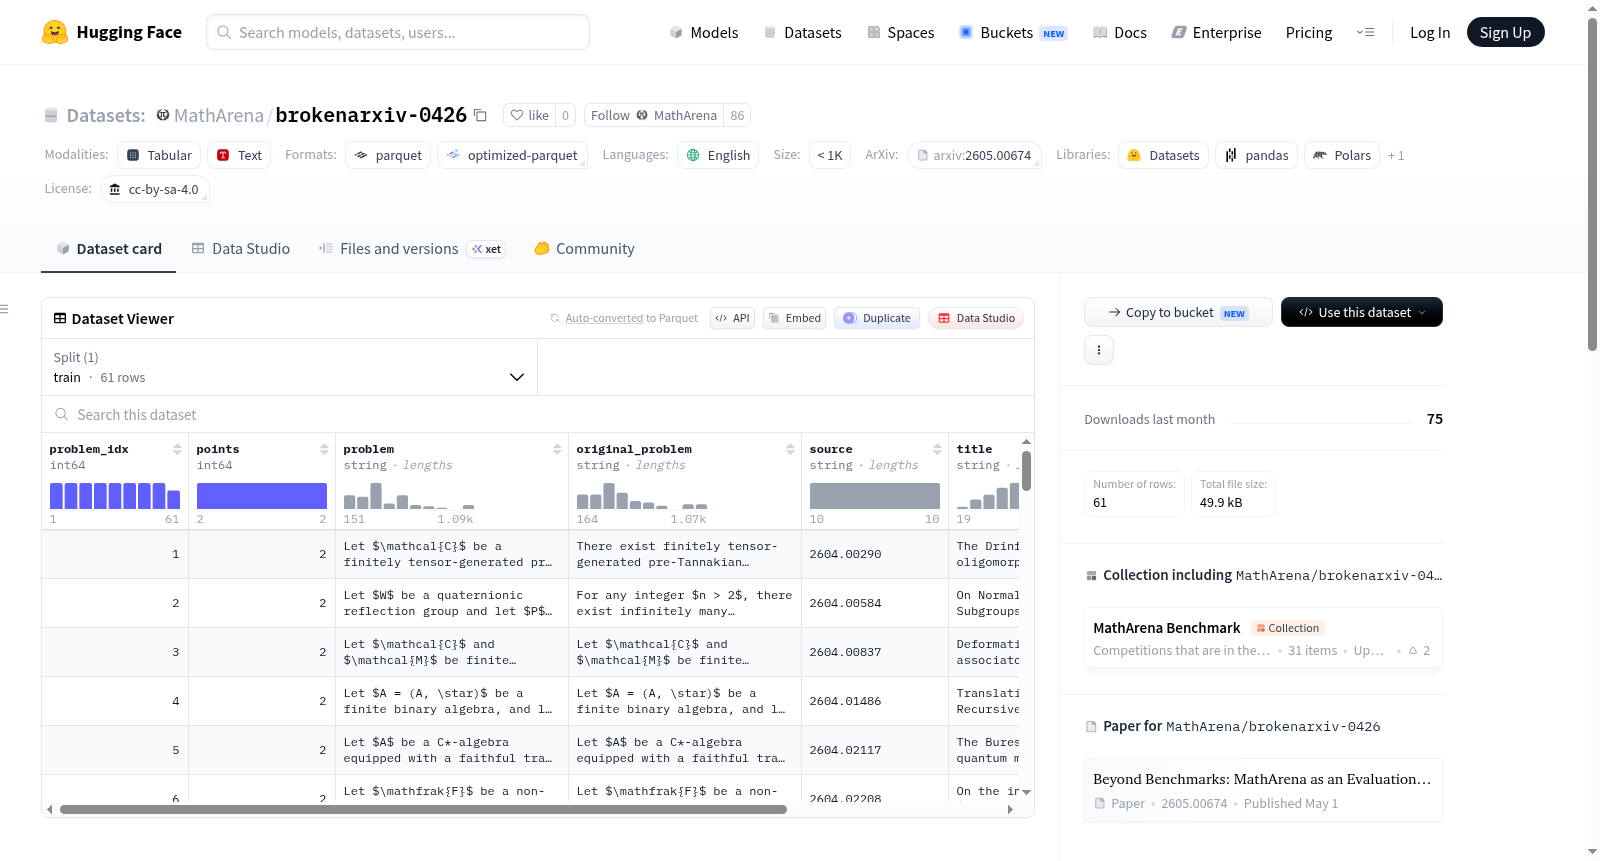
该数据集包含来自BrokenArXiv April 2026的问题,用于MathArena排行榜。数据集包括多个字段:problem_idx(问题在对应MathArena基准中的索引)、points(非最终答案或证明式问题的最大分数)、grading_scheme(用于证明式评判的评分标准或方案)、problem(要求模型证明的错误数学陈述)、source(源论文的arXiv标识符)、title(源arXiv论文的标题)和authors(源arXiv论文的作者)。数据集基于CC BY-SA 4.0许可证发布,语言为英语,规模较小(少于1000个示例),主要用于评估大型语言模型在数学领域的性能。

This dataset contains questions sourced from BrokenArXiv April 2026, intended for the MathArena leaderboard. It includes multiple fields: problem_idx (the index of the question within the corresponding MathArena benchmark), points (the maximum score for non-final answer or proof-based questions), grading_scheme (the scoring criteria or scheme for proof-based evaluation), problem (an incorrect mathematical statement that requires the model to generate a proof), source (the arXiv identifier of the source paper), title (the title of the source arXiv paper), and authors (the authors of the source arXiv paper). This dataset is released under the CC BY-SA 4.0 license, is in English, has a small scale with fewer than 1000 examples, and is primarily utilized to evaluate the performance of large language models in the mathematical domain.
提供机构:
MathArena
搜集汇总
数据集介绍
MathArena/brokenarxiv-0426 数据集图片
构建方式
BrokenArXiv April 2026 数据集源自于对 arXiv 预印本中数学论文的系统性挖掘与重构。其构建过程始于从海量数学论文中提取具有明确答案的数学问题,进而通过精心的改写与扰动,将原始的正确命题转化为具有误导性的数学谬误陈述(即“broken”问题)。每个样本均保留了原始论文的元数据,包括标题、作者及 arXiv 标识符,并赋予唯一的问题索引与评分标准。最终,经过筛选与去重,形成了由 61 条高质量训练样本构成的小型基准集合,旨在评估语言模型在数学推理与谬误检测方面的能力。
使用方法
该数据集主要用于 MathArena 排行榜的数学推理评估,使用者可将其作为标准测试集直接加载。通过 HuggingFace Datasets 库,只需指定配置名 'default' 与拆分 'train' 即可获取全部样本。每个样本的 'problem' 字段包含待证明的谬误陈述,模型需输出严谨的数学推导以揭示其错误。评分方案 'grading_scheme' 字段提供了人工判分标准,便于自动化评测或人工核实。推荐在零样本或少样本设置下运行,以考察模型的泛化与抗误导能力。数据集遵循 CC BY-SA 4.0 协议,引用时请注明 MathArena 相关论文。
背景与挑战
背景概述
数学推理能力的评估一直是自然语言处理领域的核心挑战之一,尤其是对于大型语言模型(LLMs)而言。现有基准测试常因数据污染或问题形式单一而难以真实反映模型能力。在此背景下,由苏黎世联邦理工学院(ETH Zurich)的研究团队于2026年发布的BrokenArXiv April 2026数据集应运而生,它隶属于MathArena评测平台,旨在通过引入经过精心设计的错误数学命题,来评估LLMs在发现并修正谬误方面的能力。该数据集包含61条来自arXiv论文的假命题,覆盖多种数学分支,其独特的问题设计——要求模型证明一个错误陈述——为数学推理评测开辟了新维度。作为MathArena的重要组成部分,该数据集对推动LLMs在严谨数学推理和错误检测领域的评估方法具有重要影响,也为后续更复杂、更鲁棒的数学基准研究奠定了基础。
当前挑战
BrokenArXiv April 2026数据集面临的主要领域挑战在于:传统的数学基准测试通常侧重于正确命题的解答或证明,而缺乏对模型识别并证伪错误数学陈述能力的考察,这导致LLMs在实际应用中可能因无法察觉隐含错误而输出误导性结论。构建过程中,研究团队需从海量arXiv论文中筛选出有误导性但非显然错误的假命题,这要求对原文进行深层理解与重构,以保证问题难度适中且不依赖外部知识。同时,为确保评测的公平性和可重复性,还需设计清晰且带分值的评分方案(grading scheme),以应对非最终答案型或证明型问题的开放解答。此外,由于数据量较小(仅61例),如何避免过拟合和确保统计显著性也是构建时的一大挑战。
常用场景
经典使用场景
在数学推理与人工智能的交叉研究中,BrokenArXiv April 2026数据集扮演着独特的角色。作为MathArena评测平台的核心组件,它专为评估大型语言模型(LLM)在数学证明与错误检测方面的能力而设计。该数据集收录了61道源自arXiv论文的伪数学命题,要求模型不仅识别其虚假性,还需给出严谨的反驳或证明。这一设定超越了传统选择题或计算题的局限,迫使模型深入理解数学逻辑结构,从而成为检验LLM形式化推理与批判性思维能力的经典基准。
解决学术问题
该数据集直指当前LLM评估中一个被忽视的维度——对抗性数学推理能力。传统基准多聚焦于正确命题的求解,而BrokenArXiv首次系统性地要求模型处理故意虚构的数学断言。这一设计揭示了模型在逻辑错误识别、公理依赖分析以及反例构造方面的潜在缺陷。通过量化模型对错误命题的敏感性,该数据集为研究数学常识与逻辑鲁棒性提供了新的实验范式,推动学界重新思考模型是否真正理解数学规则,抑或仅依赖于统计模式。
实际应用
在实际应用中,BrokenArXiv April 2026的评测能力直接服务于数学辅助工具与教育系统的质量控制。例如,在自动数学辅导平台中,该数据集可用于检验AI助教能否准确指出学生推导中的逻辑漏洞,而非仅给出答案。此外,在学术出版领域,它可帮助自动化审稿系统检测稿件中隐含的伪命题或错误定理。通过模拟人类评审中的质疑与纠错过程,该数据集增强了AI在数学验证场景下的实用性与可信度。
数据集最近研究
最新研究方向
该数据集聚焦于评估大语言模型在数学推理领域的前沿表现,尤其是针对模型在发现并反驳错误数学命题方面的能力。随着MathArena等新型评估平台的兴起,传统基准测试已无法满足对模型深层逻辑理解与批判性思维的检验需求。brokenarxiv-0426通过收录来自arXiv论文的伪命题,促使研究者关注模型在复杂、反直觉陈述下的推理鲁棒性,这直接呼应了当前AI数学领域对可解释性与严谨性的追求。其评分机制强调过程而非结果,推动了大模型从简单答案匹配向形式化证明的方向演进,对构建更可靠的数学辅助系统具有里程碑式的意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

