tax_court_opinions
收藏资源简介:
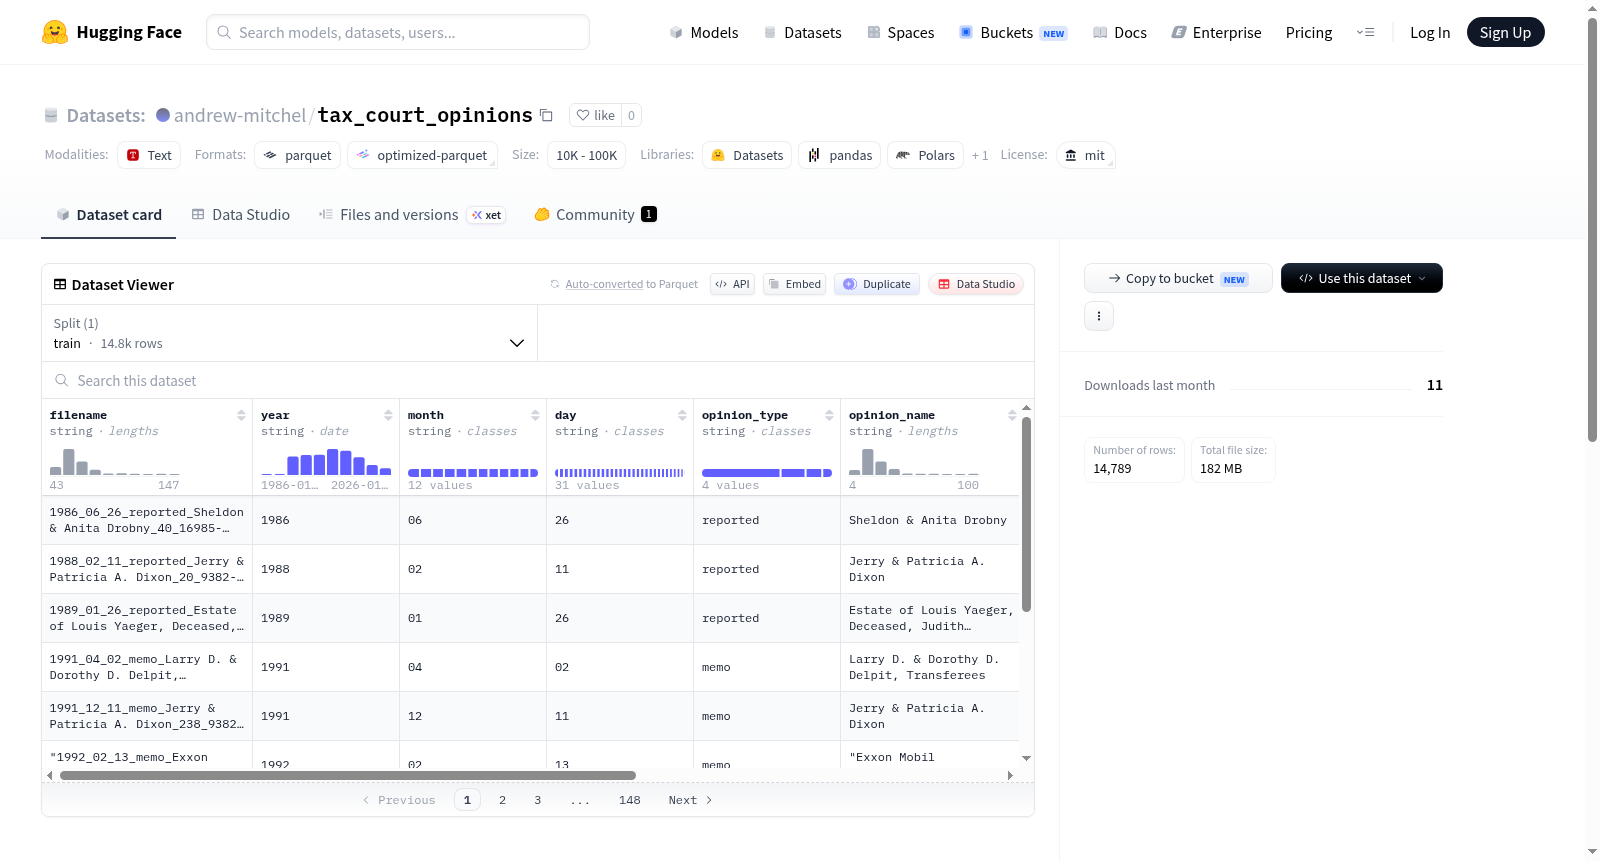
该数据集包含从1995年到2026年4月期间的美国税务法院意见书,总计14,789个文本文件。原始数据以PDF格式发布,并通过pdfminer工具转换为文本格式。数据集涵盖四种意见类型:reported(报告意见)、memo(备忘录意见)、summary(摘要意见)和bench(法庭意见)。文本文件的命名遵循特定格式:YYYY_MM_DD_意见类型_意见名称_页数_案卷号_法官.txt,其中意见名称被截断至100个字符并移除了某些特殊字符,页数基于原始PDF文件。数据经过了一系列文本格式化处理,包括移除所有换行符和分页符、将破折号转换为连字符、尝试修复行末连字符单词、标准化空格以及在法律节标记后调整空格。需要注意的是,2009年至2012年期间的PDF文件包含OCR识别的文本,其准确性低于其他年份。数据集附带一个简短的Python脚本,可用于搜索文本文件内容。该数据集适用于法律文本分析、信息检索、自然语言处理任务以及税务法律研究。
This dataset comprises 14,789 text files containing United States Tax Court opinions, covering the period from 1995 through April 2026. The original data was released in PDF format and converted to text format using the pdfminer tool. The dataset includes four types of opinions: Reported Opinions, Memorandum Opinions, Summary Opinions, and Bench Opinions. The text files follow a specific naming convention: YYYY_MM_DD_<opinion_type>_<opinion_name>_<page_count>_<docket_number>_<judge>.txt. The opinion name is truncated to 100 characters with certain special characters removed, and the page count is derived from the original PDF files. The text data has undergone a series of formatting processing steps, including removing all newline and page break characters, converting em dashes to hyphens, attempting to repair hyphenated words split at line ends, standardizing whitespace, and adjusting spacing following legal section markers. It should be noted that the PDF files from 2009 to 2012 contain OCR-scanned text, which has lower accuracy compared to other years. The dataset includes a concise Python script for searching the contents of the text files. This dataset is applicable to legal text analysis, information retrieval, natural language processing tasks, and tax law research.
数据集概述
- 数据集名称:Tax Court Opinions
- 许可证:MIT
- 数据规模:包含14,789个文本文件
- 时间范围:约1995年至2026年4月
- 数据来源:美国税务法院(U.S. Tax Court)发布的PDF意见书,通过pdfminer工具转换为文本文件
文件命名格式
文本文件的命名格式为:
YYYY_MM_DD_opiniontype_opinionname_numpages_docketnum_judge.txt
其中:
- opiniontype:意见类型,包括 reported(报告)、memo(备忘录)、summary(摘要)、bench(法庭)
- opinionname:意见名称,已截断至100个字符,并移除了某些特殊字符
- numpages:基于原始PDF的页数
数据质量说明
- 较旧的PDF文件包含由OCR生成的文本
- 2009年至2012年期间的OCR结果准确度低于其他年份
文本预处理
已对文本进行以下格式化处理:
- 移除所有换行符和换页符
- 将长破折号和短破折号转换为连字符
- 尝试移除行末连字符(用于断词)
- 将多个连续空格替换为单个空格
- 在节符号(§)后插入空格(如无空格)
- 移除多个节符号(§§)之间的空格
附加工具
- 提供了用于搜索文本文件的Python脚本,可从GitHub页面下载:https://github.com/InternationalTaxAttorney/tax_court_opinion_search
- 也可通过pip安装该Python代码