
Awesome-Music-Recommendation-Datasets
收藏官方服务:
资源简介:
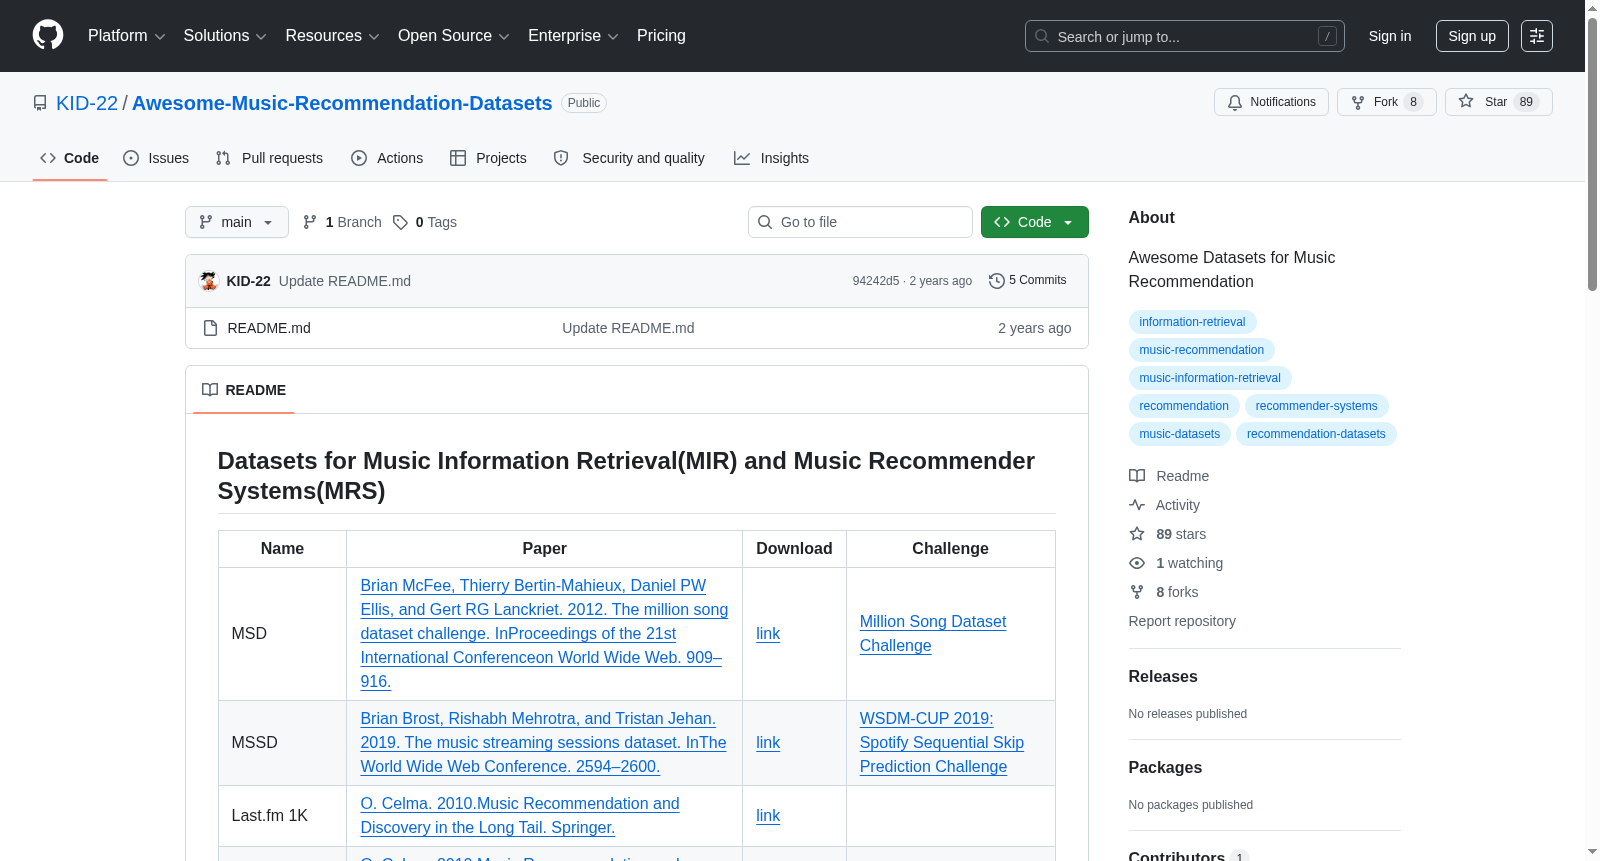
这是一个关于音乐信息检索(MIR)和音乐推荐系统(MRS)的数据集合集,收录了多个公开可用的音乐相关数据集,如MSD、MSSD、Last.fm 1K、Last.fm 360K、30Music、LFM-1b、LFM-2b、KKBOX等。合集提供了每个数据集的名称、相关论文、下载链接和挑战信息,覆盖了音乐推荐和音乐信息检索领域的研究资源。
This is a dataset collection focusing on Music Information Retrieval (MIR) and Music Recommendation Systems (MRS). It incorporates multiple publicly available music-related datasets, including MSD, MSSD, Last.fm 1K, Last.fm 360K, 30Music, LFM-1b, LFM-2b, KKBOX, etc. This collection provides the name, associated academic papers, download links and challenge information for each dataset, covering research resources in the fields of music recommendation and music information retrieval.
创建时间:
2022-02-22
原始信息汇总
数据集详情总结:Awesome-Music-Recommendation-Datasets
该页面汇总了用于音乐信息检索(MIR)和音乐推荐系统(MRS)的多个公开数据集,每个数据集均提供了名称、相关论文、下载链接及关联挑战赛信息。
主要数据集列表
| 数据集名称 | 关联论文 | 下载地址 | 关联挑战赛 |
|---|---|---|---|
| MSD | Brian McFee 等 (2012) - The million song dataset challenge | http://millionsongdataset.com/ | Million Song Dataset Challenge (Kaggle) |
| MSSD | Brian Brost 等 (2019) - The music streaming sessions dataset | http://research.spotify.com/datasets/music-streaming-sessions | WSDM-CUP 2019: Spotify Sequential Skip Prediction Challenge (AIcrowd) |
| Last.fm 1K | O. Celma (2010) - Music Recommendation and Discovery in the Long Tail | http://ocelma.net/MusicRecommendationDataset/lastfm-1K.html | 无 |
| Last.fm 360K | O. Celma (2010) - Music Recommendation and Discovery in the Long Tail | http://ocelma.net/MusicRecommendationDataset/lastfm-360K.html | 无 |
| 30Music | Roberto Turrin 等 (2015) - 30Music Listening and Playlists Dataset | https://recsys.deib.polimi.it/datasets/ | 无 |
| LFM-1b | Markus Schedl (2016) - The lfm-1b dataset for music retrieval and recommendation | http://www.cp.jku.at/datasets/LFM-1b/ | 无 |
| LFM-1b UGP | Markus Schedl 和 Bruce Ferwerda (2017) - Large-scale analysis of group-specific music genre taste from collaborative tags | http://www.cp.jku.at/datasets/LFM-1b/ | 无 |
| LFM-2b | Melchiorre A B 等 (2021) - Investigating gender fairness of recommendation algorithms in the music domain | http://www.cp.jku.at/datasets/LFM-2b/ | 无 |
| KKBOX | 未提供 | https://www.kaggle.com/c/kkbox-music-recommendation-challenge/data | WSDM-CUP 2018: KKBoxs Music Recommendation Challenge (Kaggle) |
| Yahoo!R3 | Benjamin M Marlin 和 Richard S Zemel (2009) - Collaborative prediction and ranking with non-random missing data | https://webscope.sandbox.yahoo.com/catalog.php?datatype=r | 无 |
| Yahoo! Music Dataset | Gideon Dror 等 (2012) - The yahoo! music dataset and kdd-cup’11 | http://kddcup.yahoo.com/datasets.php | KDD-Cup 2011: Recommending Music Items based on the Yahoo! Music Dataset (KDD) |
| #nowplaying | Eva Zangerle 等 (2014) - # nowplaying music dataset: Extracting listening behavior from twitter | https://zenodo.org/record/2594483#.YhncCuhBybg | 无 |
| #nowplaying-RS | Asmita Poddar 等 (2018) - nowplaying-RS: a new benchmark dataset for building context-aware music recommender systems | https://zenodo.org/record/3247476#.Yhnb7ehBybh | 无 |
| MMTD | David Hauger 等 (2013) - The million musical tweets dataset: What can we learn from microblogs | http://www.cp.jku.at/datasets/MMTD/ | 无 |
| NCM | Dennis J Zhang 等 (2022) - NetEase cloud music data | https://idam.zju.edu.cn/newsinfo.php?cid=31&id=240 | 无 |
| SiTunes | Grigorev V 等 (2024) - SiTunes: A Situational Music Recommendation Dataset with Physiological and Psychological Signals | https://github.com/JiayuLi-997/SiTunes_dataset/ | 无 |
额外信息
- 页面提供了一篇中文博客(知乎链接),其中包含对这些数据集的更详细描述。
搜集汇总
数据集介绍
构建方式
在音乐信息检索与推荐系统这一蓬勃发展的研究领域,数据集的构建是驱动算法创新与评估的关键基石。Awesome-Music-Recommendation-Datasets 通过系统性地梳理与整合学术界与工业界的公开资源,汇集了涵盖不同维度的音乐数据集合。该数据集集合的构建方式并非单一数据采集,而是基于对已发表论文中引用数据集的广泛调研与筛选,囊括了诸如百万歌曲数据集(MSD)、Spotify音乐流媒体会话数据集(MSSD)、Last.fm用户收听记录、KKBOX挑战赛数据以及Yahoo!音乐评分数据等。每个数据集均附有原始论文链接、下载地址及相关竞赛信息,从而确保了来源的可靠性与可追溯性,为研究者提供了统一的入口。
特点
该数据集集合具有鲜明的多元性与层次化特点。从数据规模上看,它覆盖了从万级(如Last.fm 1K)到百万级(如MSD、LFM-2b)的用户交互记录,适应不同复杂度模型的需求。从内容维度而言,不仅包含传统的用户-歌曲隐式反馈(如播放次数、跳过行为),还融入了情境化信息,如SiTunes数据集中的生理与心理信号,以及#nowplaying系列从社交媒体提取的实时聆听行为。此外,部分数据集如LFM-1b UGP聚焦于群体音乐品味分析,体现了对用户细粒度偏好的挖掘。这些特征共同构成了一个丰富且结构化的研究资源库。
使用方法
使用者可根据研究目标灵活选用该集合中的特定数据集。例如,针对序列推荐任务,可直接利用MSSD或KKBOX数据集中的时序交互日志;若需评估模型在处理稀疏数据时的鲁棒性,可选用Yahoo!R3这类含有非随机缺失数据的集合。每个数据集均提供明确的下载链接或竞赛平台(如Kaggle、AIcrowd),研究者可通过配套论文了解数据采集流程与预处理细节。此外,该页面还附有一篇中文博客文章,提供了更详尽的描述与使用指南,便于快速上手。建议在使用前仔细阅读各数据集的原始文献,以确保实验设置的准确性与可复现性。
背景与挑战
背景概述
音乐信息检索与推荐系统领域的研究长期受困于高质量标注数据的匮乏,这一问题在长尾音乐内容发现与个性化推荐场景中尤为突出。Awesome-Music-Recommendation-Datasets项目由国际音乐信息检索学界联合维护,自2012年百万歌曲数据集(MSD)挑战赛启动以来,逐步汇集了包括Spotify流媒体会话数据、Last.fm用户收听记录、雅虎音乐评分数据在内的十余个核心基准数据集。这些数据资源由Brian McFee、Markus Schedl等知名学者及其团队构建,旨在解决音乐推荐中的冷启动、序列预测、情境感知等核心问题,催生了诸如WSDM-CUP、KDD-Cup等国际竞赛,深刻推动了音乐计算领域的实证研究范式。
当前挑战
当前数据集面临的核心挑战包括:1)领域问题层面,音乐推荐需应对用户偏好的动态演化与长尾分布,现有数据集多依赖隐式反馈(如播放次数),缺乏对用户听觉情境(如情绪、活动)的显式建模,导致推荐系统难以突破同质化瓶颈;2)构建过程中,数据采集面临版权限制与隐私合规的双重约束,如MSD因许可问题仅保留特征而非原始音频,而Last.fm数据集存在用户年龄、性别等人口统计信息缺失,限制了公平性审计与群组分析的研究深度。此外,跨平台数据异构性及时间跨度不一致性,进一步增加了多源融合与时序建模的复杂度。
常用场景
经典使用场景
在音乐信息检索与推荐系统研究领域,Awesome-Music-Recommendation-Datasets 汇集了诸如百万歌曲数据集、Spotify音乐流媒体会话数据集、Last.fm用户听歌记录数据集等经典资源,广泛用于音乐推荐算法的训练与评估。研究者常利用这些数据集构建协同过滤、矩阵分解或深度学习模型,以预测用户对歌曲的偏好,同时结合时序信息实现序列推荐。这些数据源覆盖了显式反馈与隐式反馈,为探索音乐长尾推荐、冷启动问题及用户行为建模提供了坚实的数据基础,成为该领域不可或缺的标准化评测平台。
实际应用
在实际产业环境中,这些数据集驱动了音乐流媒体平台的个性化服务优化。例如,Spotify利用MSSD数据集开展序列跳过预测挑战,从而改进播放列表的连续性生成与用户留存策略;网易云音乐则基于NCM数据集探索运营管理中的推荐策略。此外,SiTunes数据集融合生理与心理信号,推动了情境感知音乐推荐的落地,使推荐系统能够根据用户实时情绪或活动状态调整曲目。这些应用不仅提升了用户体验的满意度,还助力平台实现商业目标,如增加收听时长与付费转化率。
衍生相关工作
围绕该数据集集合,学术界衍生出一系列标志性工作。例如,基于百万歌曲数据集发起的挑战赛催生了多种高效的特征提取与降维算法;Spotify流媒体会话数据集直接促成了WSDM Cup 2019中序列跳过预测模型的竞赛,涌现出基于循环神经网络与注意力机制的创新架构。#nowplaying-RS数据集则激发了上下文感知推荐的研究热潮,推动了多模态融合方法的进展。这些衍生工作不仅深化了对音乐消费行为的理解,还为跨领域推荐系统(如视频、新闻)提供了可迁移的技术范式,持续塑造着推荐系统领域的前沿方向。
以上内容由遇见数据集搜集并总结生成


