llizhx/sampled_coco2014_100_pink
收藏资源简介:
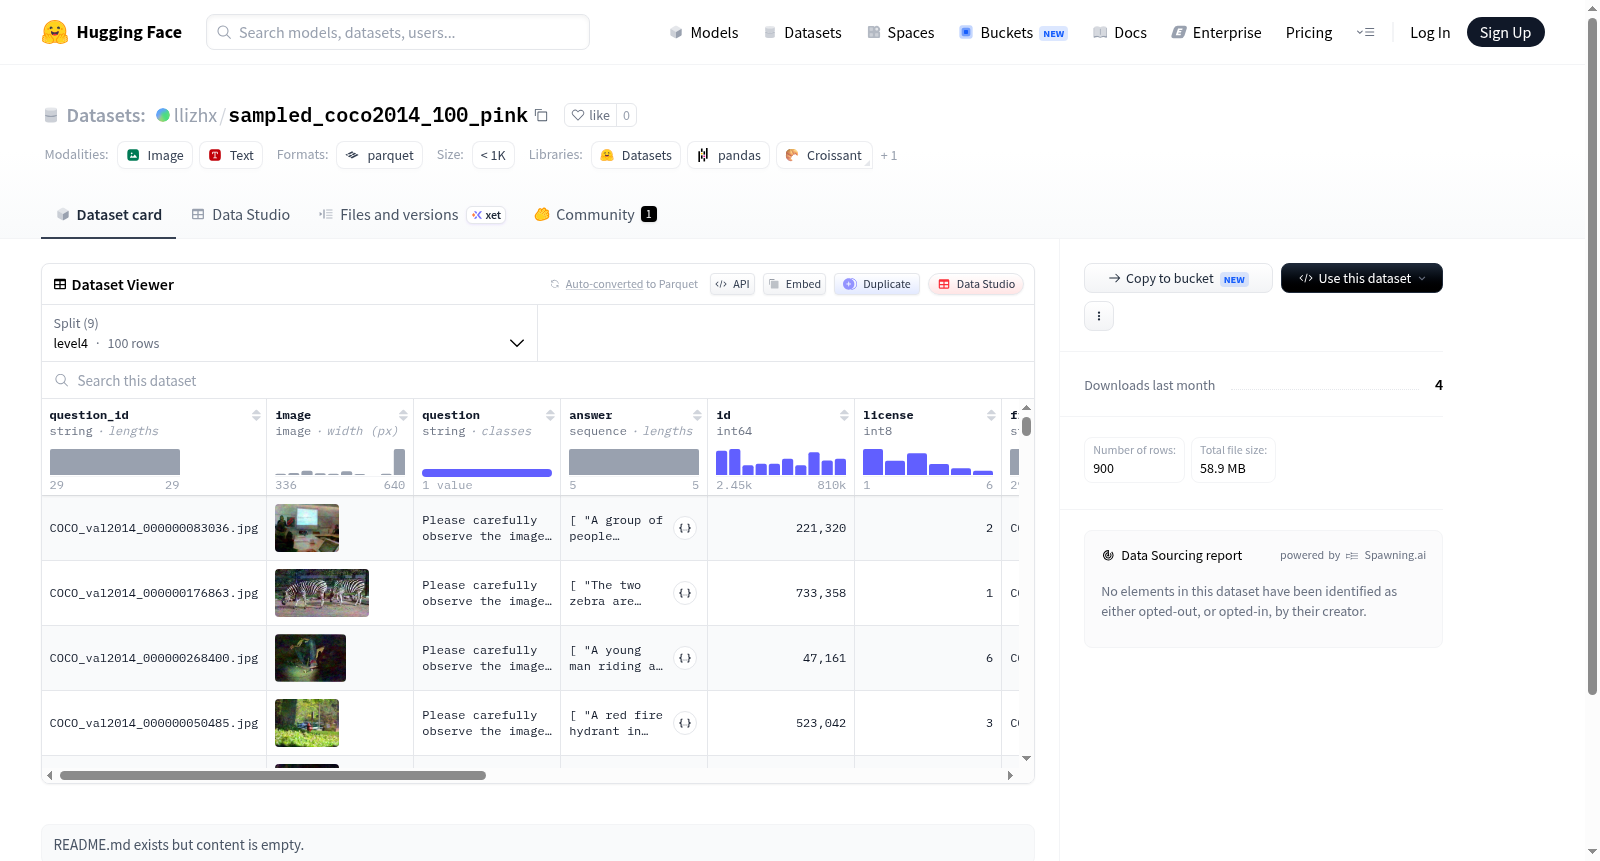
--- dataset_info: features: - name: question_id dtype: string - name: image dtype: image - name: question dtype: string - name: answer sequence: string - name: id dtype: int64 - name: license dtype: int8 - name: file_name dtype: string - name: coco_url dtype: string - name: height dtype: int32 - name: width dtype: int32 - name: date_captured dtype: string - name: instance sequence: string splits: - name: level4 num_bytes: 6411200.0 num_examples: 100 - name: level3 num_bytes: 6075833.0 num_examples: 100 - name: level2 num_bytes: 5809247.0 num_examples: 100 - name: level5 num_bytes: 6579360.0 num_examples: 100 - name: level9 num_bytes: 7446459.0 num_examples: 100 - name: level7 num_bytes: 7119527.0 num_examples: 100 - name: level6 num_bytes: 6821588.0 num_examples: 100 - name: level1 num_bytes: 5519686.0 num_examples: 100 - name: level8 num_bytes: 7321931.0 num_examples: 100 download_size: 58846188 dataset_size: 59104831.0 configs: - config_name: default data_files: - split: level4 path: data/level4-* - split: level3 path: data/level3-* - split: level2 path: data/level2-* - split: level5 path: data/level5-* - split: level9 path: data/level9-* - split: level7 path: data/level7-* - split: level6 path: data/level6-* - split: level1 path: data/level1-* - split: level8 path: data/level8-* ---
数据集信息: 特征: - 问题ID(question_id):数据类型为字符串 - 图像(image):数据类型为图像 - 问题(question):数据类型为字符串 - 答案(answer):数据类型为字符串序列 - 编号(id):数据类型为64位整型 - 许可证(license):数据类型为8位整型 - 文件名(file_name):数据类型为字符串 - COCO链接(coco_url):数据类型为字符串 - 高度(height):数据类型为32位整型 - 宽度(width):数据类型为32位整型 - 拍摄日期(date_captured):数据类型为字符串 - 实例(instance):数据类型为字符串序列 数据划分: - 等级4(level4):占用字节数6411200.0,样本量100 - 等级3(level3):占用字节数6075833.0,样本量100 - 等级2(level2):占用字节数5809247.0,样本量100 - 等级5(level5):占用字节数6579360.0,样本量100 - 等级9(level9):占用字节数7446459.0,样本量100 - 等级7(level7):占用字节数7119527.0,样本量100 - 等级6(level6):占用字节数6821588.0,样本量100 - 等级1(level1):占用字节数5519686.0,样本量100 - 等级8(level8):占用字节数7321931.0,样本量100 下载总大小:58846188字节,数据集总大小:59104831.0字节 配置: - 配置名称:默认配置(default),数据文件: - 等级4拆分:对应数据路径为data/level4-* - 等级3拆分:对应数据路径为data/level3-* - 等级2拆分:对应数据路径为data/level2-* - 等级5拆分:对应数据路径为data/level5-* - 等级9拆分:对应数据路径为data/level9-* - 等级7拆分:对应数据路径为data/level7-* - 等级6拆分:对应数据路径为data/level6-* - 等级1拆分:对应数据路径为data/level1-* - 等级8拆分:对应数据路径为data/level8-*
数据集概述
数据集特征
- question_id: 数据类型为字符串。
- image: 数据类型为图像。
- question: 数据类型为字符串。
- answer: 数据类型为字符串序列。
- id: 数据类型为整数64位。
- license: 数据类型为整数8位。
- file_name: 数据类型为字符串。
- coco_url: 数据类型为字符串。
- height: 数据类型为整数32位。
- width: 数据类型为整数32位。
- date_captured: 数据类型为字符串。
- instance: 数据类型为字符串序列。
数据集分割
- level4: 大小为6411200字节,包含100个样本。
- level3: 大小为6075833字节,包含100个样本。
- level2: 大小为5809247字节,包含100个样本。
- level5: 大小为6579360字节,包含100个样本。
- level9: 大小为7446459字节,包含100个样本。
- level7: 大小为7119527字节,包含100个样本。
- level6: 大小为6821588字节,包含100个样本。
- level1: 大小为5519686字节,包含100个样本。
- level8: 大小为7321931字节,包含100个样本。
数据集大小
- 下载大小: 58846188字节。
- 数据集总大小: 59104831.0字节。
配置文件
- config_name: default
- data_files:
- split: 不同级别的分割对应的路径。
- path: 数据文件路径,格式为
data/level*-*。
- path: 数据文件路径,格式为
- split: 不同级别的分割对应的路径。