
遇见数据集

Kukedlc/web-design-diamond

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

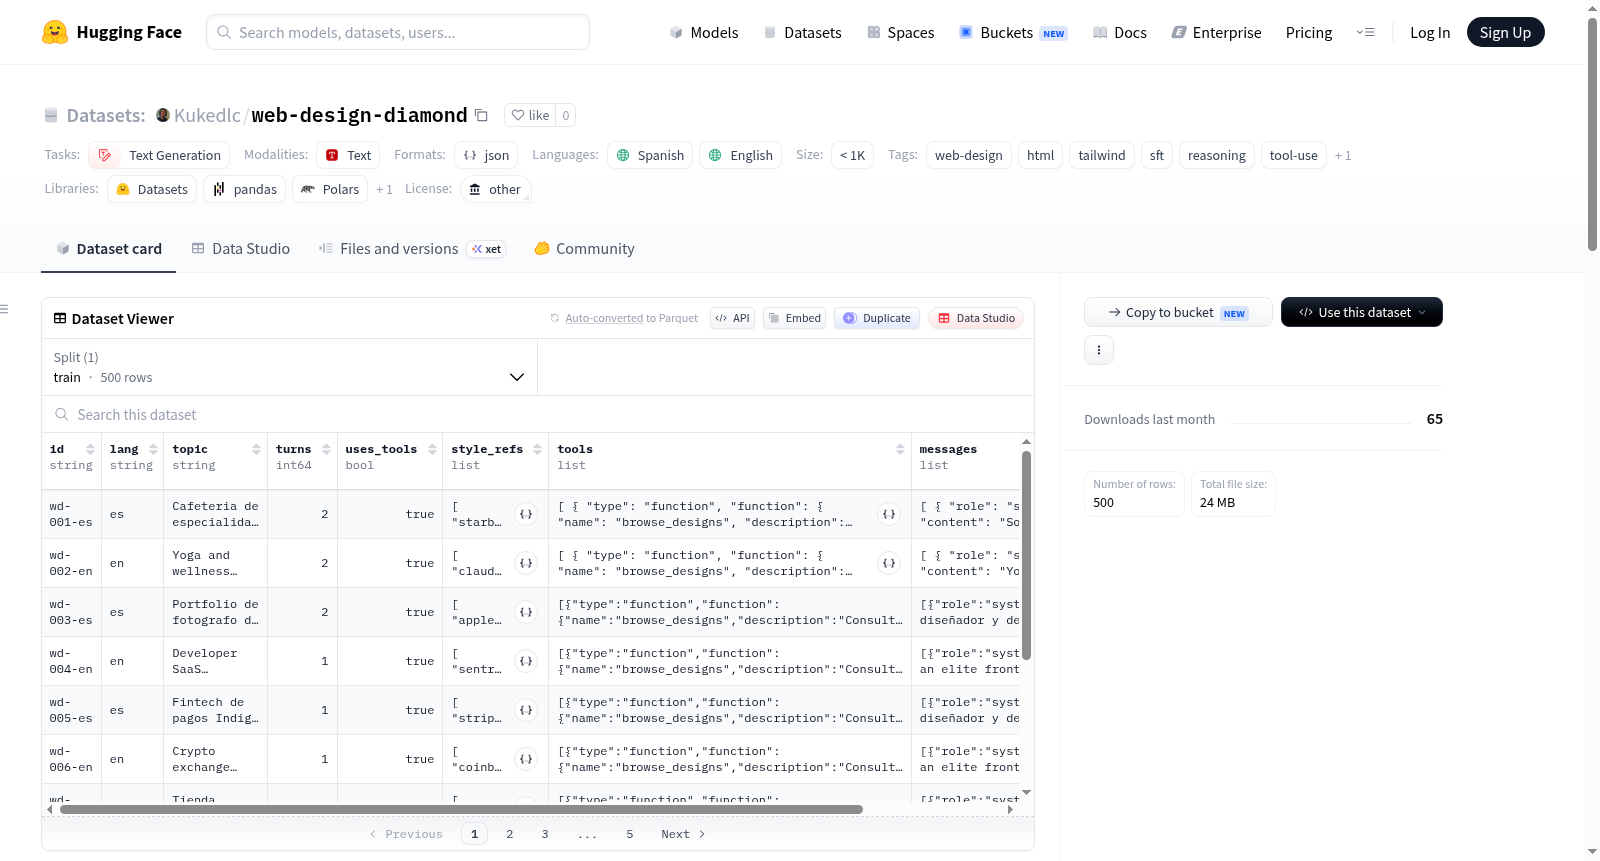
Web Design Diamond SFT数据集是一个用于训练小型语言模型(2B-8B参数)的指令微调数据集,专门用于根据自然语言指令生成高质量、自包含的HTML页面。该数据集具有以下核心特点:1)顺序推理机制,模型在实施前进行思考规划,避免信息泄露;2)真实工具使用,模型可以浏览和获取真实品牌设计系统(如Stripe、Linear、Tesla等)的实际设计数据;3)多轮对话支持,30%的示例包含修改请求,需要更新完整页面;4)双语内容,50%西班牙语和50%英语,西班牙语包含正确的重音和ñ字符;5)自包含输出,生成单个index.html文件,包含4-5个部分,无需构建即可运行。数据集包含500个示例(250个西班牙语,250个英语),其中150个为多轮对话,350个示例使用工具调用。数据格式为JSONL,包含推理内容、工具调用和完整的对话历史,适合直接用于监督微调训练。

The Web Design Diamond SFT Dataset is an instruction tuning dataset for training small language models with parameters ranging from 2B to 8B, specifically designed to generate high-quality, self-contained HTML pages based on natural language instructions. The core features of this dataset are as follows: 1) Sequential reasoning mechanism: The model conducts thinking and planning prior to implementation to avoid information leakage; 2) Real-world tool usage: The model can browse and access actual design data from real brand design systems such as Stripe, Linear, Tesla, etc.; 3) Multi-turn dialogue support: 30% of the examples include modification requests that require updating the complete web page; 4) Bilingual content: 50% Spanish and 50% English, with Spanish text containing correct accents and the ñ character; 5) Self-contained output: Generates a single index.html file consisting of 4-5 sections, which can run directly without additional building steps. The dataset contains 500 total examples (250 in Spanish and 250 in English), among which 150 are multi-turn dialogue instances and 350 examples use tool calls. The data is formatted as JSONL, including reasoning content, tool invocation records and complete conversation histories, making it suitable for direct supervised fine-tuning training.
提供机构:
Kukedlc
搜集汇总
数据集介绍
Kukedlc/web-design-diamond 数据集图片
构建方式
Web Design Diamond 数据集旨在赋能小型语言模型(参数规模在2B至8B之间),使其能够根据自然语言描述生成可直接运行的、自包含的 index.html 单页设计。该数据集以 JSONL 格式存储,每条样本包含多轮对话、工具调用记录以及模型的逐步思考过程(reasoning_content)。构建过程中,模型需先进行顺序推理,明确设计意图,再通过调用 browse_designs 与 get_design 工具,从真实品牌设计系统库(如 Stripe、Linear 等)中检索风格参考,确保生成的颜色与布局具有真实 grounding。数据集中30%的样本包含多轮修改请求,模拟真实设计迭代场景。所有输出均为自包含 HTML,无需构建工具即可直接渲染。
特点
该数据集的核心特色在于融合了顺序推理与工具使用。模型在生成代码前会输出脱离具体 token 的思考过程,避免信息泄露;通过调用基于真实品牌设计文档的工具,保证了风格引用的准确性与多样性。数据集为大模型微调(SFT)设计,采用中英双语(各250条),且高度关注西班牙语中重音与 ñ 字符的准确性。每条样本输出均为一个包含4至5个区块、样式统一的自包含 HTML 页面,并通过 Chromium headless 无头浏览器验证渲染无误,确保零 JavaScript 与控制台错误。
使用方法
用户可通过 Hugging Face Datasets 库加载该数据集:使用 load_dataset('json', data_files='train.jsonl', split='train') 即可直接获取训练切分。每条样本中的 reasoning_content 字段对应 DeepSeek/Qwen 格式的 <think> 思维链标签,可直接用于多轮对话与工具调用场景的模型训练。数据集的 meta 文件夹内提供了中英双语系统提示词与工具调用的 JSON 模式定义,便于用户复现训练流程。该数据集特别适合用于训练快速、高效的小型网页设计模型,后续可结合 Linter 与视觉评估工具形成完整的设计辅助管线。
背景与挑战
背景概述
Web Design Diamond 数据集由 VoltAgent 研究团队于近期创建,专注于通过监督微调(SFT)训练 2B 至 8B 参数规模的大型语言模型(LLM),实现从自然语言描述到高质量自包含 HTML 页面的端到端代码生成。该数据集的核心研究问题在于弥合自然语言交互与前端代码自动生成之间的鸿沟,尤其强调生成页面在视觉上达到“高端质感”并可直接运行。数据集包含 500 个双语(英语与西班牙语)样本,覆盖单轮生成及多轮迭代编辑场景,并创新性地引入工具调用机制,使模型能够基于真实设计系统(如 Stripe、Tesla 等品牌的设计参考)进行推理与代码生成,从而在代码自动合成领域建立了风格可控、逻辑可追溯的高质量基准,对低参数模型在专业前端开发辅助领域的实用性推进具有重要意义。
当前挑战
该数据集所解决的领域挑战主要包括:自然语言到前端代码生成的语义精确性与视觉风格保真度之间的矛盾,即模型需同时理解用户意图并生成视觉上协调、功能完整的单页面应用;以及小规模 LLM 在处理多步推理与工具调用时的正确性保障问题。在数据集构建过程中面临的关键挑战包括:1)确保训练数据中推理过程(thinking)与工具调用结果之间的无泄漏(no-leakage)特性,避免模型通过隐含词句绕过真实推理;2)实现双语环境下上下文语义的严格一致性,特别是西班牙语中重音符号与字母 ñ 的准确嵌入;3)自动化验证 650 余个 HTML 页面在 Chromium 无头浏览器中零错误渲染,同时确保颜色等样式参数与真实设计文档完全对齐,这对数据质量控制和工程实现提出了较高要求。
常用场景
经典使用场景
Web Design Diamond 数据集的核心应用场景在于对中小规模语言模型(参数规模在 2B 至 8B 之间)进行监督式微调(SFT),使其能够根据自然语言描述直接生成一份自包含、可直接运行的 index.html 网页。该网页采用 Tailwind CSS(通过 CDN 引入)与原生 JavaScript 构建,无需任何构建工具即可在浏览器中呈现具有高级设计感的响应式页面。数据集中包含单轮与多轮对话样本,其中多轮样本模拟了用户提出修改需求(如增删改页面区块)的交互场景,模型需在理解上下文的基础上输出更新后的完整 HTML 代码,从而训练模型的顺序推理与增量修改能力。
衍生相关工作
围绕 Web Design Diamond 数据集已经衍生出若干值得关注的经典工作与研究方向。首先,数据集中对真实品牌设计系统(如 Stripe、Linear、Tesla 等)的工具调用机制,启发了将外部知识库(如设计规范文档)融入代码生成流程的工作,形成了‘检索增强生成(RAG)+ 代码生成’的新范式。其次,推理过程与工具使用分离的设计被后续研究采纳,用于探究模型在复杂任务中何时依赖内部知识、何时调用外部工具,从而改进元认知训练策略。此外,多轮编辑场景的设置催生了对代码版本追踪与差异生成的研究,部分工作借鉴其多轮对话结构,开发了面向网页迭代的上下文感知模型。最后,双语数据的构建也为跨语言代码生成任务提供了数据集构建参考,推动了代码生成模型在非英语语言上的性能评估与优化。
数据集最近研究
最新研究方向
探索将隐式推理(thinking)与真实风格工具库调用深度融合的小参数语言模型微调路径,实现从自然语言指令到自包含、可即时渲染的高质量单页HTML代码的端到端生成。该数据集针对2B-8B量级模型,引入顺序推理与工具协同机制——模型在生成代码前需通过<think>块进行无泄漏规划,并基于Stripe、Linear等61-71个真实品牌设计系统的DESIGN.md文件进行检索增强,确保输出风格的精确锚定与事实一致性。其中30%的多轮交互样本模拟迭代修改场景,覆盖增删改节等真实工作流。这一设计直击当前代码生成模型在复杂设计任务中常出现的风格漂移与自洽性不足痛点,为轻量化、可落地的前端智能辅助工具提供了关键的训练基座,尤其契合低代码开发与快速原型设计领域对模型实时响应与样式可靠性的前沿需求。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

