
遇见数据集

alexkstern/nca-paper-share10-seq_len_1024-164M

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

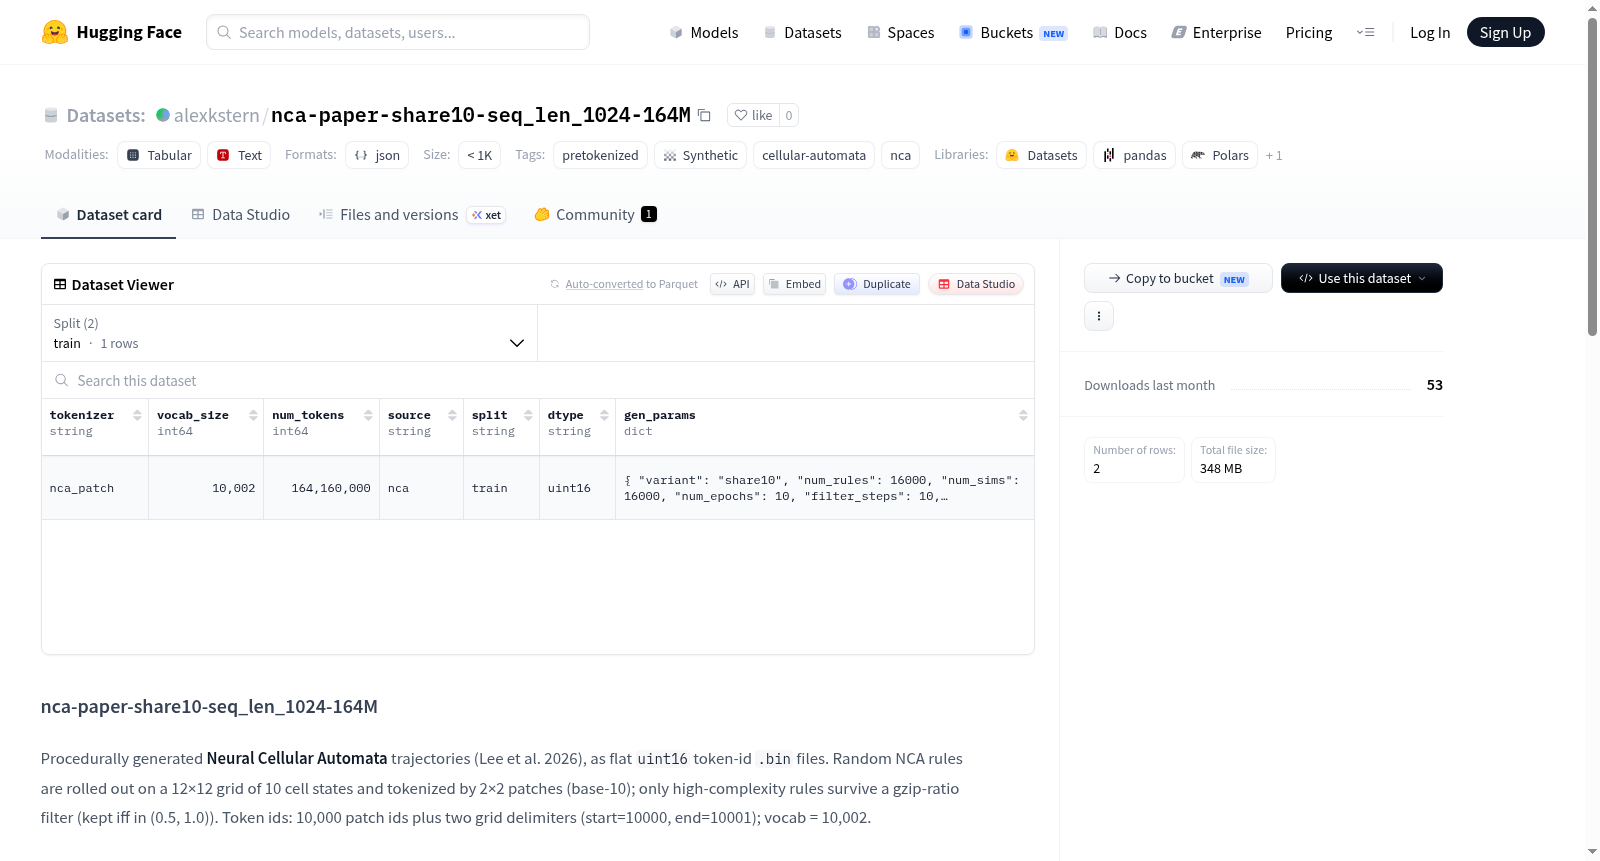
该数据集是通过程序生成的神经细胞自动机轨迹,以平坦的uint16 token-id .bin文件格式存储。随机神经细胞自动机规则在12×12网格上展开,包含10种细胞状态,并通过2×2补丁进行标记化(基数为10)。仅通过gzip比率过滤器保留高复杂性规则(保留比率在0.5到1.0之间的规则)。token ID包括10,000个补丁ID和两个网格分隔符(起始=10000,结束=10001),词汇表大小为10,002。数据集分为训练集和验证集,训练集包含164,160,000个token,验证集包含10,000,422个token。每个轨迹记录固定为1026个token,包含网格边界的分隔符ID(在损失计算中被屏蔽)。训练集和验证集来自同一生成器的独立流,token数量等于文件大小除以2。复杂性过滤器基于每个规则应用,gzip波段(0.5, 1.0)对每个规则评分一次,基于单个随机初始化(10网格展开)。每个保留规则生成的模拟使用新的初始化,不重新评分,因此由于神经细胞自动机规则可能对初始化敏感(多个盆地),极小部分轨迹(约0.01%)可能退化为固定点(如均匀网格),这些低复杂性轨迹无害,是每个规则过滤器的固有特性,而非生成错误。

This dataset consists of programmatically generated neural cellular automaton (NCA) trajectories, stored as flat uint16 token-id .bin files. Random neural cellular automaton rules are evolved on 12×12 grids with 10 cell states, and tokenized via 2×2 patches (radix 10). Only high-complexity rules are retained via a gzip ratio filter, with rules with a ratio between 0.5 and 1.0 kept. The token IDs include 10,000 patch IDs and two grid separators (start = 10000, end = 10001), resulting in a vocabulary size of 10,002. The dataset is split into training and validation sets: the training set contains 164,160,000 tokens, while the validation set contains 10,000,422 tokens. Each trajectory record is fixed at 1026 tokens, including separator IDs for grid boundaries which are masked during loss calculation. The training and validation sets are derived from independent streams of the same generator, and the token count equals the file size divided by 2. The complexity filter is applied on a per-rule basis: each rule is scored once against the gzip band (0.5, 1.0) based on a single random initialization with 10 grid evolutions. Simulations generated for each retained rule use a new random initialization and are not re-scored. As neural cellular automaton rules may be initialization-sensitive (with multiple basins of attraction), a tiny fraction of trajectories (~0.01%) may degenerate into fixed points such as uniform grids. These low-complexity trajectories are harmless and an inherent property of the per-rule filter, rather than a generation error.
提供机构:
alexkstern
搜集汇总
数据集介绍
alexkstern/nca-paper-share10-seq_len_1024-164M 数据集图片
构建方式
该数据集基于神经细胞自动机(Neural Cellular Automata, NCA)的演化轨迹构建而成。具体而言,随机生成的NCA规则在12×12的网格上展开,每个网格包含10种细胞状态,并通过2×2的块进行token化编码,形成基数为10的token序列。为确保数据质量,仅保留通过gzip压缩比筛选(介于0.5至1.0之间)的高复杂度规则。每个规则在单个随机初始状态下进行一次评分,筛选后的规则使用全新的初始状态生成轨迹,最终形成固定长度为1026个token的记录,其中包含10000个块ID和两个网格分隔符。
使用方法
使用该数据集时,可通过Hugging Face的标准下载器获取二进制文件,并利用NumPy库进行加载。具体地,调用`hf_hub_download`下载`train.bin`或`val.bin`,随后使用`np.memmap`以'uint16'类型读取,并将token序列重塑为每行1026个token的二维数组。分隔符ID(10000和10001)用于标记网格边界,在损失计算中应被掩码忽略。用户可根据需求将多组轨迹打包至单行中,灵活适应不同训练框架。
背景与挑战
背景概述
神经细胞自动机(Neural Cellular Automata, NCA)作为一种融合深度学习与元胞自动机的崭新范式,在复杂系统建模与自组织行为模拟中展现出了巨大潜力。由Lee等人于2026年提出的NCA-paper-share10-seq_len_1024-164M数据集,由研究团队程序化生成,旨在为NCA动力学轨迹的预训练与表征学习提供大规模语料库。该数据集基于12×12网格、10种细胞状态与2×2局部邻域编码,通过随机规则展开NCA演化,并利用gzip压缩比过滤保留高复杂性规则,最终构建了包含1.64亿个uint16标记的训练集与1000万标记的验证集。该数据集的发布填补了NCA领域大规模、高质量预训练数据的空白,为后续NCA模型的泛化能力提升与复杂规则发现研究奠定了坚实基础。
当前挑战
该数据集所解决的领域核心挑战在于,神经细胞自动机规则空间的复杂性度量与高效数据生成。具体而言,NCA规则对初始状态高度敏感,存在多吸引子盆地(multiple basins)现象,使得低复杂性规则容易被错误保留,而高复杂性规则又可能因采样不足导致生成效率低下。该数据集通过首创的基于gzip压缩比的分规则过滤机制,在(0.5, 1.0)的带通范围内筛选规则,有效区分了高复杂性演化动力学与退化均匀态。然而,构建过程中仍面临内在挑战:因规则过滤是静态评分,约0.01%的轨迹可能因初始条件敏感而坍缩至固定点,且这类低复杂性轨迹可在不同模拟中精确重复,虽属无害噪声,却揭示了规则过滤策略在应对初始条件多样性时的局限性。
常用场景
经典使用场景
该数据集专为神经细胞自动机(NCA)轨迹的序列建模而设计,其核心应用场景在于预训练语言模型或自回归Transformer模型,使其学习细胞自动机规则驱动下的复杂时空演化模式。数据以固定长度的标记序列形式呈现,每个序列对应一个12×12网格上的27步轨迹,经2×2分块标记化后生成1026个令牌,包含10000个图块ID和两个网格分隔符。研究者可借此训练模型预测细胞状态演化的下一步,或探索规则驱动的生成任务。
解决学术问题
该数据集解决了在结构化规则空间中研究序列模型的泛化能力与复杂性建模的关键学术问题。通过引入gzip压缩率过滤器,仅保留复杂度适中的规则(压缩率介于0.5至1.0之间),有效筛选出具有丰富动态行为的NCA规则,避免了过于简单或混沌的退化轨迹。这为量化规则复杂度与模型学习效果之间的关系提供了可控实验平台,推动了自回归模型在程序化生成科学和计算模拟领域的前沿探索。
实际应用
在实际应用中,该数据集可服务于神经网络架构的基准测试,尤其是在评估模型对结构化序列数据的记忆、推理与生成能力方面。研究者可将其用于验证Transformer或状态空间模型在长程依赖任务上的表现,或作为合成数据源训练轻量级生成模型。此外,由于NCA规则模拟了自组织系统的涌现行为,该数据集在生物形态发生模拟、图案生成以及自动化规则发现等交叉领域具有潜在实用价值。
数据集最近研究
最新研究方向
该数据集以神经细胞自动机(NCA)为核心,探索程序化生成的复杂轨迹数据在前沿深度学习中的潜力。近期研究聚焦于利用gzip压缩比筛选高复杂性规则,结合12×12网格与10种细胞状态,通过2×2分块编码为10002个token的序列,模拟涌现行为。这一方向与人工生命、自组织系统和生成式AI的热点紧密相连,尤其为探索动态系统规则敏感性(如多吸引子现象)提供了基准,推动了序列模型对规则级复杂度的无监督学习。其意义在于为理解自举式规则演化和模式生成机制开辟新路径,对神经网络的结构偏好与涌现动力学研究具有启示。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

