
遇见数据集

yusufizzetmurat/fed-pulse-training-package

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

该数据集是用于fed-pulse FOMC文本分析项目的训练语料库,包含规范化的FOMC事件数据集(如events.parquet)、分割数据、折叠清单、利率面板(rates_panel.parquet)、语言特征(linguistic_features.parquet)、货币政策意外事件(mp_surprises.parquet)、宏观状态数据(macro_state.parquet)、规范化注册表(registry_normalized.jsonl)以及质量报告。数据来源于美联储公开市场委员会(FOMC)的声明、会议纪要和新闻发布会(来自美国联邦储备系统理事会,公共领域),并整合了来自gtfintechlab/fomc_communication和drlexus/fed-statements-and-minutes Kaggle档案的监督标签。此外,还包括国债收益率和宏观系列数据(来自FRED)、股票/波动率价格(通过Yahoo Finance via yfinance)以及货币政策意外系列(来自Acosta MPS和相关公共数据集)。

This dataset is a training corpus for the fed-pulse FOMC text analysis project, which includes standardized FOMC event datasets (e.g., events.parquet), split datasets, fold manifests, interest rate panels (rates_panel.parquet), linguistic features (linguistic_features.parquet), monetary policy surprise datasets (mp_surprises.parquet), macroeconomic state data (macro_state.parquet), normalized registry (registry_normalized.jsonl), and quality reports. The data are sourced from the statements, meeting minutes, and press conferences of the Federal Open Market Committee (FOMC), obtained from the Board of Governors of the Federal Reserve System (public domain), and supplemented with supervised labels from the Kaggle datasets of gtfintechlab/fomc_communication and drlexus/fed-statements-and-minutes. In addition, it also includes Treasury yield and macroeconomic series data (from FRED), equity and volatility prices (via Yahoo Finance via yfinance), and monetary policy surprise series (from Acosta MPS and related public datasets).
提供机构:
yusufizzetmurat
搜集汇总
数据集介绍
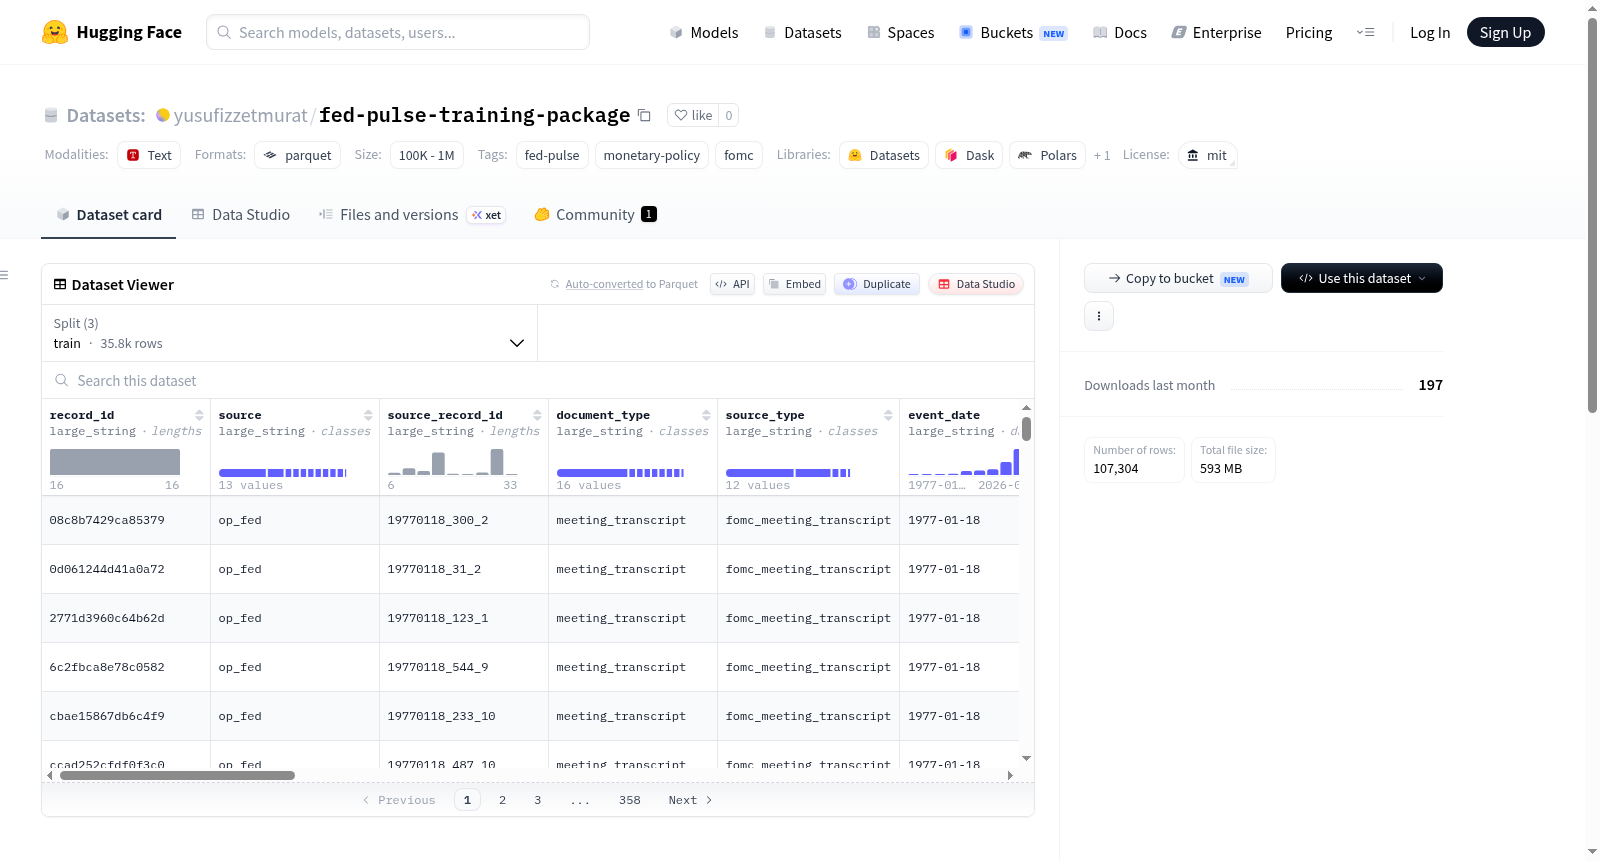
yusufizzetmurat/fed-pulse-training-package 数据集图片
构建方式
该数据集源自Fed-Pulse联邦公开市场委员会文本分析项目,旨在为货币政策研究提供结构化训练语料。其构建过程整合了多源异构数据:通过爬取美联储官网的FOMC声明、会议纪要及新闻发布会文本,融合了gtfintechlab/fomc_communication与历史Kaggle档案中的监督标签,形成标准化事件语料库。同时结合FRED的国债收益率与宏观序列、雅虎财经的权益与波动率数据,以及Acosta MPS货币政策意外序列,协同构建出包含事件分割、折叠清单、利率面板、语言特征及宏观状态等多元组件的综合性训练包。
特点
该数据集的核心特点在于其多维整合性与标准化架构。它不仅提供了时序对齐的FOMC事件数据(events.parquet)与对应的货币政策意外指标(mp_surprises.parquet),还纳入了语言特征分析(linguistic_features.parquet)与宏观状态变量(macro_state.parquet),形成从文本语义到市场影响的完整链路。数据质量通过分折叠清单与质量报告保障,支持跨模态的货币政策文本分析研究。
使用方法
用户可通过执行python -m app.data.pipeline_data_prep --all-sources命令一键复现数据集的构建流程,实现从原始数据抓取到标准格式输出的全自动化。生成的parquet与jsonl文件可直接用于训练金融文本分析模型,如BERT或GPT系列,以解析FOMC措辞的暗示性政策立场。推荐在Jupyter Notebook环境下调用Pandas或Dask读取events.parquet,结合rates_panel.parquet进行事件-市场反应联合建模。
背景与挑战
背景概述
联邦公开市场委员会(FOMC)的货币政策沟通是金融市场波动与宏观经济预期的关键驱动因素,然而对其文本内容进行系统化、结构化的量化分析仍面临数据碎片化与标注不一致的挑战。fed-pulse-training-package数据集由研究者Yusuf Izzet Murat创建,旨在构建一个标准化的FOMC文本分析训练语料库,整合自美联储官网、gtfintechlab等权威来源,涵盖声明、会议纪要及新闻发布会等核心文件。该数据集不仅包含事件时间序列、利率面板与宏观状态变量,还融合了货币政策的意外冲击序列,为自然语言处理在货币政策研究中的应用奠定了坚实基础,对金融文本挖掘与中央银行沟通分析领域产生了显著影响。
当前挑战
该数据集主要解决了货币政策文本分析的领域难题,即如何从非结构化的FOMC沟通中提取可量化的政策倾向与市场预期信号,以填补传统计量经济学模型在语义分析上的空白。在构建过程中,面临的关键挑战包括:异构数据源(如演讲、会议纪要、利率公告)的时间对齐与格式统一,监督性标签在不同历史时期(如从Kaggle与学术论文中获取)的一致性校验,以及宏观变量与文本特征在事件窗口内的动态耦合关系处理。此外,实时数据更新与历史版本的兼容性维护也对数据集的长期可用性提出了严苛要求。
常用场景
经典使用场景
联邦储备系统(Fed)的货币政策决策对全球金融市场具有深远影响,而联邦公开市场委员会(FOMC)的官方沟通文本作为政策意图的核心载体,历来是金融文本分析领域的研究焦点。fed-pulse-training-package数据集整合了FOMC声明、会议纪要及新闻发布会全文,辅以标准化的事件标注与结构化元数据,为研究者提供了端到端的训练语料。其最经典的用途在于构建监督式文本分类与情感分析模型,用以从政策措辞中自动提取货币政策的松紧倾向,或将沟通内容映射至预设的叙事框架(如通胀关注、就业评估)。该数据集亦被广泛用于训练序列标注模型,以识别文本中关于利率路径、前瞻指引或经济前景的特定表述,从而支撑更精细的政策沟通解码研究。
实际应用
在实际金融业务中,该数据集的核心应用场景在于增强金融机构的宏观交易策略与风险管理流程。投资银行与对冲基金可利用内置的利率惊喜度量(mp_surprises)结合文本特征,构建基于实时FOMC沟通信号的高频交易信号发生器,辅助自动化交易系统对政策声明发布窗口内的市场异动做出快速反应。同时,风险管理团队可以基于历史沟通文本与对应市场波动的关联模式,开发压力测试情景,评估未来不同政策措辞演变下投资组合的脆弱性。此外,资产管理部门亦可将数据集中的文本嵌入向量作为输入特征,优化全球宏观基金的资产配置模型,将央行沟通这一半结构化信息转化为可解释的定量输入,从而提升决策的预见性与系统性。
衍生相关工作
该数据集的发布已催生了若干具有代表性的衍生研究工作。沿着其基础架构,研究者开发了专门针对FOMC会议前“静默期”文本信息泄露的异常检测框架,通过对比静默期前后的语言分布统计量,量化内幕信息流通的潜在痕迹。另一经典工作是构建层次化注意力网络模型,利用数据集中带标注的段落边界,自动定位每份FOMC声明中最能驱动市场走势的关键句子。此外,基于该数据集的多模态融合模型开始涌现,将文本情感与同期债券收益率曲线斜率的变化联合建模,显著提升了对未来三个月联邦基金利率路径预测的准确率。这些工作共同拓展了fed-pulse作为基准测试平台的价值,推动了央行沟通分析从描述性统计向可验证的预测科学演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

