corpus-social-media-government-nz
收藏资源简介:
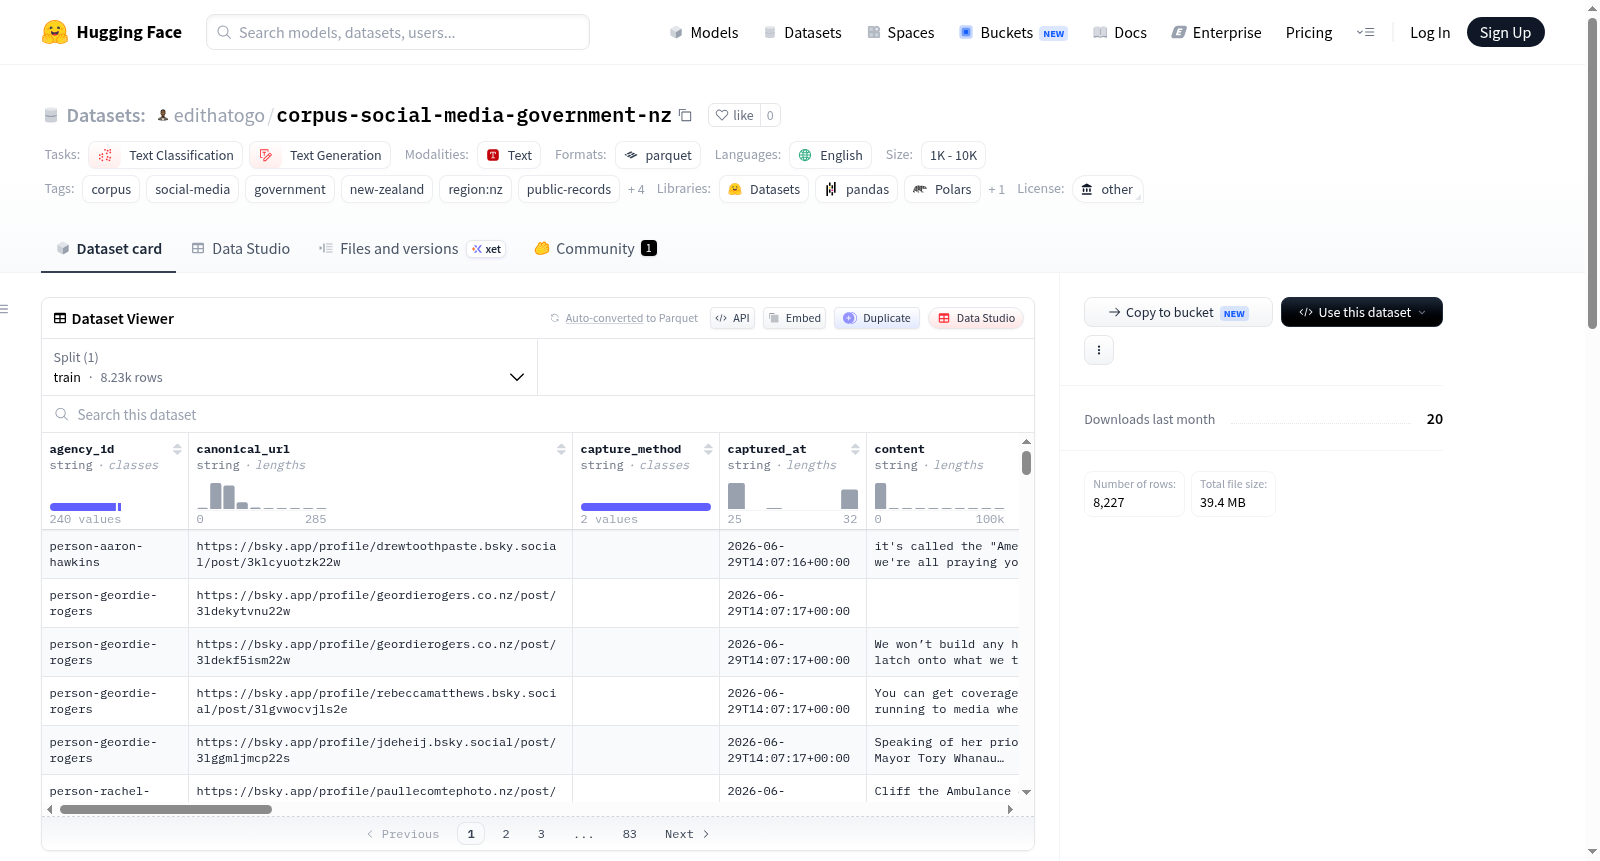
新西兰政府社交媒体语料库/档案是一个规范化的、多来源的公共记录数据集,专门收录新西兰政府机构在社交媒体平台及相关公共网络渠道发布的内容。该数据集旨在为信息发现、来源追溯和上下文证据保留提供结构化数据支持。数据集内容涵盖了Bluesky、X(原Twitter)、YouTube、LinkedIn、RSS订阅、政府网站页面及电子邮件通讯等多种来源的政府公开记录。数据经过规范化处理,每条记录均包含来源平台、来源账户、原始URL、捕获时间戳、发布时间戳、内容哈希值、媒体引用、原始数据路径及提取方法等关键元数据字段。数据以JSON Lines(压缩格式)和Parquet两种格式提供,便于不同场景下的处理与分析。根据统计,数据集包含来自8类来源的共计9,247条记录,其中RSS来源记录最多(3,887条),其次是YouTube(1,821条)和Bluesky(1,587条)。该数据集适用于文本分类、文本生成、公共信息分析、政府传播研究、社交媒体档案学及数字人文等领域的研究与应用。需要注意的是,当前数据收集主要依赖网站、RSS和Bluesky的自动化归档,其他平台(如新闻通讯和电子邮件)的完整收录工作仍在进行中。
The New Zealand Government Social Media Corpus/Archive is a standardized, multi-source public record dataset dedicated to collecting content published by New Zealand government agencies on social media platforms and related public web channels. This dataset aims to provide structured data support for information discovery, source tracing, and contextual evidence preservation. The dataset covers government public records from multiple sources including Bluesky, X (formerly Twitter), YouTube, LinkedIn, RSS feeds, government website pages, and email newsletters. The data has been standardized, with each record containing key metadata fields such as source platform, source account, original URL, capture timestamp, publication timestamp, content hash value, media references, original data path, and extraction method. The data is provided in two formats: JSON Lines (compressed) and Parquet, facilitating processing and analysis in different scenarios. According to statistics, the dataset contains a total of 9,247 records from 8 categories of sources, among which RSS feed records are the most numerous (3,887), followed by YouTube (1,821) and Bluesky (1,587). This dataset is applicable to research and applications in fields such as text classification, text generation, public information analysis, government communication research, social media archival science, and digital humanities. It should be noted that current data collection mainly relies on automated archiving of websites, RSS feeds and Bluesky; the complete collection of records from other platforms (such as newsletters and emails) is still in progress.
数据集概述
数据集名称:New Zealand Government Social Media Corpus/Archive
规范名称:corpus-social-media-government-nz
许可证:其他(other)
任务类别:文本分类、文本生成
语言:英语(en)
标签:语料库、社交媒体、政府、新西兰、区域:新西兰、公共记录、RSS、Bluesky、Threads、YouTube
数据集内容
该数据集包含标准化的新西兰政府社交媒体记录,并保留了RSS及邻近的公共网络来源记录,用于溯源、出处和来源上下文证据。
文件与结构:
normalized_archive.jsonl.gz:来自各源/月分片的组合标准化记录(JSONL格式压缩)normalized_archive.parquet:组合标准化记录(Parquet格式)normalized/:按源/月划分的标准化JSONL分片raw/:标准化前捕获的原始来源载荷corpus_manifest.json:校验和、覆盖计数、日期范围及已知缺口
来源覆盖情况:
- Bluesky:1587条记录
- courtsofnz.govt.nz:11条记录
- 电子邮件:11条记录
- LinkedIn:2条记录
- RSS:3887条记录
- 网页页面:219条记录
- X(Twitter):689条记录
- YouTube:1821条记录
数据出处
记录源自新西兰政府社交媒体及邻近的公共来源页面,保留了以下元数据(如适用):
- 来源平台
- 来源账号
- 来源URL
- 捕获时间戳
- 原始时间戳
- 内容哈希
- 媒体引用
- 原始路径
- 提取方法
已知缺口
- 除网站、RSS和Bluesky之外的平台捕获需要经批准的API、导出或手动导入流程,方可进行自动归档。
- 新闻通讯和电子邮件订阅的接入尚未配置针对性的邮箱/路由设置。
- 原始来源包已包含在Actions构件和完整归档压缩包中;若来源条款要求,可另行添加受限的原始发布渠道。