
遇见数据集

kurakurai/IFEval-FR

收藏
Hugging Face2026-06-16 更新2026-06-21 收录
官方服务:

资源简介:

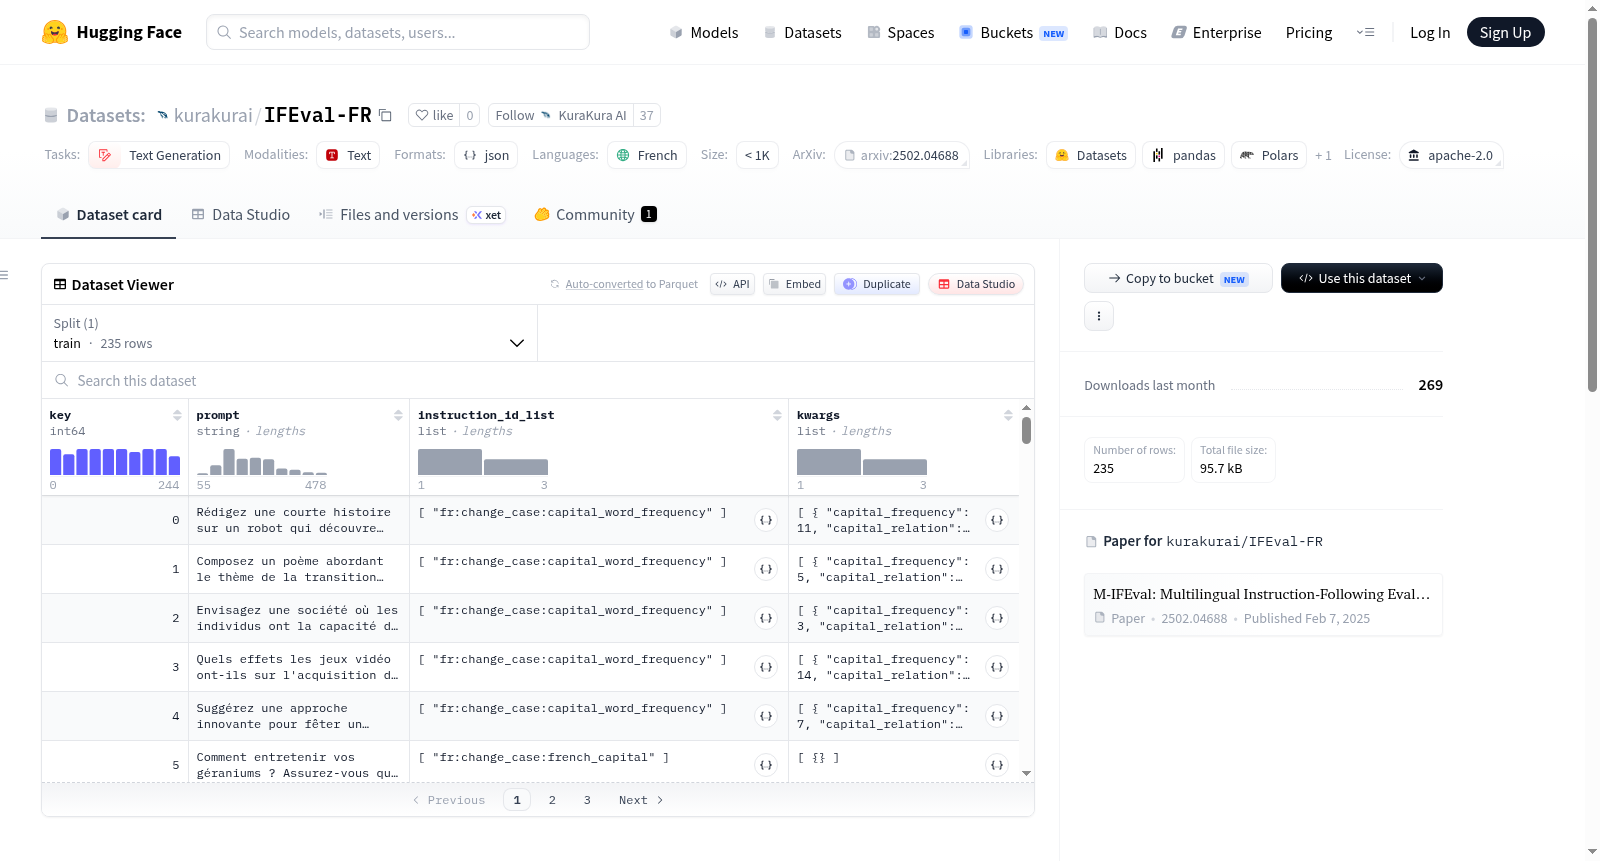
IFEval-FR是M-IFEval指令跟随基准的法语版本,格式与google/IFEval数据集相同。该版本经过Claude Opus 4.8的审查和清理,修复了提示/验证器不匹配、偏移约束、未翻译提示以及语法/格式问题。数据集包含235个提示,仅有一个训练分割,字段包括唯一ID(key)、法语指令(prompt)、可验证指令列表(instruction_id_list,以fr:为前缀)以及每个指令的参数(kwargs)。它用于评估模型在法语环境下的指令跟随能力,适用于文本生成任务,采用Apache-2.0许可证。

IFEval-FR is the French version of the M-IFEval instruction-following benchmark, formatted identically to the google/IFEval dataset. This version has been reviewed and cleaned by Claude Opus 4.8, fixing issues including prompt/validator mismatches, offset constraints, untranslated prompts, and grammatical/formatting problems. The dataset contains 235 prompts, with only a single training split. Its fields include unique ID (key), French instruction (prompt), verifiable instruction list (instruction_id_list, prefixed with fr:), and parameters (kwargs) for each instruction. It is used to evaluate models' instruction-following capabilities in a French-language context, is suitable for text generation tasks, and is released under the Apache-2.0 license.
提供机构:
kurakurai
搜集汇总
数据集介绍
kurakurai/IFEval-FR 数据集图片
构建方式
IFEval-FR 数据集源自多语言指令遵循基准 M-IFEval,是其在法语领域的精细切分。该数据集沿用了 google/IFEval 的标准格式,但经由 Claude Opus 4.8 模型进行了全面审查与清洗,重点修正了提示与验证器之间的不匹配、边界约束的偏移、未翻译的提示以及语法与格式问题,从而确保了数据质量的高度一致性与可靠性。最终构建出包含 235 条提示的法语单训练集,每条数据均具有唯一标识符。
使用方法
使用 IFEval-FR 数据集极为简便,研究者可通过 HuggingFace 的 datasets 库直接加载。仅需一行代码 `ds = load_dataset("kurakurai/IFEval-FR")` 即可获取完整的训练集。数据默认以单训练集形式组织,每条样本包含 key、prompt、instruction_id_list 及 kwargs 四个字段,便于直接用于模型在法语指令遵循任务上的性能评估与对比实验。该数据集采用 Apache-2.0 开源许可协议,允许广泛的研究与商业应用。
背景与挑战
背景概述
IFEval-FR数据集是2025年由Antoine Dussolle、Andrea Cardena Díaz、Shota Sato和Peter Devine等研究人员在M-IFEval项目框架下创建的,旨在填补大型语言模型指令遵循能力评估中法语资源的空白。该数据集源自google/IFEval基准的法国分支,经过Claude Opus 4.8模型的人工审核与清洗,修正了提示与验证器不匹配、边界约束偏移及语法错误等问题,包含235条精心设计的指令提示。作为多语言指令遵循评估的关键组件,IFEval-FR为衡量法语环境下模型对齐能力提供了标准化基准,推动了自然语言处理领域对非英语模型评估的公平性与鲁棒性研究。
当前挑战
IFEval-FR数据集面临的核心挑战在于多语言环境下指令遵循评估的多样性适配问题。在领域问题层面,大型语言模型在非英语语言中常表现不一致,现有基准多聚焦英语,难以全面反映模型对法语语法、文化语境及表达习惯的理解能力;数据集构建过程中,翻译失真、prompt与verifier不匹配、约束条件偏移及格式错误等技术难题凸显,需依赖人工与模型协作进行反复清洗与校对,才能确保评估结果的可靠性与可复现性,这对资源稀缺语言的基准构建提出了更高要求。
常用场景
经典使用场景
IFEval-FR作为M-IFEval多语言指令遵循基准测试的法语子集,其经典使用场景聚焦于评估大语言模型在法语环境下对复杂指令的遵循能力。该数据集包含235条精心构造的法语指令,每条指令均附带可验证的指令标识列表及其参数,为研究者提供了一套标准化的评估框架。通过加载此数据集,研究者能够系统性地检验模型在处理法语自然语言指令时的准确性、完整性与一致性,尤其适用于对比不同模型在法语这一特定语言上的表现差异,从而推动多语言大语言模型评估体系的完善。
解决学术问题
该数据集致力于解决多语言大语言模型评估中法语资源匮乏的核心学术问题。在已有的指令遵循基准如IFEval主要面向英语的背景下,IFEval-FR填补了法语高质量评估数据的空白。它使学术研究者能够量化法语大语言模型在指令解析、参数匹配及约束满足等方面的能力,从而揭示模型在多语言迁移中的潜在缺陷。该数据集的发布推动了跨语言模型泛化能力的研究,为理解语言特异性对指令遵循性能的影响提供了关键工具,对构建真正多语言友好的自然语言处理系统具有重要理论价值和实践意义。
实际应用
在实际应用中,IFEval-FR可被广泛部署于法语自然语言处理产品的质量监控与迭代优化场景。例如,开发法语智能客服系统或语音助手的企业可利用该数据集评估模型对用户复杂法语指令的理解与执行效果,确保系统能准确响应诸如格式转换、内容限制等精细化要求。在法语教育领域,该数据集可用于检验教学辅助机器人的指令遵循一致性。此外,面向法语地区的自动化内容生成工具,如文献摘要或报告撰写软件,也能借此基准测试其输出是否符合预设规则,从而提升产品的可靠性与用户满意度。
数据集最近研究
最新研究方向
随着大型语言模型在多语言场景下的广泛应用,评估模型对复杂指令的遵循能力成为前沿研究焦点。IFEval-FR作为M-IFEval基准的法语分支,通过精心审核与清洗(利用Claude Opus修复提示词与验证器不匹配、边界约束偏差及语法格式问题),为法语指令遵循评估提供了高精度标准化工具。该数据集紧扣多语言NLP领域对可复现、跨语言评估框架的迫切需求,其发布不仅填补了法语细粒度指令测试的空白,更推动了多语言模型在文化敏感性与语言适配性上的深度验证,具有重要的方法论价值与工程参考意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

