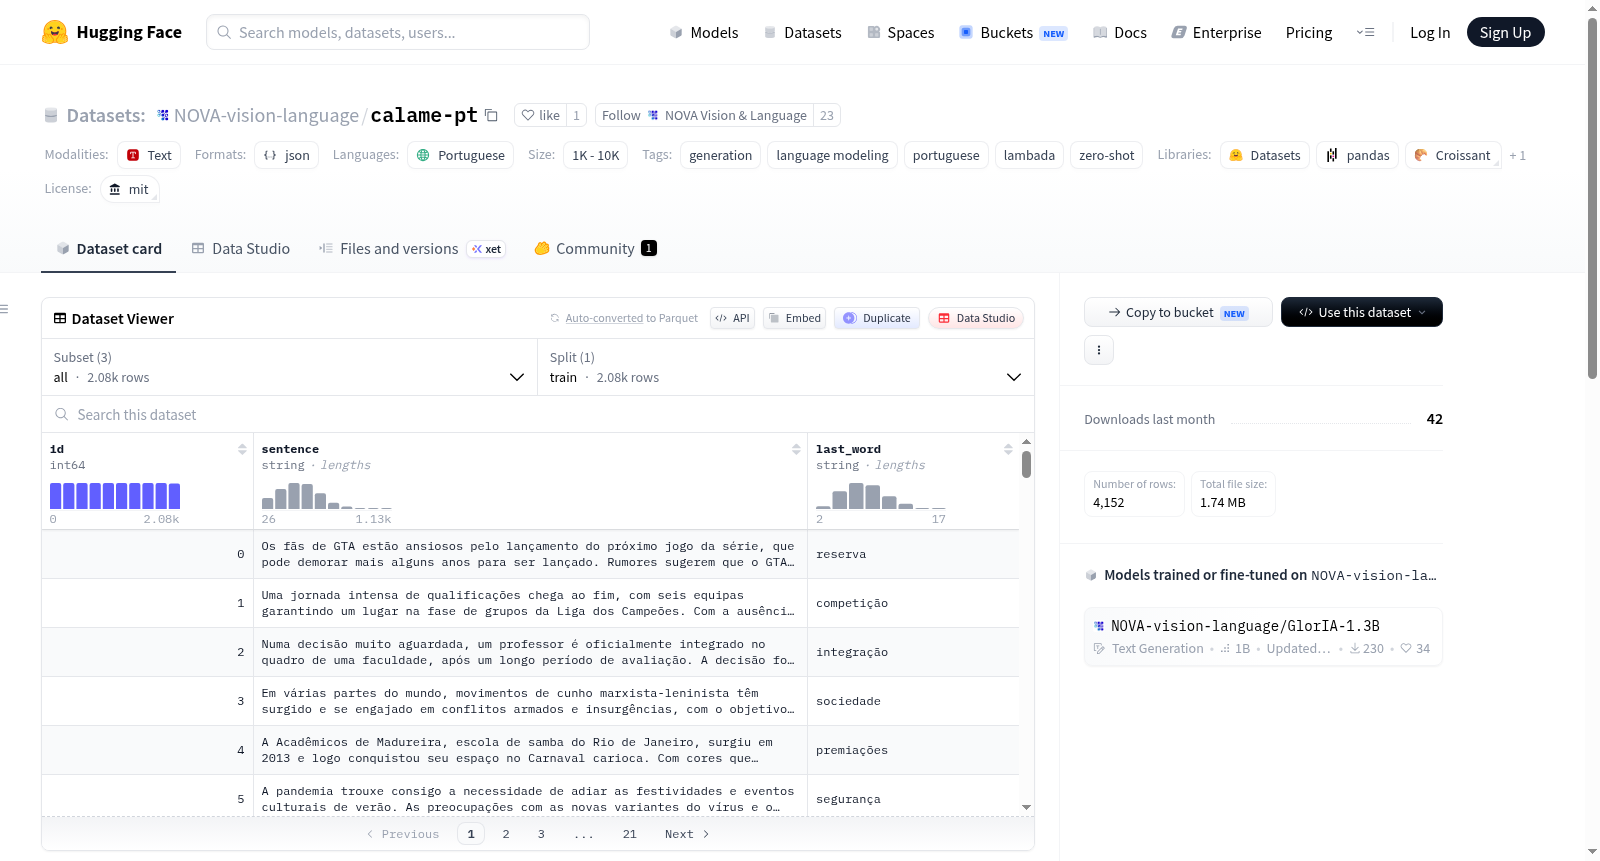
NOVA-vision-language/calame-pt
收藏资源简介:
CALAME-PT是一个葡萄牙语基准测试,由小文本(上下文)及其相应的最后一个单词组成。这些上下文理论上应包含足够的信息,使人类或模型能够猜测其最后一个单词,而不会过于具体或模糊。数据集分为手写集和生成集两部分,手写集包含406个由葡萄牙语母语者手写的样本,生成集包含1670个由GPT-3.5生成并经过人工审查的样本。生成集的样本来自葡萄牙维基百科、OSCAR和Arquivo.pt等数据源,经过GPT-3.5的改写/总结和匿名化处理,并经过人工审查以确保质量。
CALAME-PT is a Portuguese benchmark dataset consisting of short texts (contexts) and their corresponding final words. Theoretically, these contexts contain sufficient information to allow humans or models to guess their final words without being overly specific or ambiguous. The dataset is split into two subsets: a handwritten set and a generated set. The handwritten set includes 406 samples handwritten by native Portuguese speakers. The generated set contains 1,670 samples generated by GPT-3.5 and manually reviewed. Samples in the generated set are sourced from data repositories including Portuguese Wikipedia, OSCAR, and Arquivo.pt, and have undergone rewriting/summarization and anonymization via GPT-3.5, followed by manual review to ensure quality.
CALAME-PT
Context-Aware LAnguage Modeling Evaluation for Portuguese
CALAME-PT 是一个葡萄牙语基准测试,由小段文本(上下文)及其相应的最后一个词组成。这些上下文在理论上应包含足够的信息,使得人类或模型能够猜测其最后一个词,既不过于具体也不过于模糊。
组成
CALAME-PT 由两个“数据集”组成 - 手写和生成。
- 手写集:包含 406 个由葡萄牙语母语者手写的样本;
- 生成集:包含 1670 个由 GPT-3.5 生成的样本,随后提交给人审阅。
自动生成
为了生成生成集的样本,从 3 个后处理数据源中随机抽取文档:葡萄牙语维基百科(PTWIKI)、OSCAR 和 Arquivo.pt。这些数据集对应并使用了 GlorIA 中提到的数据集。随后,GPT-3.5 被提示对每个文档进行重写/总结,并执行实体(人、公司等)的匿名化步骤。
然后,生成的样本被提交给人审阅,进行以下操作:1) 删除不良样本 2) 进行一些重写以确保质量和避免删除整个样本 3) 手动执行匿名化步骤。
如何使用
确保您的 Datasets 包已更新! py from datasets import load_dataset
dataset = load_dataset("NOVA-vision-language/calame-pt", "all") dataset_handwritten_only = load_dataset("NOVA-vision-language/calame-pt", "handwritten") dataset_generated_only = load_dataset("NOVA-vision-language/calame-pt", "generated")