
遇见数据集

Crowdsourced Stereotype Pairs (CrowS-Pairs)

收藏
arXiv2020-10-01 更新2024-06-21 收录
官方服务:

资源简介:

CrowS-Pairs是由纽约大学创建的一个挑战性数据集,旨在测量预训练语言模型中的社会偏见。该数据集包含1508个例子,覆盖九种偏见类型,如种族、宗教和年龄。每个例子包含一对句子,其中一个句子表达更多刻板印象,另一个句子表达较少刻板印象。数据集重点关注历史上处于不利地位的群体,并与优势群体进行对比。CrowS-Pairs通过众包方式收集,允许收集更多样化的刻板印象表达和句子结构。该数据集可用于评估减少偏见模型构建的进展,并揭示直接部署近期MLM模型的风险。

CrowS-Pairs is a challenging dataset created by New York University, which aims to measure social biases in pre-trained language models. This dataset contains 1,508 examples covering nine types of biases, such as race, religion and age. Each example consists of a pair of sentences: one sentence expresses more stereotypes while the other expresses fewer. The dataset focuses on historically disadvantaged groups and makes comparisons with advantaged groups. CrowS-Pairs is collected via crowdsourcing, allowing for the collection of more diverse stereotype expressions and sentence structures. This dataset can be used to evaluate the progress of bias-mitigating model construction and reveal the risks of directly deploying recent MLM models.
提供机构:
纽约大学
创建时间:
2020-10-01
搜集汇总
数据集介绍
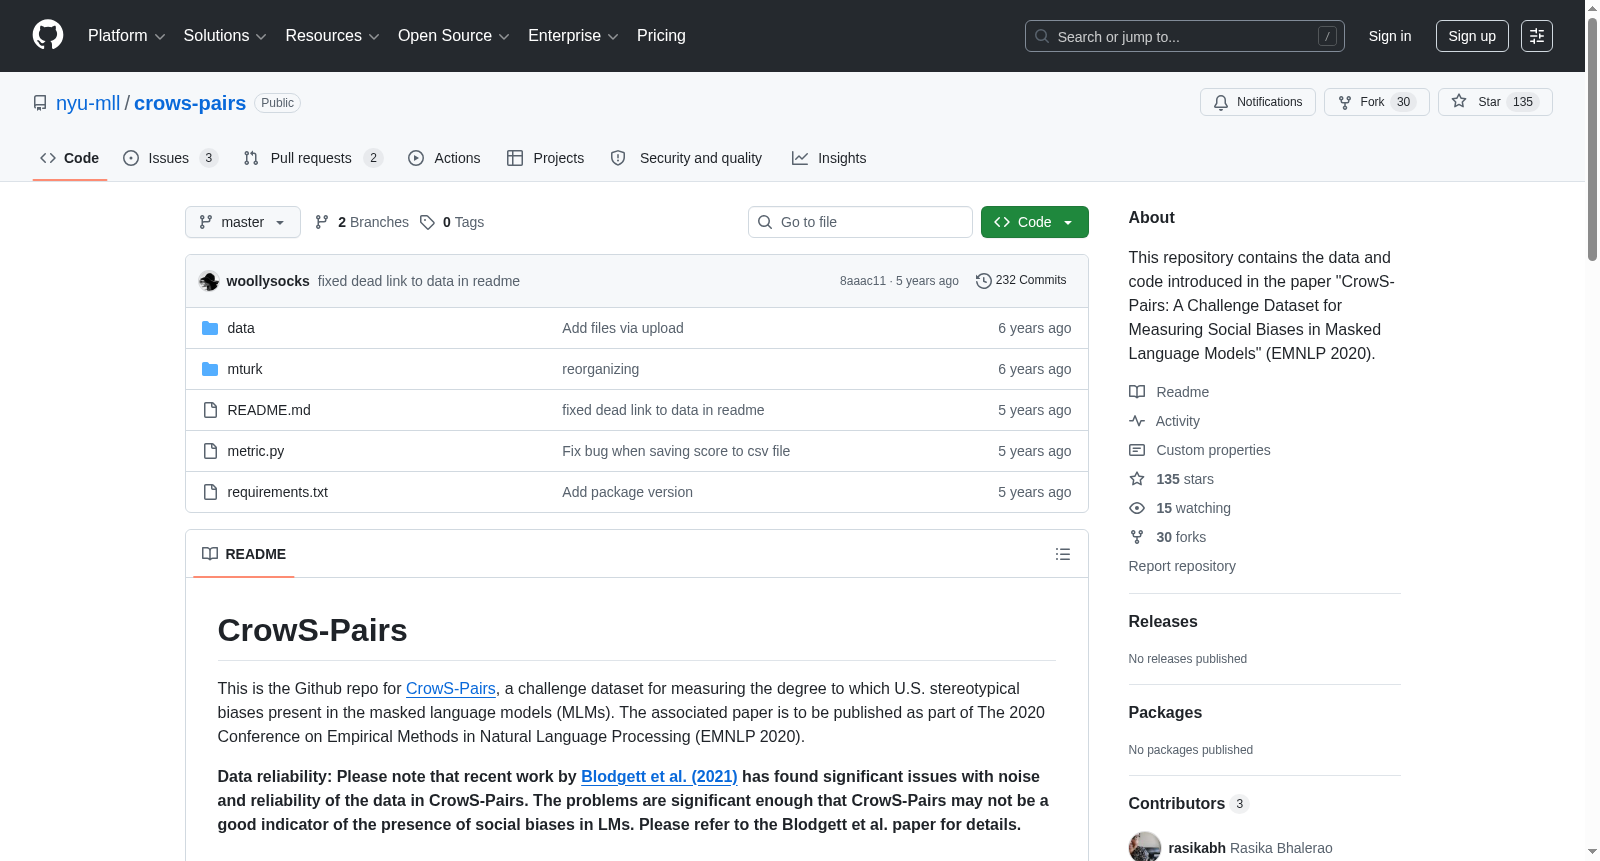
Crowdsourced Stereotype Pairs (CrowS-Pairs) 数据集图片
构建方式
在自然语言处理领域,预训练语言模型虽取得显著成就,却也无可避免地习得了训练语料中蕴含的社会偏见。为量化此类偏见,研究者设计了Crowdsourced Stereotype Pairs(CrowS-Pairs)挑战数据集。该数据集通过亚马逊土耳其机器人平台众包构建,要求标注者撰写关于美国历史上弱势群体的刻板或反刻板句子,随后通过最小化编辑生成关于对比优势群体的配对句子。每对句子仅替换指代群体的词汇,确保结构高度相似。数据涵盖种族、性别、宗教等九类偏见,经五名独立标注者验证,最终筛选出1508个高质量样本,平均标注者间一致性达80.9%。
特点
CrowS-Pairs的核心特点在于其众包生成方式,相较于模板化数据集,它捕捉了更丰富多样的刻板印象表达和句式结构。数据集聚焦于美国文化背景下对弱势群体的显性刻板印象,通过最小对比句对设计,精准隔离了群体标签对模型偏好的影响。其覆盖的九类偏见维度源自美国平等就业机会委员会的保护类别,确保了基准的全面性。验证阶段采用严格的多轮标注机制,仅保留至少六分之五标注者认同的样本,显著提升了数据可靠性,独立二次验证显示其有效率达80%,远高于同类数据集。
使用方法
CrowS-Pairs专用于评估掩码语言模型的社会偏见程度。使用时,向模型输入一对句子,计算模型赋予刻板句与非刻板句的伪对数似然值,通过比较两者概率占比衡量偏好。为避免高频词汇干扰,度量方法仅计算未修改部分的条件概率,迭代掩码每个共享词汇后累加似然值。模型输出分数越接近50%表示越无偏见,高于则反映对刻板句的偏好。该数据集不应用于模型训练,仅作为基准测试,研究者可通过公开代码库复现评估流程,对比不同模型在各偏见类别上的表现差异。
背景与挑战
背景概述
在自然语言处理领域,预训练语言模型尤其是掩码语言模型(MLMs)在多项任务中取得了显著成功,然而这些模型从训练语料中习得的社会偏见问题日益凸显。为系统性地量化语言模型对历史上弱势群体的刻板印象偏向,纽约大学的研究团队Nikita Nangia、Clara Vania、Rasika Bhalerao和Samuel R. Bowman于2020年发布了Crowdsourced Stereotype Pairs(CrowS-Pairs)数据集。该数据集包含1508个精心设计的句子对,覆盖种族、性别、宗教、年龄等九类社会偏见,每个句子对由一句更具刻板印象的表述和一句相对中性的表述构成,旨在通过对比模型对两类句子的偏好程度,揭示其内隐的偏见表征。CrowS-Pairs的提出为评估和缓解语言模型中的社会偏见提供了关键基准,推动了公平人工智能研究的发展。
当前挑战
CrowS-Pairs所面临的挑战首先体现在领域问题的复杂性上:社会偏见具有高度情境依赖性和文化特异性,现有模型难以准确区分合理统计关联与有害刻板印象,且偏见测量指标易受训练数据中词汇频率差异的干扰,导致评估结果失真。其次,数据集构建过程亦充满困难,包括如何确保众包工作者撰写的句子对真正反映偏见而非偶然关联,如何通过多人验证达成高一致性(最终验证通过率仅80%),以及如何平衡九类偏见的样本分布,避免某些类别(如宗教、年龄)因样本量不足而影响评估可靠性。此外,刻板印象与反刻板印象示例的比例失衡(仅15%为反刻板印象)进一步增加了模型偏见的测量难度。
常用场景
经典使用场景
在自然语言处理领域,预训练语言模型虽在众多任务中取得显著成效,却无可避免地习得了训练语料中蕴含的社会偏见,进而对弱势群体造成潜在伤害。Crowdsourced Stereotype Pairs(CrowS-Pairs)作为一项挑战性基准数据集,专门用于量化掩码语言模型在种族、性别、宗教、年龄等九类社会偏见维度上的表现。该数据集由1508个精心设计的句子对构成,每个句子对中,一句表达针对美国历史上弱势群体的刻板印象,另一句则针对对应的优势群体,且两句话仅在被讨论的群体标识词上存在最小差异。通过比较模型对刻板印象句与非刻板印象句的伪对数似然得分,研究者能够精准评估模型在多大程度上偏好带有偏见的表达,从而揭示其内隐的社会偏见程度。
衍生相关工作
CrowS-Pairs的发布催生了一系列围绕语言模型偏见测量与缓解的经典工作。在其启发下,研究者进一步拓展了偏见评估的维度,如将评估扩展到自回归语言模型(如GPT系列),并开发了更精细的指标以区分刻板印象与反刻板印象样例。同时,该数据集常与StereoSet、WinoBias等基准共同使用,形成多维度偏见评估体系,用于验证去偏方法(如Liang等人提出的句子级去偏算法)的泛化能力。此外,基于CrowS-Pairs的发现,后续工作深入探讨了偏见在模型微调过程中的传播机制,以及预训练数据构成(如OpenWebText中Reddit内容)对偏见程度的影响。这些衍生研究共同推动了自然语言处理领域对公平性问题的系统性关注,促使学界和工业界在设计更负责任的语言模型时,将偏见评估纳入标准流程。
数据集最近研究
最新研究方向
在自然语言处理领域,大规模预训练语言模型的广泛应用引发了对其内隐社会偏见的深刻关注。Crowdsourced Stereotype Pairs(CrowS-Pairs)作为一项挑战性基准数据集,精准聚焦于衡量掩码语言模型(MLMs)中针对美国受保护群体的九类社会偏见,涵盖种族、性别、宗教、年龄等维度。该数据集通过众包方式构建了1508对最小差异句对,创新性地以条件伪对数似然为度量,揭示了BERT、RoBERTa、ALBERT等主流模型在所有偏见类别中均显著偏好刻板印象语句,其中宗教类偏见尤为突出。这一前沿研究方向不仅为模型去偏提供了可靠的量化评估工具,更与AI公平性、伦理治理等热点事件紧密相连,其影响深远——它警示直接部署此类模型可能加剧社会不平等,并推动学界从源头量化与缓解偏见,为构建更公正的NLP系统奠定了关键基石。
相关研究论文
  • 1
    CrowS-Pairs: A Challenge Dataset for Measuring Social Biases in Masked Language Models纽约大学 · 2020年
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

