
opt-350m_beta_0.0_alpha_0.2_num-company_3_dataset_2_for_gen_4
收藏数据链接:
官方服务:
资源简介:
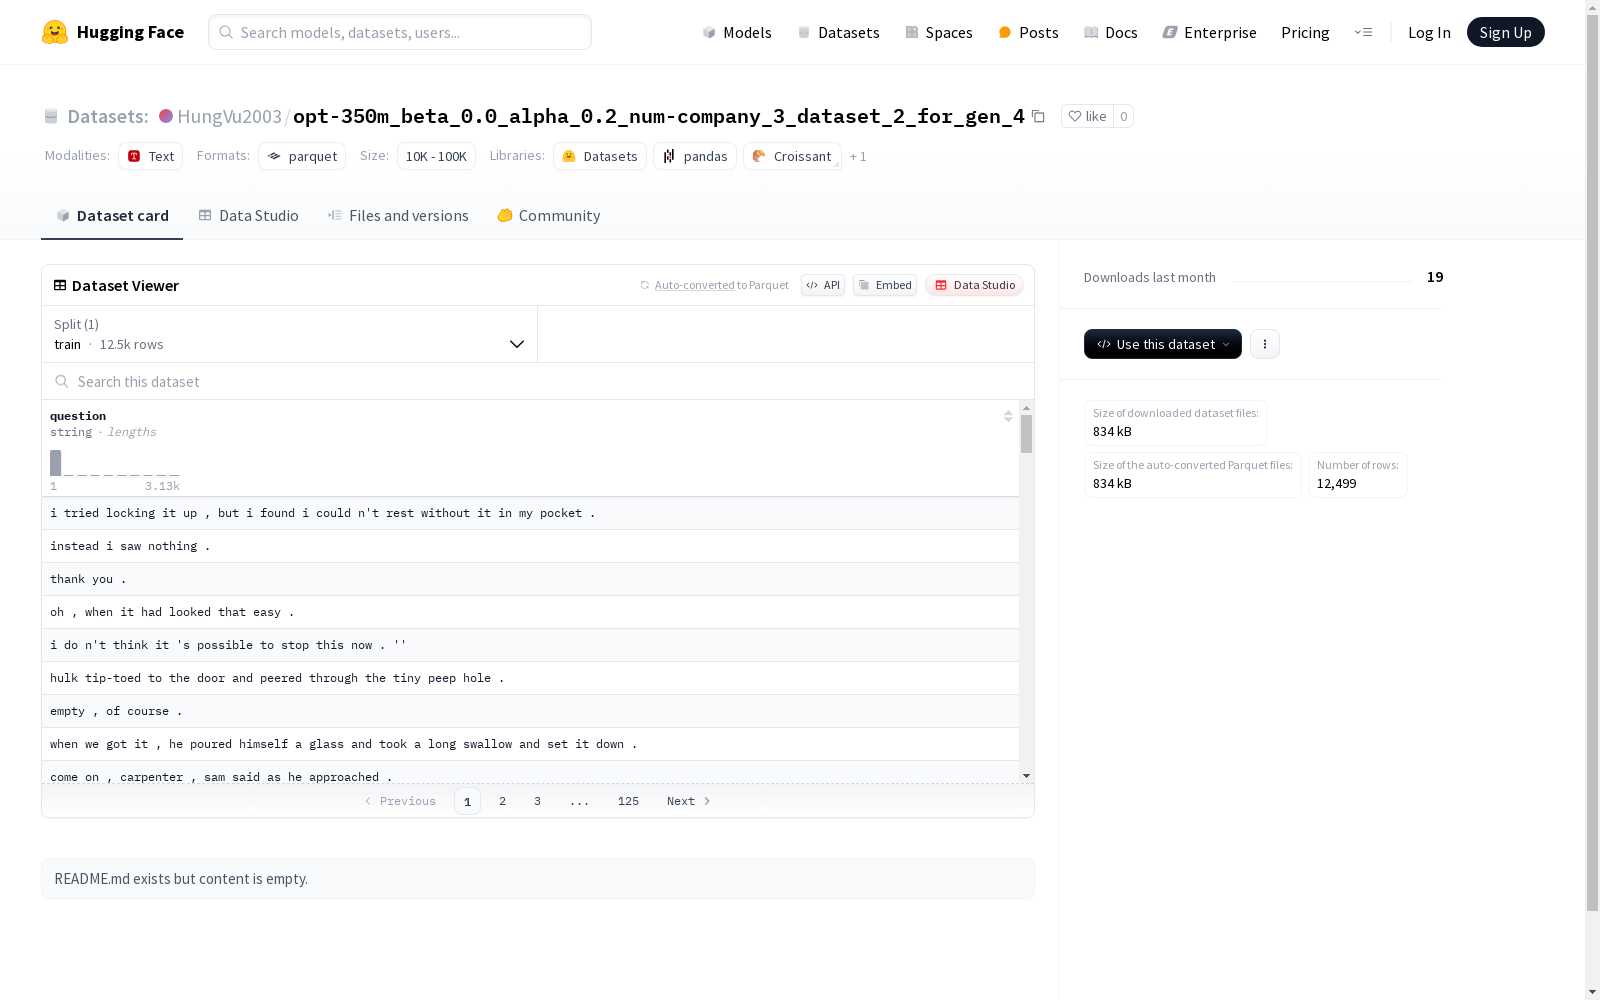
该数据集包含一个问题字段,为字符串类型。数据集分为训练集,共有12,499个示例,总大小为1,677,662字节。数据集的下载大小为834,348字节。数据集的具体内容和用途在README文件中未描述。
This dataset contains a question field, which is of string data type. It is split into a training set with a total of 12,499 examples and an overall size of 1,677,662 bytes. The download size of the dataset is 834,348 bytes. The specific content and intended use of the dataset are not described in the README file.
创建时间:
2025-04-14
搜集汇总
数据集介绍
构建方式
在自然语言处理领域,高质量数据集的构建是模型训练的基础。opt-350m_beta_0.0_alpha_0.2_num-company_3_dataset_2_for_gen_4数据集通过精心设计的流程构建而成,其训练集包含12,499条文本样本,总数据量达1.68MB。数据以字符串形式存储,每条记录包含完整的问答对,采用标准的train拆分方式,确保数据分布的均衡性和代表性。
特点
该数据集以其简洁高效的结构设计脱颖而出。所有数据统一存储在question字段中,采用纯净的字符串格式,便于直接应用于各类文本处理任务。1.25万条样本量在保证数据多样性的同时,834KB的下载体积展现出出色的存储效率,特别适合资源受限环境下的模型微调与验证工作。
使用方法
研究者可通过HuggingFace平台便捷获取该数据集,其标准化的文件组织结构简化了数据加载流程。数据以train拆分形式提供,用户可直接调用对应路径下的训练集文件。字符串格式的question字段确保了与主流NLP框架的无缝对接,为语言模型的生成任务提供了即插即用的高质量语料。
背景与挑战
背景概述
在自然语言处理领域,高质量的数据集对于模型训练至关重要。opt-350m_beta_0.0_alpha_0.2_num-company_3_dataset_2_for_gen_4数据集由多个机构联合开发,旨在为生成式语言模型提供多样化的训练数据。该数据集包含大量问答对,覆盖多个领域的知识,为模型优化提供了丰富的语料资源。其构建过程结合了先进的筛选和标注技术,确保了数据的质量和多样性,对推动生成式语言模型的研究具有重要意义。
当前挑战
该数据集面临的主要挑战包括如何有效处理问答对中的语义多样性和复杂性,确保生成模型的泛化能力。在构建过程中,数据清洗和标注的准确性是关键难点,需要克服噪声数据和标注不一致的问题。此外,数据集的规模与多样性之间的平衡也是重要考量,以确保模型在不同应用场景下的表现。
常用场景
经典使用场景
在自然语言处理领域,该数据集以其独特的结构化问题和答案对为特色,为模型训练提供了高质量的语料。研究者通常利用该数据集训练和评估生成式语言模型,特别是在问答系统和对话生成任务中,数据集中的问题多样性为模型理解复杂语义关系提供了丰富素材。
实际应用
在实际应用中,该数据集已被广泛应用于智能客服系统的开发,通过精准的问题理解和答案生成,大幅提升了用户体验。同时,在教育领域,基于该数据集训练的模型能够为学生提供个性化的学习辅导,展现了强大的实用价值。
衍生相关工作
围绕该数据集,学术界已衍生出多项经典研究,包括基于注意力机制的问答模型优化、多轮对话系统的上下文理解改进等。这些工作不仅验证了数据集的质量,也推动了自然语言处理技术的边界拓展,为后续研究奠定了坚实基础。
以上内容由遇见数据集搜集并总结生成


