遇见数据集

Long-Horizon Terminal-Bench (LHTB)

收藏
github2026-07-16 更新2026-07-17 收录
数据链接:
官方服务:

资源简介:

Long-Horizon Terminal-Bench (LHTB) 是一个包含46个任务的基准测试,用于测量LLM代理在容器化终端中经过数百步后维持有用工作的能力。与短期编码基准测试不同,LHTB将代理置于有状态环境中,并通过隐藏的、从工件重建的验证器进行评分,自我报告的进度不计入成绩。任务涵盖交互式游戏与谜题、多模态分析、软件/逆向工程、科学计算、地球与能源系统、安全与性能、研究复现以及专业APEX风格工作流程。

Long-Horizon Terminal-Bench (LHTB) is a benchmark comprising 46 tasks aimed at evaluating the ability of LLM agents to maintain productive operational workflows over hundreds of steps within a containerized terminal environment. Unlike short-term coding benchmarks, LHTB deploys agents in a stateful environment, and employs hidden, artifact-reconstructed validators for scoring, excluding self-reported progress from grading considerations. The covered tasks span interactive games and puzzles, multimodal analysis, software and reverse engineering, scientific computing, earth and energy systems, security and performance optimization, research reproduction, as well as professional APEX-style workflows.

创建时间:
2026-07-08
原始信息汇总

数据集概述

  • 数据集名称: Long-Horizon Terminal-Bench (LHTB)
  • 数据集地址: https://github.com/zli12321/LHTB
  • 数据集类型: 多任务基准测试(46个任务)
  • 核心用途: 衡量LLM智能体在容器化终端环境中执行长时任务(数百步)的能力。

任务与评估

  • 任务数量: 46个任务,涵盖8个类别:
    • 交互式游戏与谜题(8个)
    • 多模态与成像分析(6个)
    • 软件与逆向工程(6个)
    • 科学计算与仿真(6个)
    • 地球、气候与能源(6个)
    • 系统、性能与安全(5个)
    • 研究复现与机器学习(5个)
    • APEX专业工作流(4个)
  • 评估方法: 使用隐藏的、基于工件重建的验证器进行评分,不支持智能体自我报告进度。每个任务预算为90分钟。
  • 评估环境: 使用 Harbor 评估框架,基于 Terminus-2 测试平台。

结果与发现

  • 模型表现(2026年7月快照,21个前沿模型):
    • 最佳模型(Grok 4.5)在严格成功标准下仅解决约28%的任务(13/46)。
    • 中位数任务未被任何模型解决,表明基准测试远未饱和。
    • 约55%的智能体-任务运行奖励低于0.25,智能体经常陷入循环、提前退出或预算耗尽。
  • 成本与性能:
    • 能力与价格不直接相关。例如,Grok 4.5(约$11/任务)排名第一,而Claude Fable 5(约$73/任务)排名第四。
    • 低成本模型如 MiniMax M3($6/任务)和 Hy3($2.47/任务)性能可媲美高价模型。

数据集结构

  • 仓库布局:
    • tasks/: 包含46个Harbor任务定义。
    • configs/examples/: 示例Harbor YAML配置文件。
    • 每个任务遵循标准5文件结构:task.toml(元数据)、instruction.md(智能体提示)、environment/(Dockerfile+资源)、tests/(隐藏验证器)、solution/(参考解决方案)。

使用方式

  • 前提条件: 安装Harbor(uv tool install harborpip install harbor)并运行Docker。
  • 快速开始:
    1. 克隆仓库并拉取Git LFS文件。
    2. 使用 harbor run -c configs/examples/oracle_smoke.yaml 进行测试。
    3. 设置API密钥(通过环境变量,如 OPENAI_API_KEY)并运行智能体。

相关资源

  • 博客: https://zli12321.github.io/LHTB/
  • 排行榜: https://zli12321.github.io/LHTB/leaderboard.html
  • 论文: https://arxiv.org/abs/2607.08964
  • Hugging Face数据集: https://huggingface.co/datasets/IntelligenceLab/Long-Horizon-Terminal-Bench
  • 许可证: Apache License 2.0
搜集汇总
数据集介绍
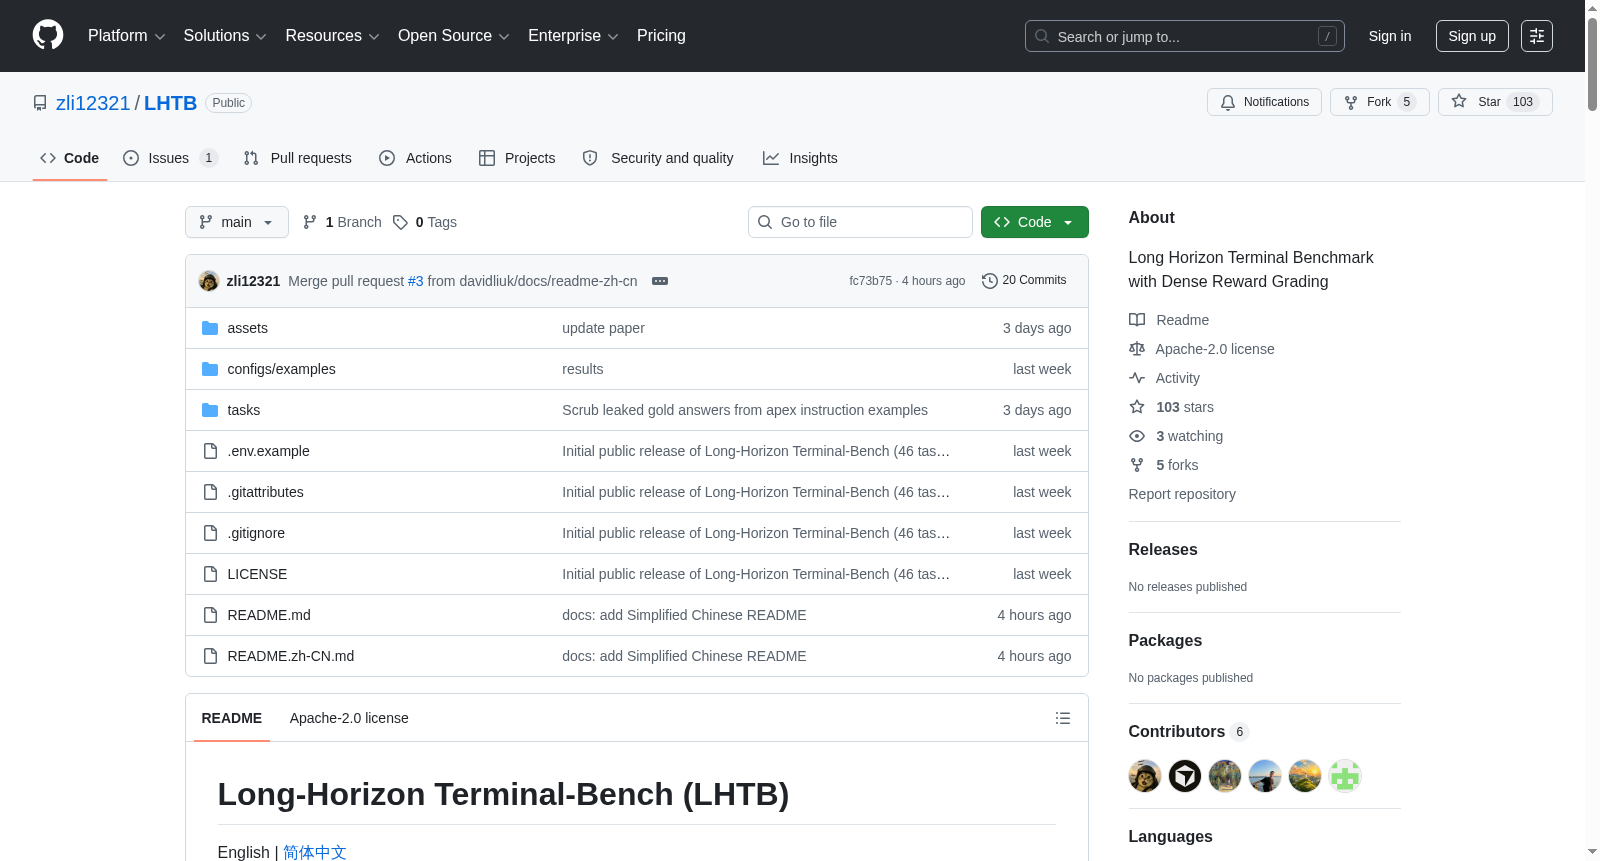
Long-Horizon Terminal-Bench (LHTB) 数据集图片
构建方式
在语言模型智能体评估领域,现有基准多聚焦于短程任务,难以衡量模型在数百步长交互中的持久工作能力。Long-Horizon Terminal-Bench (LHTB) 应运而生,是一个包含46项任务的基准测试集。该数据集基于容器化终端环境构建,每个任务遵循统一的Harbor评估框架的5文件布局,包括元数据描述文件task.toml、面向智能体的指令文件instruction.md、包含Dockerfile及资源的environment目录、隐藏验证器tests目录以及参考解决方案solution目录。任务通过隐藏的、从工件重建的验证器进行评分,智能体自主报告进度不计入成绩,确保评估的客观性与严谨性。
特点
LHTB数据集的核心特点在于其极长的任务跨度与高难度挑战。任务覆盖交互式游戏与谜题、多模态分析、软件与逆向工程、科学计算、地球与能源系统、安全与性能、研究复现以及专业APEX工作流等八大类别,共计46项。评估结果显示,即使最先进的模型在严格成功标准下也仅能解决约28%的任务,而中位数任务未被任何模型攻克,表明基准远未饱和。此外,任务平均花费与模型能力并不成正比,部分低价模型展现了与高价模型相当的竞争力,凸显了该基准在评估智能体经济性与效能平衡方面的独特价值。
使用方法
使用LHTB基准需要先安装Harbor评估工具与Docker环境。用户通过克隆GitHub仓库获取全部任务定义,对于超过100MB的大型文件需启用Git LFS拉取。配置模型API密钥应通过环境变量注入而非直接写入YAML文件,以保障安全。评估流程从使用Oracle智能体进行烟雾测试开始,验证环境配置正确性,随后可通过示例配置文件在少量任务上运行指定模型,最后使用完整基准配置文件进行全部46项任务的全面评估。运行结果将自动保存至本地jobs目录,便于后续分析与排名提交。
背景与挑战
背景概述
Long-Horizon Terminal-Bench (LHTB) 是由 Zongxia Li 等研究者于2026年创建的一项面向大语言模型智能体的长时域终端任务基准测试。该数据集由46项任务构成,涵盖交互式游戏、多模态分析、软件逆向工程、科学计算及地球能源系统等领域,旨在评估智能体在数百步交互中持续完成复杂终端操作的能力。LHTB 引入了隐藏的基于工件重建的验证器,避免依赖智能体自我报告,从而提供更严谨的评判标准。其论文发表于 arXiv,并配有实时排行榜,已成为衡量长时域终端任务中智能体性能的重要基准。
当前挑战
LHTB 解决的核心挑战是现有短视任务基准(如单轮代码生成)无法反映智能体在真实持久化环境中的长期规划与容错能力。构建过程中面临三大挑战:1) 设计覆盖多领域的46个任务,确保状态依赖性与环境复杂性;2) 开发隐蔽且鲁棒的验证器,能够从智能体生成的工件中重建预期结果以计算奖励分数;3) 在统一评估框架 Harbor 下设定90分钟预算,模拟实际部署中的资源约束。即使最先进的 Grok 4.5 模型也仅解决约28%的任务,中位数任务未被任何模型攻克,凸显该基准的极高难度与未被充分探索的智能体能力瓶颈。
常用场景
经典使用场景
在长时程任务执行能力的评估领域,LHTB为研究者提供了一个极具挑战性的基准平台。该数据集包含46项任务,要求智能体在容器化终端环境中,面对交互式游戏与谜题、多模态分析、软件逆向工程、科学计算、地球与能源系统、安全与性能优化、研究复现以及专业APEX工作流等多样化场景,执行数百步的持续性工作。每个任务均采用隐式且可重建于工件的验证器进行评分,有效规避了智能体自述进展的不可靠性。这使得LHTB成为衡量大语言模型智能体在长时间跨度下维持有效工作能力的权威标准,尤其适用于评估模型在复杂、多步骤任务中的规划与执行韧性。
衍生相关工作
LHTB的诞生并非孤立存在,它与先前的Terminal-Bench及Terminal-Bench 2.0构成了一个逐步演进的研究链条,共同推动了对终端智能体评估的标准化。该数据集依托于Harbor评测框架实施统一评估,这一联合生态已催生了一系列相关工作,包括对多模型在统一预算与时间限制下的横向比较研究。此外,LHTB的发布配套了在线排行榜与详尽的分析博客,激励了后续针对长时程任务优化的算法工作,如记忆增强型代理、分层规划策略与自我纠错机制的探索。这些衍生研究不仅验证了LHTB作为挑战性基准的有效性,也使其成为了一个汇聚前沿智能体技术创新的核心试验场。
数据集最近研究
最新研究方向
Long-Horizon Terminal-Bench (LHTB) 的研究方向聚焦于评估大型语言模型(LLM)在长时间跨度、高复杂度终端任务中的持续推理与执行能力。该基准测试包含46项任务,涵盖交互式游戏、多模态分析、软件逆向工程、科学计算及专业工作流等领域,强调在数百步的密集交互过程中,代理需依赖隐藏的、基于重构物的验证器进行评分,而非自我报告进度。当前前沿研究显示,即使最先进的模型(如Grok 4.5)在严格成功率标准下仅能解决约28%的任务,且中位任务未被任何模型攻克,揭示了现有LLM在长期任务规划与执行上的显著短板。LHTB的发布推动了对代理持久性、资源效率与稳健性的深入探索,其成本与性能的非关联性(如MiniMax M3以较低成本取得竞争性结果)也引发了对模型效率优化的新关注,为未来LLM在真实世界长时应用场景的评估与改进提供了关键基准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务