遇见数据集

j-chim/pii-pile-chunk3-150000-200000-tagged

收藏
Hugging Face2023-01-21 更新2024-03-04 收录
官方服务:

资源简介:

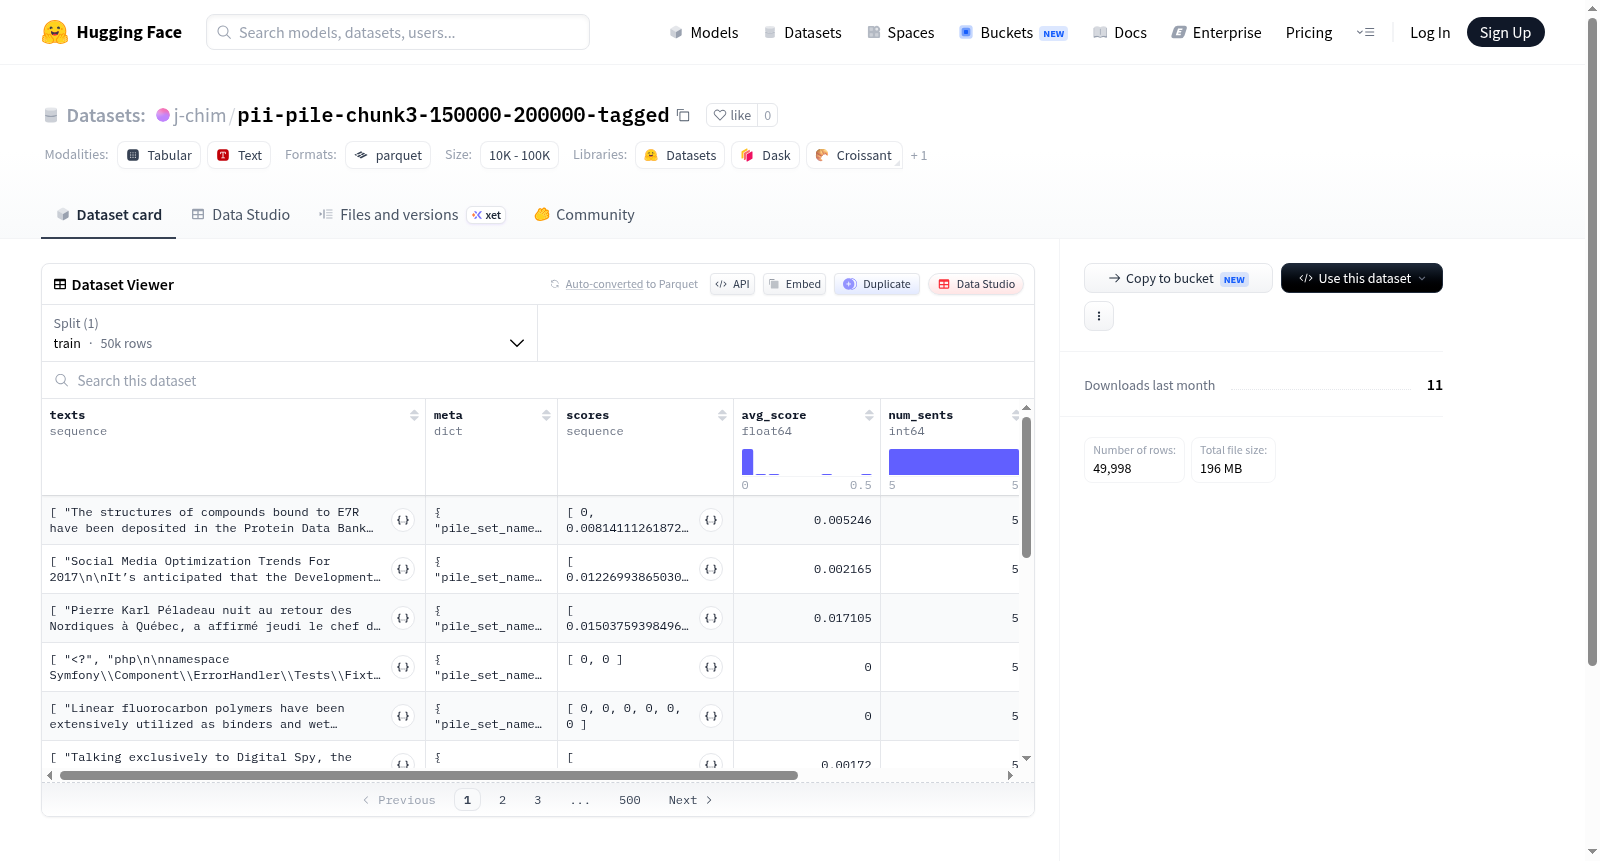
--- dataset_info: features: - name: texts sequence: string - name: meta struct: - name: pile_set_name dtype: string - name: scores sequence: float64 - name: avg_score dtype: float64 - name: num_sents dtype: int64 - name: tagged_pii_results list: - name: analysis_explanation dtype: 'null' - name: end dtype: int64 - name: entity_type dtype: string - name: recognition_metadata struct: - name: recognizer_identifier dtype: string - name: recognizer_name dtype: string - name: score dtype: float64 - name: start dtype: int64 splits: - name: train num_bytes: 512476526 num_examples: 49998 download_size: 196006381 dataset_size: 512476526 --- # Dataset Card for "pii-pile-chunk3-150000-200000-tagged" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

## 数据集信息 ### 特征字段 1. texts:字符串序列类型 2. meta:结构体类型,包含子字段`pile_set_name`(字符串类型,标识所属Pile语料子集) 3. scores:双精度浮点数(float64)序列类型 4. avg_score:双精度浮点数(float64)类型,对应平均得分 5. num_sents:64位整数(int64)类型,统计句子总数量 6. tagged_pii_results:列表类型,列表元素为包含以下字段的结构体: - analysis_explanation:空值类型,分析解释字段 - end:64位整数类型,实体结束位置 - entity_type:字符串类型,实体类别 - recognition_metadata:结构体类型,包含`recognizer_identifier`(识别器标识符,字符串类型)与`recognizer_name`(识别器名称,字符串类型) - score:双精度浮点数类型,实体识别置信得分 - start:64位整数类型,实体起始位置 ### 数据集划分 - train(训练集):字节大小为512476526,共包含49998个样本 - 下载大小:196006381 - 数据集总大小:512476526 # "pii-pile-chunk3-150000-200000-tagged"数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
j-chim
原始信息汇总

数据集概述

数据集名称

  • 名称: pii-pile-chunk3-150000-200000-tagged

数据集特征

  • texts: 字符串序列
  • meta: 结构化数据
    • pile_set_name: 字符串类型
  • scores: 浮点数序列(float64)
  • avg_score: 浮点数类型(float64)
  • num_sents: 整数类型(int64)
  • tagged_pii_results: 列表
    • analysis_explanation: 空值(null)
    • end: 整数类型(int64)
    • entity_type: 字符串类型
    • recognition_metadata: 结构化数据
      • recognizer_identifier: 字符串类型
      • recognizer_name: 字符串类型
    • score: 浮点数类型(float64)
    • start: 整数类型(int64)

数据集分割

  • train:
    • num_bytes: 512476526
    • num_examples: 49998

数据集大小

  • 下载大小: 196006381
  • 数据集大小: 512476526
搜集汇总
数据集介绍
j-chim/pii-pile-chunk3-150000-200000-tagged 数据集图片
构建方式
在自然语言处理与隐私保护交叉领域,j-chim/pii-pile-chunk3-150000-200000-tagged数据集的构建基于大规模文本语料库Pile的特定片段(chunk3,索引范围150000至200000)。通过引入自动化识别管道,对原始文本中的个人身份信息(PII)进行逐句标注,生成包含实体类型、起止位置及置信度分数的结构化标签。每条数据保留原始文本、来源元数据(pile_set_name)、句子级评分及统计信息(如句子数量与平均分),形成多层级、可追溯的标注体系。数据集共包含约5万条训练样本,总大小约512MB,经压缩后下载量约196MB,兼顾了数据丰富性与传输效率。
特点
该数据集的核心特色在于其精细化的隐私信息标注机制。每条记录不仅标注了实体类型(如姓名、地址等),还提供了识别器的来源标识与名称,以及每个实体的起始位置和置信度分数,便于研究者量化分析识别可靠性。同时,数据集保留了原始文本的句子级评分(scores)与平均分(avg_score),为评估文本隐私风险提供了多维度视角。此外,元数据中的pile_set_name字段允许溯源至原始语料来源,增强了数据可解释性。这种融合文本内容、统计特征与隐私标签的设计,使其成为训练与评测PII检测模型的理想资源。
使用方法
使用该数据集时,研究者可通过HuggingFace Datasets库直接加载,利用train分片进行模型训练或评估。每条样本的texts字段提供原始文本序列,tagged_pii_results字段则包含实体标注列表,可提取entity_type、start、end及score等信息用于构建监督学习任务。例如,可设计序列标注模型,以文本为输入,以实体位置与类型为输出。同时,scores和avg_score可用于加权训练或过滤低质量样本。建议将数据集划分为训练与验证子集,结合交叉验证优化隐私识别性能。注意,数据集已预先处理,无需额外清洗,但使用时应遵守隐私保护法规,避免误用标注信息。
背景与挑战
背景概述
在自然语言处理领域,大规模文本语料库的构建与隐私保护之间的张力日益凸显。j-chim/pii-pile-chunk3-150000-200000-tagged数据集由研究人员于近年创建,旨在应对The Pile语料库中可能存在的个人可识别信息(PII)泄露问题。该数据集通过对The Pile中第150,000至200,000个文本块进行细粒度的PII标注,为隐私安全研究提供了关键资源。其核心研究问题聚焦于如何高效识别并标记语料中的敏感实体(如姓名、地址等),以推动数据脱敏技术的发展。该数据集的影响力体现在为模型训练中的隐私合规评估提供了基准,并促进了学术界与工业界对数据伦理的深入探讨。
当前挑战
该数据集面临的核心挑战包括:首先,所解决的领域问题在于大规模语料中PII的自动识别精度不足,现有模型常因上下文多样性或实体变体导致漏检与误检,亟需高质量标注数据以提升泛化能力。其次,构建过程中遭遇多重困难:一是标注一致性难以保证,不同标注者对PII边界的界定存在主观差异;二是处理The Pile这类海量数据时,计算资源消耗巨大,需平衡标注效率与成本;三是隐私法规(如GDPR)的合规要求增加了数据处理的复杂性,需确保标注过程不引入新的泄露风险。这些挑战共同制约了隐私安全数据集的可扩展性与实用性。
常用场景
经典使用场景
该数据集源自The Pile语料库的特定切片,专为个人信息识别与脱敏研究而设计。其核心应用在于训练和评估基于序列标注的命名实体识别模型,尤其聚焦于个人身份信息(PII)的精准定位与分类。通过提供细粒度的实体类型、位置偏移及置信度评分,该数据集成为构建隐私保护模型的标准基准,广泛应用于文本中姓名、地址、证件号等敏感信息的自动化检测与标注任务。
解决学术问题
该数据集有效解决了大规模语料中隐私泄露风险量化的学术难题。传统研究多依赖人工标注或规则方法,难以应对真实文本中PII的复杂变体与上下文歧义。此数据集通过系统化标注与结构化元数据,为研究者提供了可复现的评估框架,推动了对PII识别精度的系统性提升,并促进了隐私保护领域从启发式方法向数据驱动范式的转型,对理解语言模型中的隐私边界具有里程碑意义。
衍生相关工作
基于该数据集,衍生出多项经典工作:如Presidio框架的扩展版本利用其标签体系优化了多语言PII识别能力;学术界提出了融合上下文嵌入与对抗训练的隐私保护模型,在保留语义的同时实现精准脱敏。此外,该数据集被整合至BigScience PII标注规范中,成为跨数据集隐私标签统一化的参考标准,并催生了针对大语言模型推理时隐私泄露的评估基准,推动了安全AI系统的可信研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务