
parser_user_v17a
收藏官方服务:
资源简介:
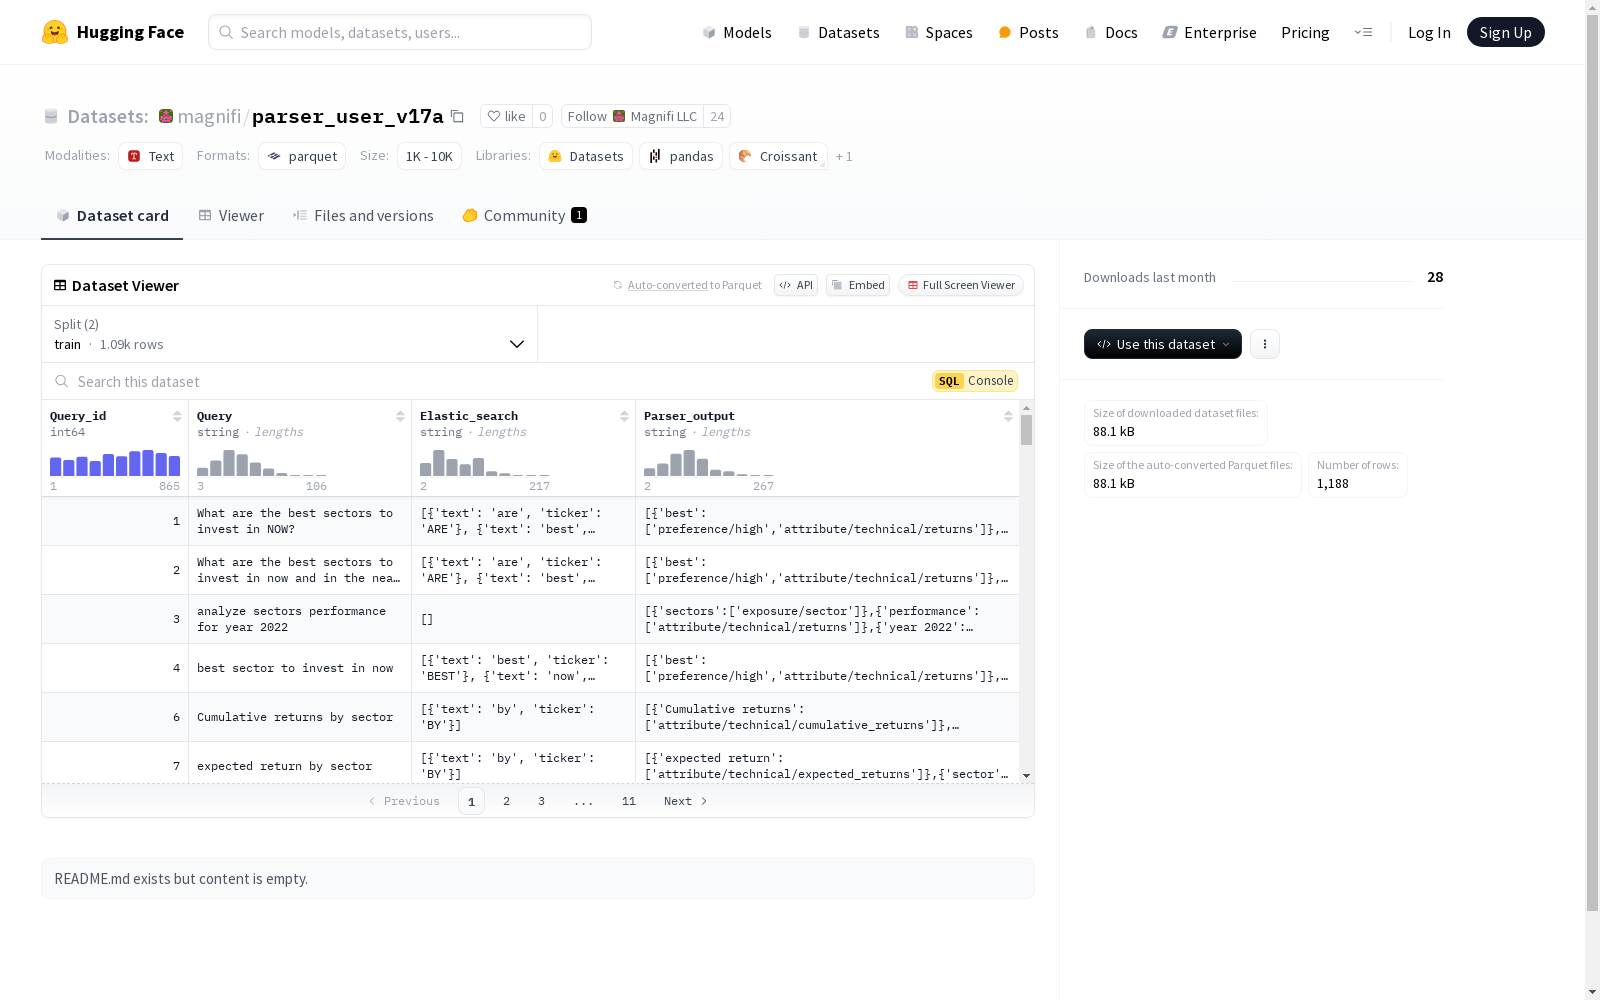
该数据集包含四个特征:Query_id(整数类型)、Query(字符串类型)、Elastic_search(字符串类型)和Parser_output(字符串类型)。数据集分为训练集和验证集,分别包含1093和95个样本。数据集的总下载大小为88121字节,总大小为247847字节。数据集配置为默认配置,训练集和验证集的数据文件分别存储在data/train-*和data/validation-*路径下。
This dataset contains four features: Query_id (of integer type), Query (of string type), Elastic_search (of string type), and Parser_output (of string type). It is divided into training and validation sets, which hold 1093 and 95 samples respectively. The total download size of the dataset is 88121 bytes, and the total size is 247847 bytes. The dataset uses the default configuration, with the data files of the training and validation sets stored under the paths data/train-* and data/validation-* respectively.
提供机构:
Magnifi LLC创建时间:
2024-08-10
原始信息汇总
数据集概述
数据集信息
-
特征列表:
Query_id:数据类型为int64Query:数据类型为stringElastic_search:数据类型为stringParser_output:数据类型为string
-
数据分割:
train:包含 1093 个样本,占用 230904 字节validation:包含 95 个样本,占用 16943 字节
-
数据集大小:
- 下载大小:88121 字节
- 数据集总大小:247847 字节
配置信息
- 默认配置:
train数据文件路径:data/train-*validation数据文件路径:data/validation-*
搜集汇总
数据集介绍
构建方式
parser_user_v17a数据集的构建基于用户查询与解析器输出的对应关系,涵盖了1093个训练样本和95个验证样本。数据通过Elasticsearch引擎进行检索,并结合解析器的输出结果,形成结构化的数据对。每个样本包含查询ID、原始查询、Elasticsearch检索结果以及解析器输出,确保了数据的多样性和实用性。
特点
该数据集的特点在于其高度结构化的数据格式,包含查询ID、查询文本、Elasticsearch检索结果和解析器输出四个关键字段。数据集的规模适中,训练集和验证集的划分合理,便于模型训练与评估。此外,数据来源真实,反映了实际应用场景中的查询与解析需求,具有较强的实用价值。
使用方法
parser_user_v17a数据集适用于自然语言处理任务中的查询解析与检索优化研究。用户可通过加载训练集和验证集,分别用于模型训练与性能验证。数据字段清晰,便于直接用于输入输出对的设计。建议结合Elasticsearch和解析器的特性,探索查询解析的准确性与效率提升方法。
背景与挑战
背景概述
parser_user_v17a数据集是一个专注于自然语言处理(NLP)领域的数据集,旨在通过解析用户查询与Elasticsearch检索结果之间的关系,提升信息检索系统的智能化水平。该数据集由一支专注于信息检索与自然语言处理的研究团队于近年创建,其核心研究问题在于如何通过解析用户查询与系统响应之间的语义关联,优化搜索引擎的查询理解与结果匹配能力。该数据集的发布为信息检索领域的研究者提供了一个新的基准,推动了基于语义理解的检索技术的发展。
当前挑战
parser_user_v17a数据集在解决信息检索领域的语义理解问题时面临多重挑战。首先,用户查询的多样性与复杂性使得解析过程难以准确捕捉其真实意图,尤其是在面对模糊或歧义查询时。其次,Elasticsearch检索结果与用户查询之间的语义匹配需要高度精确的模型支持,这对数据集的构建提出了较高的技术要求。此外,数据集的构建过程中,如何确保解析输出的准确性与一致性也是一个重要挑战,尤其是在处理大规模数据时,人工标注与自动化解析之间的平衡难以把握。
常用场景
经典使用场景
parser_user_v17a数据集在自然语言处理领域中被广泛用于解析用户查询与搜索引擎响应之间的关系。通过分析用户查询(Query)与Elasticsearch返回结果(Elastic_search)以及解析器输出(Parser_output)之间的对应关系,该数据集为研究查询解析、信息检索和语义理解提供了丰富的实验数据。研究人员可以利用该数据集训练和评估模型,以提升查询解析的准确性和效率。
实际应用
在实际应用中,parser_user_v17a数据集被广泛应用于搜索引擎优化、智能客服系统和个性化推荐系统等领域。通过分析用户查询与解析结果,企业能够优化搜索算法,提升用户体验。此外,该数据集还可用于训练智能助手,使其更准确地理解用户需求并提供精准的反馈。
衍生相关工作
基于parser_user_v17a数据集,许多经典研究工作得以展开。例如,研究人员开发了基于深度学习的查询解析模型,显著提升了语义理解的准确性。此外,该数据集还催生了多篇关于信息检索和自然语言处理的学术论文,为相关领域的技术进步提供了理论支持和实践验证。
以上内容由遇见数据集搜集并总结生成


